
画图只要描述一个瞬间,视频要描述一段时间里发生了什么:镜头怎么动、主体做了什么、氛围怎么变。前几课的六个部分依然有用,只是要再加上「动」的部分。
打开视频创作台
在 HiveGPT 无限画布 顶部导航进入「视频创作台」。输入框里的提示是:描述镜头运动、主体动作、场景氛围和画面风格。这四项就是视频提示词的骨架。
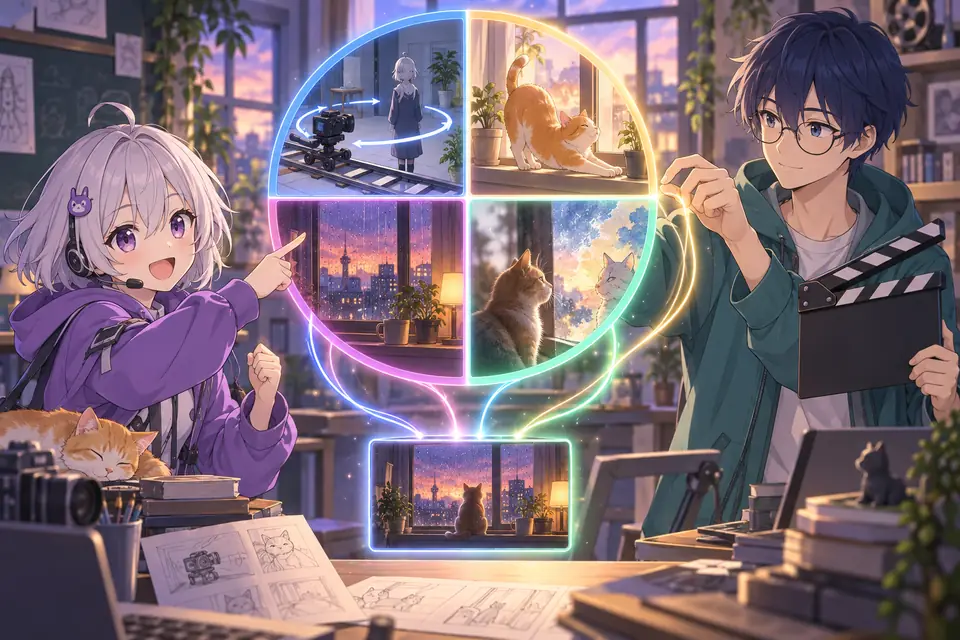
视频提示词的四个部分
| 部分 | 回答的问题 | 例子 |
|---|---|---|
| 镜头运动 | 镜头怎么动? | 镜头缓慢推近 / 从左向右平移 / 环绕主体一圈 / 固定机位 |
| 主体动作 | 谁在做什么?动作快还是慢? | 橘猫从窗台上站起来,伸了个懒腰,转头看向镜头 |
| 场景氛围 | 在哪里?天气、时间、光线? | 下雨的傍晚,室内暖黄灯光,窗外雨丝 |
| 画面风格 | 实拍还是动画?什么质感? | 电影感实拍,浅景深 / 水彩动画风格 |
连起来:
镜头从窗外缓慢推近。一只橘色短毛猫趴在窗台上,慢慢站起来伸了个懒腰,然后转头看向镜头。下雨的傍晚,室内暖黄色灯光,玻璃上的雨滴缓缓滑落。电影感实拍,浅景深,色调温暖。
几个写视频提示词的习惯:
- 一段视频只讲一件事。几秒的视频塞进三四个动作,往往哪个都做不完整。
- 动作写清楚先后:「先……然后……」比一堆并列的动词更容易被执行。
- 镜头和主体分开写:「镜头推近」和「猫走近」是两种不同的运动,别混在一起。
练习:把想法写成镜头描述
▶ 动手试试
系统提示词(这次请求一起发送,点开查看)
你是短视频提示词助手。把用户的想法改写成一段视频生成提示词:先分四行写出 镜头运动、主体动作(写清先后顺序)、场景氛围、画面风格,每行一句;最后给出一段连贯的完整中文提示词,以「完整提示词:」开头。整段只安排一到两个动作,适合几秒到十几秒的短视频。不要涉及真实人物和品牌。
登录后运行登录 HiveGPT 后每天有免费运行次数
镜头运动:固定机位特写,最后缓慢向上抬起
主体动作:热咖啡表面冒出袅袅热气,一勺牛奶倒入后慢慢晕开
场景氛围:清晨的木质桌面,窗边斜射进来的金色阳光,空气里有细小的浮尘
画面风格:电影感实拍,浅景深,暖色调
完整提示词:清晨木质桌面上的一杯热咖啡特写,固定机位,咖啡表面冒着袅袅热气,一勺牛奶倒入后慢慢晕开……
改好以后直接去视频创作台生成:
清晨木质桌面上的一杯热咖啡特写,固定机位,咖啡表面冒着袅袅热气,一勺牛奶倒入后慢慢晕开,最后镜头缓慢向上抬起。窗边斜射进来的金色阳光,空气里有细小的浮尘。电影感实拍,浅景深,暖色调。
文生视频和参考生视频
视频创作台没有单独的模式切换,加不加参考素材决定了怎么生成:
- 不加参考:只靠提示词,就是文生视频。
- 加参考素材:就是参考生视频,可以加「参考图」(最多 9 张)、「参考视频」(最多 3 个,mp4 / mov)、「参考音频」(最多 3 段,mp3 / wav,每段 2–15 秒)。
和图生图一样,提示词里要说清楚参考素材里保留什么、要发生什么变化。比如用 B3 画好的角色图当参考:「保留参考图里角色的外形和服装,让她在花田里转身回头微笑」。
视频设置
| 设置 | 选项 | 怎么选 |
|---|---|---|
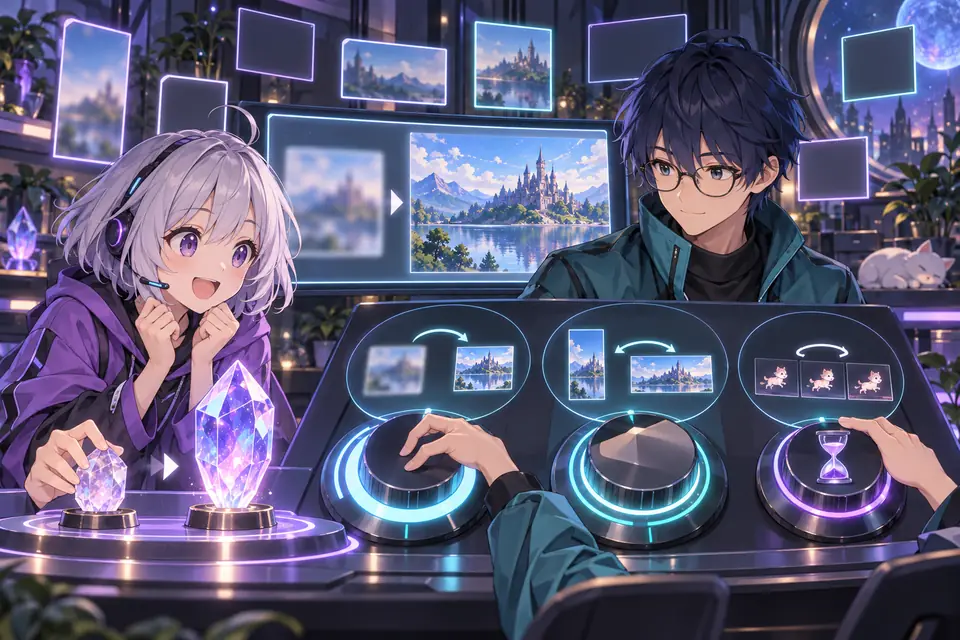
| 清晰度 | 480p / 720p / 1080p | 先用低清晰度试效果,满意了再出高清 |
| 比例 | 1:1、3:4、4:3、16:9、9:16、21:9、自适应 | 手机竖屏短视频用 9:16,横屏播放用 16:9 |
| 秒数 | 4–30 秒,默认 6 秒 | 一个动作几秒就够,别一开始就拉满 |
| 模式 | 「首尾帧模式」(默认)/「全能参考模式」 | 两种模式使用参考素材的方式不同,拿不准先用默认 |
另外还有「生成声音」和「添加水印」两个开关。默认模型是 grok-imagine-video,能选哪些其他视频模型取决于你账户的渠道。
先试短的、低清的
视频越长、清晰度越高,花费越多。先用短时长和低清晰度确认镜头和动作对了,再用同一段提示词出正式版。
内容审核同样适用
真实人物(尤其公众人物)、国旗国徽等国家标志、政治、暴力、成人内容会被拦截。被拦截的请求不扣费,换一种描述再试。
小结
- 视频提示词 = 镜头运动 + 主体动作 + 场景氛围 + 画面风格,一段只讲一件事。
- 不加参考就是文生视频,加了参考图、视频或音频就是参考生视频。
- 先用短时长、低清晰度试,满意了再出正式版。
下一课:发布作品和做同款——把满意的图和视频发到画布社区,也学学别人是怎么做的。