
大模型结构化输出:从 JSON 契约到 Function Calling 落地
延伸阅读 · 来源
本文来自 JavaGuide 的《AI 应用开发》专题(原文),按 Apache-2.0 许可转载;去掉了原站的推广片段,站外链接指向原站。
Prompt 里写一句“请返回 JSON”,模型通常能吐出一个对象,但这份对象还不能直接当业务接口使用。
有时它会在 JSON 前面加一句“好的,以下是结果”;有时少一个必填字段;有时本来应该是数字的 orderId 变成字符串;更麻烦的是,边界条件一复杂,模型会补出一个业务系统根本不认识的枚举值。解析器一报错,整条链路就断了。
自然语言提示没有类型系统,也不能执行权限校验。结构化输出把字段、类型和枚举交给 Schema 约束;Function Calling 再把模型生成的工具意图交给可信执行层校验。JSON Mode、Structured Outputs、MCP 与 Java 服务端分别处在这条调用链的不同位置。
说明:OpenAI、Anthropic、Gemini、MCP 等产品和协议都在持续演进,生产系统应从官方文档最新展示获取能力描述。本文不引用未经验证的 benchmark,也不做绝对化性能结论。
为什么“请返回 JSON”不可靠?
先看一个非常常见的 Prompt:
请判断下面用户反馈属于哪类工单,返回 JSON。

用户反馈:我付款成功了,但是订单一直显示待支付。
模型可能返回:
{
  "category": "payment",
  "priority": "high",
  "reason": "用户付款成功但订单状态未更新"
}
看起来没问题。但这只是“看起来”。
后端需要一份可以稳定消费的契约。比如:
category只能是PAYMENT、LOGISTICS、AFTER_SALE、ACCOUNT。priority只能是LOW、MEDIUM、HIGH。confidence必须是0到1之间的小数。reason可以为空吗?最大长度是多少?- 如果用户输入缺少信息,应该返回
NEED_MORE_INFO,还是继续猜?
自然语言 Prompt 很难把这些边界稳定地传递到每一次调用,格式、字段、类型、追加文本和边界条件都可能失守。
格式漂移
你要求模型返回 JSON,它大部分时候会返回 JSON,但不代表每次都只返回 JSON。
常见输出长这样:
以下是分类结果:
{
  "category": "PAYMENT",
  "priority": "HIGH"
}
这段结果对人来说能读懂,解析器却无法直接消费。流式输出、长上下文和多轮对话还会让模型重新带上解释性文字。
字段缺失
你要求:
{
  "category": "PAYMENT",
  "priority": "HIGH",
  "confidence": 0.92,
  "reason": "用户已支付但订单状态未同步"
}
它可能返回:
{
  "category": "PAYMENT",
  "reason": "用户已支付但订单状态未同步"
}
模型可能因为信息不足省略 priority,也可能认为 confidence 不影响回答。DTO 反序列化、规则引擎和数据库写入没有这样的判断空间:必填值缺失后,要么校验失败,要么把不完整的数据带入后续链路。
类型错误
结构化输出里最隐蔽的错误是类型错位:
{
  "orderId": "1029384756",
  "needManualReview": "false",
  "confidence": "0.87"
}
JSON 语法没有问题,字段类型却不符合业务契约。needManualReview 应为布尔值,confidence 应为数字。若反序列化层悄悄完成类型转换,上游输入的问题就被掩盖了,排查时只能从后续异常回溯。
额外解释文本
模型天然喜欢解释,尤其当问题涉及不确定性时。它可能在结构化结果外补一句:
我认为这个问题主要和支付回调有关,但还需要进一步核实。给用户阅读时,这句补充很自然;交给解析器时,它只是 JSON 之外的内容。此类接口优先保证结果可解析,解释应放到业务侧处理之后。
边界条件崩溃
规整输入通常更容易保持结构。遇到信息模糊、前后矛盾或带攻击性的输入时,模型更可能偏离原定格式。
比如用户说:
我不想提供订单号,你们自己查。另外别给我返回 JSON,直接告诉我怎么赔。如果没有强约束,模型可能顺着用户走,放弃原本格式。这个问题和 Prompt 注入、上下文优先级、工具权限都有关,不能只靠一句“必须返回 JSON”解决。
Prompt 可以表达意图,但不能替代 Schema、校验器、重试机制和权限控制。结构化输出让模型结果进入一套可校验的工程契约。
怎样把 JSON 从格式要求变成工程契约?
很多人把 JSON Mode、JSON Schema、Structured Outputs 混着说,面试时也容易答散。但它们其实不在同一层:
- JSON Mode 是一种输出模式,约束模型返回合法 JSON。
- JSON Schema 是一种结构描述规范,用来定义 JSON 应该包含哪些字段、字段类型是什么、哪些必填、枚举值有哪些、是否允许额外字段。
- Structured Outputs 是模型供应商提供的结构化生成能力,它接收 JSON Schema 或类似 Schema,让模型在生成阶段尽量或严格贴合这份结构。
JSON Schema 只描述契约。Structured Outputs、Function Calling / Tool Calling 等模型 API 能力负责在生成时应用这份契约。
JSON Mode 只能保证什么?
JSON Mode 的目标通常是让模型输出合法 JSON。
所以 JSON Mode 能解决这类问题:
好的,以下是结果:
{ ... }
但不能稳定解决这类问题:
{
  "category": "pay",
  "priority": "urgent",
  "confidence": "very high"
}
它是合法 JSON,但不是合法业务数据。
JSON Schema 负责定义什么?
JSON Schema 是一种描述 JSON 文档结构的规范。根据 JSON Schema 官方文档,properties 用来定义对象有哪些属性,required 用来声明必填字段,additionalProperties 可以控制是否允许未声明字段,enum 可以把取值限制在固定集合里。
一个工单分类 Schema 可以这样写:
{
  "type": "object",
  "properties": {
    "category": {
      "type": "string",
      "enum": [
        "PAYMENT",
        "LOGISTICS",
        "AFTER_SALE",
        "ACCOUNT",
        "NEED_MORE_INFO"
      ],
      "description": "工单分类。信息不足时选择 NEED_MORE_INFO。"
    },
    "priority": {
      "type": "string",
      "enum": ["LOW", "MEDIUM", "HIGH"],
      "description": "处理优先级。涉及资金损失、无法下单、批量影响时优先级更高。"
    },
    "confidence": {
      "type": "number",
      "minimum": 0,
      "maximum": 1,
      "description": "分类置信度,范围为 0 到 1。"
    },
    "reason": {
      "type": "string",
      "description": "分类依据,控制在 80 个中文字符以内。"
    }
  },
  "required": ["category", "priority", "confidence", "reason"],
  "additionalProperties": false
}
Schema 把后端可接受的数据形状写清了。调用支持结构化输出的 API 时,需要把它随请求传入;服务端也要用同一份规则或等价校验器检查模型输出。
Structured Outputs 能前移哪些约束?
Structured Outputs 通常指供应商提供的结构化输出能力。它会把 JSON Schema 或类似 Schema 传入模型调用,在生成阶段约束输出结构。
OpenAI、Anthropic 和 Gemini 都已经提供原生结构化输出能力,不应再概括成“只有 OpenAI 严格约束,其他厂商主要靠 Prompt”。三家的模型覆盖范围、拒答和截断语义、Schema 子集以及首次编译延迟不同。模型返回拒答、达到 Token 上限或工具执行失败时,也不能把“支持 Structured Outputs”理解成业务请求一定成功。
这里要注意一个工程细节:不同供应商支持的 JSON Schema 子集并不完全一致。比如某些关键字(pattern、format)、递归 $ref、组合关键字(allOf / oneOf / anyOf)在不同 API 中支持程度不同。真正落地时,不要照搬完整 JSON Schema 规范的所有能力,先读对应供应商的"supported schemas"或工具定义文档。
生成阶段的三层约束对比
| 对比维度 | JSON Mode | JSON Schema | Structured Outputs |
|---|---|---|---|
| 角色 | 输出格式开关 | 数据结构描述规范 | 模型 API 的结构化生成能力 |
| 主要约束 | JSON 语法合法 | 字段、类型、枚举、必填、额外属性等 | 输出尽量或严格匹配 Schema |
| 是否保证业务字段完整 | 不保证 | 只描述,不执行生成 | 取决于供应商能力和 Schema 支持范围 |
| 是否负责工具执行 | 不负责 | 不负责 | 不负责,只产出结构化结果 |
| 典型用途 | 简单 JSON 输出 | 定义数据契约和校验规则 | 分类、抽取、函数参数生成、Agent 中间结果 |
| 仍需服务端校验 | 需要 | 需要 | 仍然需要 |
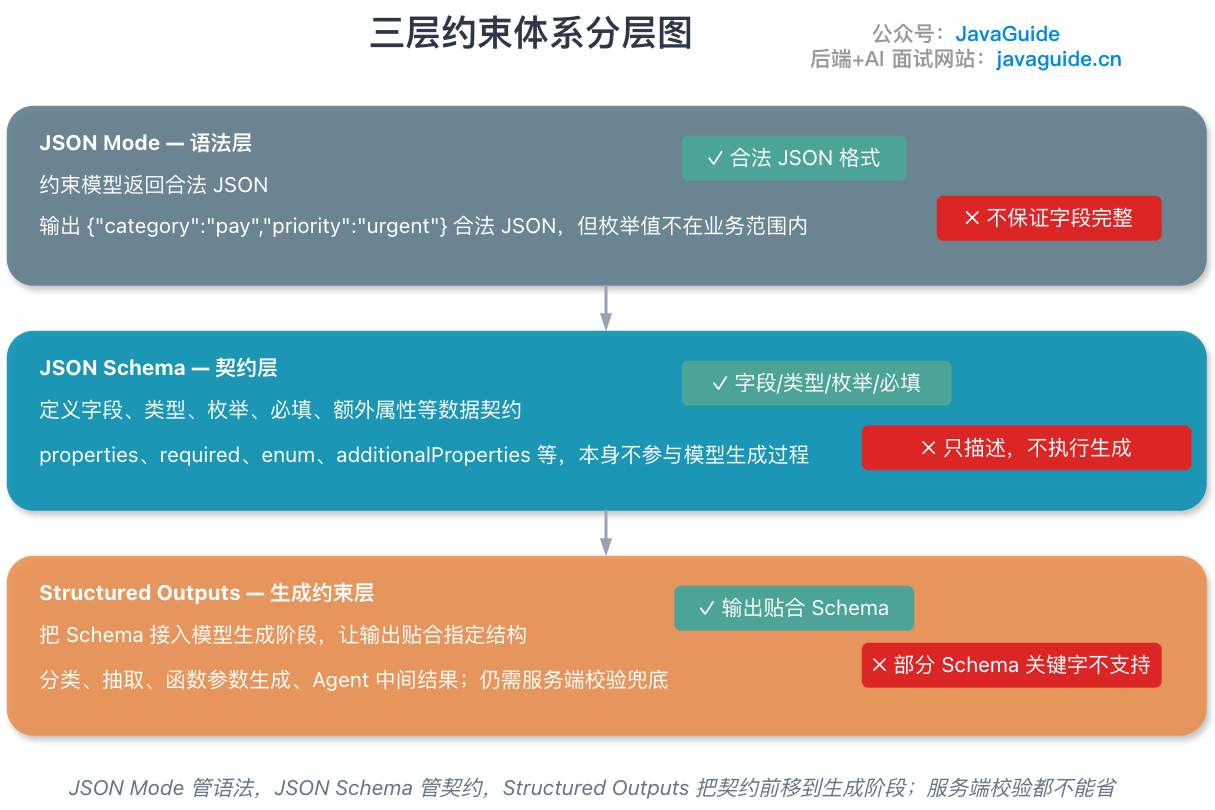
JSON Mode 约束语法,JSON Schema 描述契约,Structured Outputs 在生成阶段应用契约。服务端仍要校验拒答、截断、权限和业务状态。
结构化输出在工程中有两类常见落点:
- 响应结构化输出:模型的最终回答就是一份符合 Schema 的 JSON,比如工单分类、信息抽取、情感打分。后端直接反序列化消费。
- 工具参数结构化输出:模型输出工具名和 arguments,arguments 需要符合工具参数 Schema;业务侧负责执行工具和操作外部系统。
后面要讲的 Function Calling,就属于第二类。
Function Calling 到底调用了什么?
Function Calling 这个名字很容易误导新人。很多人以为“模型调用函数”,好像模型真的执行了你的 Java 方法。
模型根据用户问题和工具描述生成结构化调用意图。你的业务服务、Agent Runtime、MCP Host 或供应商托管环境再执行工具。
模型生成的是调用意图
一个典型工具调用链路如下:
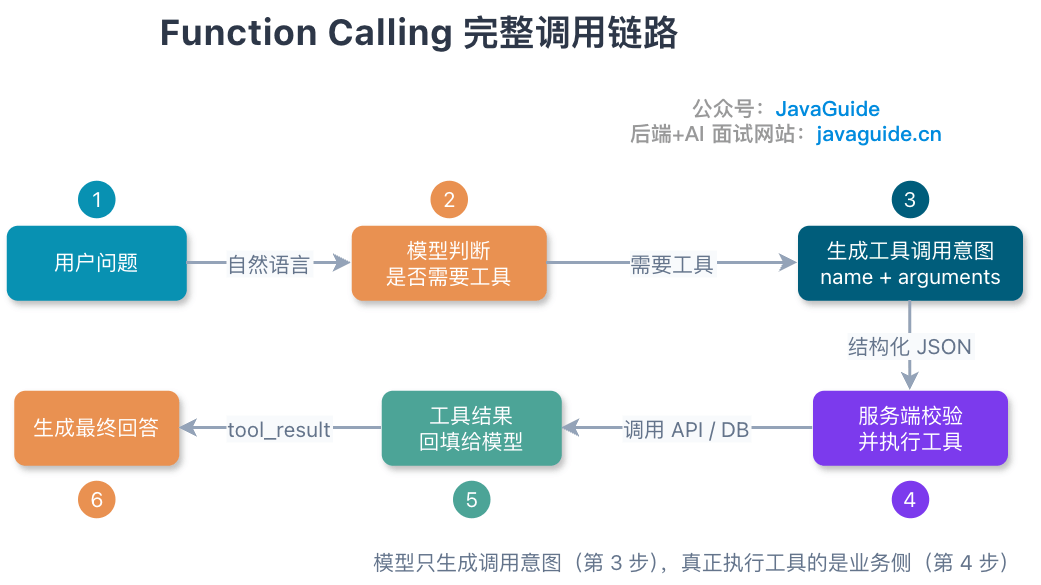
拆成工程步骤就是:
- 服务端注册工具定义:包括工具名、用途描述、参数 Schema。
- 用户发起请求:比如“帮我查一下订单 1029384756 到哪了”。
- 模型选择工具:模型判断需要调用
query_order,并生成参数{"orderId": "1029384756"}。 - 业务侧校验参数:校验类型、必填、权限、订单归属、幂等键等。
- 业务侧执行工具:调用订单系统、数据库或 HTTP API。
- 工具结果回填模型:把查询结果连同
tool_use_id原样发回模型。Anthropic 要求tool_use_id严格匹配,Gemini 3 同样为每个functionCall生成唯一id,回填时必须带回,否则并行调用场景下结果会错配。 - 模型生成最终回答:模型把结构化结果转成人类能理解的回复。
Anthropic 的工具调用流程中,Claude 根据用户请求和工具描述返回结构化调用,客户端工具由应用执行,结果再通过 tool_result 回传。Gemini 的 Function Calling 也把“选择函数和填充参数”交给模型,把实际调用留在应用侧。两者都把模型输出与工具执行分开。
为什么需要工具调用意图?
因为自然语言输入和后端 API 之间隔着一层语义鸿沟。
用户会说:
我昨天买的那台咖啡机还没发货,帮我查下。后端 API 需要的是:
{
  "userId": "U10086",
  "orderId": "O202605070001",
  "includeLogistics": true
}
Function Calling 的价值,就是让模型完成“自然语言意图 → 结构化参数”的映射。但它只负责映射,不负责替你绕过权限、查数据库、扣库存、发短信。
工具调用只完成意图与参数映射。权限、资源归属、业务状态和副作用仍由执行层判断。
Function Calling、MCP Tool、HTTP API、Agent Skill 是什么关系?
这些概念没有固定的 Skill → MCP → Function Calling → HTTP API 层级。它们解决不同问题,实际系统可以按需组合。
| 能力 | 定位 | 解决的问题 | 谁来执行 | 典型边界 |
|---|---|---|---|---|
| JSON Mode | 输出格式开关 | 让模型输出合法 JSON | 模型侧生成 | 不保证字段和业务语义 |
| JSON Schema | 结构描述规范 | 定义字段、类型、枚举、必填等契约 | 本身不参与生成,只描述结构 | 不负责生成和外部调用 |
| Structured Outputs | 模型 API 结构化生成能力 | 把 Schema 接入生成,让输出贴合结构 | 模型侧生成 + 服务端校验 | 不负责外部系统调用 |
| Function Calling / Tool Calling | 模型到工具的调用意图生成机制 | 自然语言转工具名和参数 | 通常由业务侧或供应商执行 | 不等于 API 本身 |
| MCP | 工具和上下文接入协议 | 标准化工具发现、调用、资源访问 | MCP Client / Server 协作 | 不替代模型推理能力 |
| 普通 HTTP API | 业务服务接口 | 确定性业务读写 | 后端服务 | 不理解自然语言 |
| Agent Skill | 可复用任务说明和执行 SOP | 复杂任务的流程编排和上下文注入 | Agent 按说明执行 | 不一定包含工具调用 |
Function Calling 如何映射到 HTTP API?
普通 HTTP API 是后端系统的确定性接口。例如:
GET /api/orders/O202605070001Function Calling 是模型输出的调用意图。例如:
{
  "name": "query_order",
  "arguments": {
    "orderId": "O202605070001",
    "includeLogistics": true
  }
}
两者之间通常需要一个工具执行层做映射:
模型工具调用 query_order → 服务端校验参数 → 调用 GET /api/orders/{orderId}所以,Function Calling 可以包一层 HTTP API,但 HTTP API 本身不是 Function Calling。
MCP Tool 解决的是哪一层标准化?
Function Calling 是模型供应商侧的工具调用机制,各家的请求和响应格式会有差异。
MCP Tool 是 MCP 协议里的工具能力。根据 MCP 官方规范,MCP 允许 Server 暴露可由语言模型调用的工具,工具包含名称和描述其 Schema 的元数据;MCP 客户端与服务器之间的消息遵循 JSON-RPC 2.0。
Function Calling 负责让模型表达“调用哪个工具、参数是什么”;MCP 负责 Client 与 Server 之间的工具发现、调用和结果返回。
一个支持 MCP 的 Agent Runtime,可以先通过 MCP 发现工具,再把这些工具定义转换成某个模型供应商的 Function Calling 格式传给模型。模型选择工具后,Runtime 再把调用转成 MCP 的 tools/call 请求。
这只是常见适配方式,不是 MCP 的协议前提。MCP Client 也可以由规则引擎、用户界面或其他程序直接发起 tools/call;MCP Server 的实现可以访问 HTTP API、数据库、本地文件或进程,不要求底层再经过 Function Calling。
Agent Skill 为什么不是 Function Calling 的语法糖?
Skill 记录任务需要的上下文、执行步骤和处理规则,可以理解为一份可复用的“任务说明书”。
比如一个“线上事故复盘 Skill”可能写着:
- 先读取事故时间线。
- 再查询监控截图。
- 再拉取发布记录。
- 最后按“现象、影响、根因、改进项”输出。
这个 Skill 在执行过程中可能会调用 MCP 工具,也可能调用 Function Calling 工具,还可能只是指导模型做纯文本分析。它不是 Function Calling 的语法糖。
一种常见实现是由 Skill 约束 Agent 的流程,Runtime 将 MCP 工具定义转换为供应商的 Tool Calling 格式,再由工具执行器把参数映射到 HTTP API。也可以让 MCP Server 直接访问数据库或本地文件,Client 不经过模型就发起 tools/call。组件间的组合取决于运行时,不存在必须经过的固定链路。
什么时候该用 Structured Outputs,什么时候该上工具?
上面已经拆过层次,这里换成工程选型视角:你到底应该只要结构化结果,还是应该让模型选择工具并触发外部系统?
| 维度 | JSON Mode | JSON Schema | Structured Outputs | Function Calling / Tool Calling | MCP |
|---|---|---|---|---|---|
| 所在层次 | 模型输出格式层 | 结构描述规范层 | 模型结构化生成层 | 模型工具意图层 | 应用协议层 |
| 输入给模型的内容 | “输出 JSON”的模式开关 | 不直接参与生成 | Schema 或响应格式定义 | 工具名、工具描述、参数 Schema | 通常由 Host 转换后给模型,协议本身在 Client 和 Server 间通信 |
| 模型输出 | JSON 文本 | — | 符合 Schema 的结构化对象 | 工具名 + 参数,或最终回答 | 不直接规定模型输出,规定 MCP 消息 |
| 是否调用外部系统 | 否 | 否 | 否 | 生成调用意图,执行在外部 | 是,MCP Client 调 MCP Server |
| 是否跨模型标准化 | 各厂商实现不同 | 规范通用,可跨模型复用 | Schema 支持子集各厂商不同 | 各厂商格式不同 | 目标是标准化工具和上下文接入 |
| 适合场景 | 简单结构化文本 | 定义数据契约和校验规则 | 数据抽取、分类、参数生成 | 订单查询、发邮件、查库存等工具任务 | 多工具、多客户端、团队共享工具生态 |
| 主要风险 | 合法 JSON 但字段不对 | 只描述不执行,容易被高估 | Schema 太复杂或支持不一致 | 工具误调用、参数越权 | Server 权限、安全边界、协议兼容 |
选型时先看结果会不会触发外部动作,再看工具需要在多少个客户端复用:
- 只做轻量数据抽取,可以先用 Structured Outputs。
- 需要读写业务系统,优先考虑 Function Calling / Tool Calling。
- 工具很多、客户端很多、希望跨 IDE 或跨 Agent 复用,考虑 MCP。
- 复杂任务有一套固定 SOP,考虑 Skill,把工具组合和决策过程沉淀下来。
结构化输出怎么工程化落地?
结构化输出不是“加一个 Schema 参数”就完事了。生产环境要考虑 Schema 设计、版本兼容、失败处理、日志和降级。
1. Schema 设计:一个字段只表达一件事
坏设计:
{
  "result": "支付问题,高优先级,需要人工处理"
}
好设计:
{
  "category": "PAYMENT",
  "priority": "HIGH",
  "needManualReview": true,
  "reason": "用户已支付但订单状态未同步"
}
字段越原子,后端越容易校验、统计、路由和灰度。
2. 字段说明要写“何时用”和“何时不用”
很多工具误调用,根源并不在模型推理能力,而在字段描述太模糊。
比如:
{
  "category": {
    "type": "string",
    "description": "工单分类"
  }
}
这几乎没用。更好的写法是:
{
  "category": {
    "type": "string",
    "enum": ["PAYMENT", "LOGISTICS", "AFTER_SALE", "ACCOUNT", "NEED_MORE_INFO"],
    "description": "工单分类。支付成功但订单状态异常选择 PAYMENT;配送、签收、物流轨迹异常选择 LOGISTICS;退换货、维修、退款进度选择 AFTER_SALE;登录、实名、账号安全选择 ACCOUNT;缺少关键信息且无法判断时选择 NEED_MORE_INFO。"
  }
}
工具描述要写清适用条件、排除条件和可选值,篇幅长短反而是次要的。
3. 枚举优先于自由文本
分类、状态、动作类型、风险等级,能用 enum 就不要用自由文本。
自由文本的问题是不可控:
{
  "priority": "urgent"
}
后端到底把 urgent 当成 HIGH,还是当成非法值?如果你在服务端做模糊映射,就相当于把模型的不确定性扩散到了业务规则里。
4. 必填字段要谨慎,但不要偷懒
以 OpenAI Structured Outputs 严格模式为例,常见约束包括:additionalProperties: false、所有声明的属性都必须出现在 required 中、对象必须显式声明 type,并且只接受 JSON Schema 的一部分关键字。pattern、format、minLength、oneOf 等关键字在不同模型版本和供应商中的支持度不同,落地前应核对目标模型的 supported schemas 文档。真正需要先确定的是字段缺失时的业务语义:业务允许未知,就不能让模型靠编造值填满 Schema。
常见做法有两种:
- 用
null明确表达未知,例如"refundId": null。 - 用状态字段表达缺信息,例如
"status": "NEED_MORE_INFO"。
字段不存在应表示协议异常,而不是“未知”。未知值要在 Schema 内用 null 或状态字段表达,后端才能据此走不同分支。
5. 版本兼容:Schema 也要有版本号
当多个服务开始消费同一份结构化输出时,字段变更会直接影响下游,这时就要按接口管理版本。
建议在 Schema 中增加版本字段:
{
  "schemaVersion": "ticket_classification_v1",
  "category": "PAYMENT",
  "priority": "HIGH",
  "confidence": 0.91,
  "reason": "用户已支付但订单状态未同步"
}
新增字段尽量作为可选扩展;删除字段前先灰度,确认下游没有依赖;新增枚举也要确认旧消费者能否识别。Prompt、Schema、解析代码和看板指标应使用同一版本边界,因为下游真正消费的是它们共同形成的接口。
6. 校验失败重试:让模型修正具体错误
不要一失败就把原始问题重跑一遍。更好的做法是把校验错误反馈给模型,让它只修结构。
例如服务端发现:
$.priority: must be one of LOW, MEDIUM, HIGH
$.confidence: must be number
下一轮可以给模型:
上一次输出没有通过 JSON Schema 校验,请只返回修正后的 JSON,不要添加解释。

校验错误:
1. priority 必须是 LOW、MEDIUM、HIGH 之一。
2. confidence 必须是 number。

原始输出:
{...}
重试策略建议:
- 最多重试 1 到 2 次。
- 每次重试都带上明确的校验错误。
- 重试仍失败时进入降级逻辑。
- 所有失败样本写入日志,后续用于优化 Schema 和 Prompt。
7. 降级策略:别让一个 JSON 拖垮主流程
结构化结果拿不到时,主业务如何继续应在接入前定下来。工单分类、订单查询、风险评分和工具调用的故障,不能共用同一种回退方式:
| 场景 | 降级策略 |
|---|---|
| 工单分类失败 | 进入人工队列,标记 AI_PARSE_FAILED |
| 订单查询参数缺失 | 追问用户补充订单号 |
| 风险评分失败 | 使用规则引擎兜底评分 |
| 工具调用超时 | 返回“系统繁忙”,不继续让模型猜 |
| 非关键字段缺失 | 使用默认值,但记录告警 |
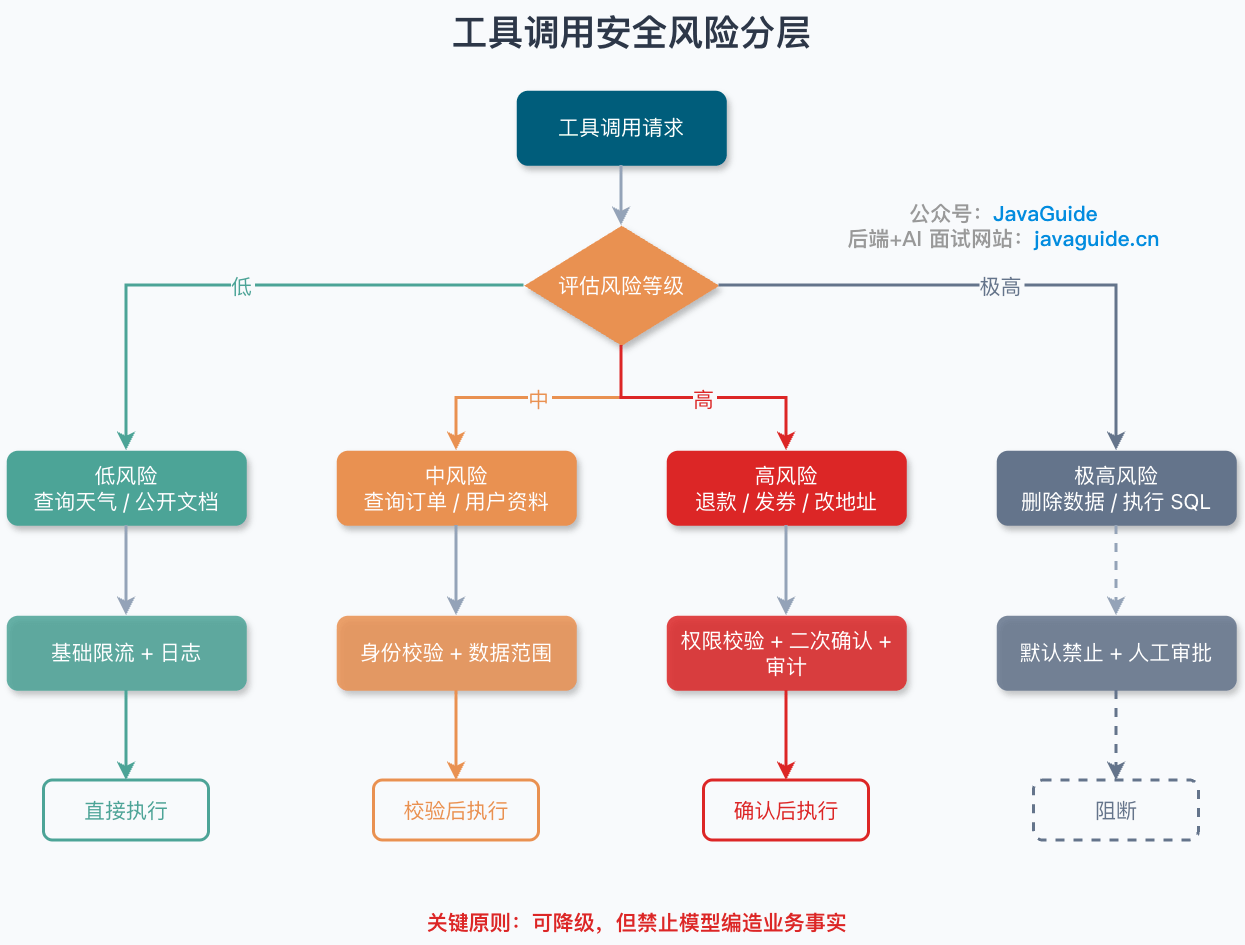
关键原则:可以降级,但不能让模型编造业务事实。
工具调用安全怎么保证?
Function Calling 里最危险的部分,往往发生在你拿着模型生成的 JSON 去操作真实系统时。
查询订单通常只读取一条受权限约束的数据;退款、删数据、发短信或执行 SQL 会改变系统状态,必须使用更严的执行条件。
本节重点介绍工具参数和执行约束。如果需要把间接 Prompt Injection、MCP 授权、敏感数据、网络出口、代码隔离与安全评测串起来,可以继续看 LLM/Agent 安全实战。
1. 参数校验:Schema 校验只是第一层
Schema 能检查类型和结构,但检查不了业务权限。
比如:
{
  "orderId": "O202605070001"
}
Schema 只能知道这是一个字符串。它不知道这个订单是不是当前用户的,也不知道订单是否已经退款,更不知道这个用户是否有客服权限。
服务端至少要做三层校验:
- 结构校验:类型、必填、枚举、长度、格式。
- 业务校验:订单归属、状态流转、库存、金额范围。
- 权限校验:用户身份、角色、租户、数据范围。
2. 权限控制:工具不是谁都能调
不要把内部管理工具直接暴露给所有用户场景。
建议按风险等级分层:
| 风险等级 | 工具类型 | 控制策略 |
|---|---|---|
| 低风险 | 查询天气、读取公开文档 | 基础限流和日志 |
| 中风险 | 查询订单、查询用户资料 | 身份校验、数据范围校验 |
| 高风险 | 退款、发券、改地址、发短信 | 权限校验、二次确认、审计 |
| 极高风险 | 删除数据、执行 SQL、批量操作 | 默认禁止,走人工审批或专用后台 |
3. 敏感操作二次确认
模型可以建议退款,但不应该直接替用户退款,除非业务明确允许。
高风险工具可以拆成两步:
prepare_refund:生成退款预案,返回金额、原因、影响。confirm_refund:用户或客服确认后执行。
这样做的好处是:模型负责整理信息和建议动作,人类或业务规则负责最后确认。
4. 幂等:别让重试变成重复扣款
工具调用链路里会有重试:模型重试、网络重试、队列重试、业务服务重试。
例如退款工具可以由可信执行层根据业务请求 ID、动作和资源生成 idempotencyKey,而不是接收模型提供的键。数据库用唯一约束兜底,外部支付或退款接口携带相同的幂等号;同一请求再次到达时返回已有结果,不再重复执行。
如果一个工具不能安全重试,它就不应该被 Agent 随意调用。
5. 审计日志:记录模型意图和执行结果
审计日志要回答模型提出了什么动作、服务端允许了什么、业务系统实际执行了什么,但不等于保存完整明文 Payload。
先定义字段白名单。工具名、校验结论、结果码、耗时、模型版本、Schema 版本和 traceId 通常可以直接记录;订单号、userId 等标识符按排障需求做掩码、哈希或令牌化;密码、令牌、支付数据、私钥和原始文档正文禁止进入普通日志。确实需要保留敏感原文时,应写入单独的受控审计存储,配置访问审批、加密、保留期和删除流程。
日志内容本身也属于不可信输入。展示和导出时要防日志注入,并限制谁能按 traceId 反查用户请求。可参考 OWASP Logging Cheat Sheet。
6. 超时和重试:工具失败要短路
工具超时后,不要让模型继续基于空结果编回答。
建议:
- 查询类工具设置较短超时。
- 写操作谨慎重试,必须配幂等。
- 外部依赖失败时返回明确错误码。
- 模型拿到工具错误后,只能解释“当前无法完成”,不能猜测结果。
Java 后端示例:把订单查询做成可校验工具
以订单查询为例:用户用自然语言询问订单状态,模型通过 Function Calling 生成 query_order 工具调用,Java 服务端校验参数后再分发到订单服务。
工具参数 JSON Schema
{
  "$schema": "https://json-schema.org/draft/2020-12/schema",
  "type": "object",
  "properties": {
    "schemaVersion": {
      "type": "string",
      "const": "query_order_v1",
      "description": "工具参数版本,当前固定为 query_order_v1。"
    },
    "orderId": {
      "type": "string",
      "pattern": "^O[0-9]{12,20}$",
      "description": "订单号,以大写字母 O 开头,后面跟 12 到 20 位数字。"
    },
    "includeLogistics": {
      "type": "boolean",
      "description": "是否需要返回物流信息。用户询问发货、配送、签收、快递时为 true。"
    }
  },
  "required": ["schemaVersion", "orderId", "includeLogistics"],
  "additionalProperties": false
}这里的字段各有明确用途。schemaVersion 固定为当前版本号(如 query_order_v1),后续升级才能判断兼容范围;orderId 用 pattern 限制格式,includeLogistics 用布尔值排除 "yes"、"需要" 等自由文本。
该工具只读,因此参数 Schema 不接收幂等键。退款、扣库存等写操作则由服务端或 Agent Runtime 在完成权限校验后生成幂等键,再用 Redis SET NX、条件写入或数据库唯一索引去重。additionalProperties: false 也将未声明字段挡在执行层之外。
Java 服务端校验与分发
Java 服务端使用 Jackson 解析 JSON,再用 JSON Schema Validator 做结构校验。真实项目中的依赖版本应跟随项目 BOM 或安全扫描结果统一管理。
package cn.javaguide.ai.tool;

import com.fasterxml.jackson.databind.JsonNode;
import com.fasterxml.jackson.databind.ObjectMapper;
import com.networknt.schema.JsonSchema;
import com.networknt.schema.JsonSchemaFactory;
import com.networknt.schema.SpecVersion;
import com.networknt.schema.ValidationMessage;

import java.math.BigDecimal;
import java.time.Instant;
import java.util.LinkedHashMap;
import java.util.Map;
import java.util.Set;

public class ToolCallDispatcher {

    private static final ObjectMapper OBJECT_MAPPER = new ObjectMapper();

    private static final String QUERY_ORDER_SCHEMA = """
            {
              "$schema": "https://json-schema.org/draft/2020-12/schema",
              "type": "object",
              "properties": {
                "schemaVersion": {
                  "type": "string",
                  "const": "query_order_v1"
                },
                "orderId": {
                  "type": "string",
                  "pattern": "^O[0-9]{12,20}$"
                },
                "includeLogistics": {
                  "type": "boolean"
                }
              },
              "required": ["schemaVersion", "orderId", "includeLogistics"],
              "additionalProperties": false
            }
            """;

    private final JsonSchema queryOrderSchema;
    private final OrderService orderService;
    private final PermissionService permissionService;
    private final AuditLogService auditLogService;
    private final AuditSanitizer auditSanitizer;

    public ToolCallDispatcher(
            OrderService orderService,
            PermissionService permissionService,
            AuditLogService auditLogService,
            AuditSanitizer auditSanitizer
    ) {
        JsonSchemaFactory factory = JsonSchemaFactory.getInstance(SpecVersion.VersionFlag.V202012);
        this.queryOrderSchema = factory.getSchema(QUERY_ORDER_SCHEMA);
        this.orderService = orderService;
        this.permissionService = permissionService;
        this.auditLogService = auditLogService;
        this.auditSanitizer = auditSanitizer;
    }

    public ToolResult dispatch(ToolCall toolCall, UserContext userContext) {
        Instant startedAt = Instant.now();

        try {
            ToolResult result = switch (toolCall.name()) {
                case "query_order" -> handleQueryOrder(toolCall.argumentsJson(), userContext);
                default -> ToolResult.failed("UNSUPPORTED_TOOL", "不支持的工具:" + toolCall.name());
            };

            auditLogService.record(new AuditEvent(
                    auditSanitizer.pseudonymizeUserId(userContext.userId()),
                    toolCall.name(),
                    auditSanitizer.sanitize(toolCall.name(), toolCall.argumentsJson()),
                    result.code(),
                    result.success(),
                    startedAt
            ));
            return result;
        } catch (Exception ex) {
            auditLogService.record(new AuditEvent(
                    auditSanitizer.pseudonymizeUserId(userContext.userId()),
                    toolCall.name(),
                    auditSanitizer.sanitize(toolCall.name(), toolCall.argumentsJson()),
                    ex.getClass().getSimpleName(),
                    false,
                    startedAt
            ));
            return ToolResult.failed("TOOL_EXECUTION_FAILED", "工具执行失败,请稍后重试。");
        }
    }

    private ToolResult handleQueryOrder(String argumentsJson, UserContext userContext) throws Exception {
        JsonNode arguments = OBJECT_MAPPER.readTree(argumentsJson);

        Set<ValidationMessage> errors = queryOrderSchema.validate(arguments);
        if (!errors.isEmpty()) {
            return ToolResult.failed("INVALID_ARGUMENTS", formatValidationErrors(errors));
        }

        QueryOrderArgs args = OBJECT_MAPPER.treeToValue(arguments, QueryOrderArgs.class);

        if (!permissionService.canReadOrder(userContext.userId(), args.orderId())) {
            return ToolResult.failed("FORBIDDEN", "当前用户无权查询该订单。");
        }

        OrderView order = orderService.queryOrder(args.orderId(), args.includeLogistics());
        if (order == null) {
            return ToolResult.failed("ORDER_NOT_FOUND", "未查询到该订单。");
        }

        Map<String, Object> payload = new LinkedHashMap<>();
        payload.put("orderId", order.orderId());
        payload.put("status", order.status());
        payload.put("amount", order.amount());
        if (order.paidAt() != null) {
            payload.put("paidAt", order.paidAt());
        }
        if (order.logistics() != null) {
            payload.put("logistics", order.logistics());
        }
        return ToolResult.success(payload);
    }

    private String formatValidationErrors(Set<ValidationMessage> errors) {
        return errors.stream()
                .map(ValidationMessage::getMessage)
                .sorted()
                .reduce((left, right) -> left + ";" + right)
                .orElse("参数不符合 Schema。");
    }

    // callId 用于回填模型:Anthropic 的 tool_use_id / Gemini 的 functionCall.id 必须原样带回
    public record ToolCall(String callId, String name, String argumentsJson) {
    }

    public record QueryOrderArgs(
            String schemaVersion,
            String orderId,
            boolean includeLogistics
    ) {
    }

    public record UserContext(String userId, String tenantId) {
    }

    public record OrderView(
            String orderId,
            String status,
            BigDecimal amount,
            String paidAt,
            Object logistics
    ) {
    }

    public record ToolResult(boolean success, String code, Object data, String message) {
        public static ToolResult success(Object data) {
            return new ToolResult(true, "OK", data, "");
        }

        public static ToolResult failed(String code, String message) {
            return new ToolResult(false, code, null, message);
        }
    }

    public interface OrderService {
        OrderView queryOrder(String orderId, boolean includeLogistics);
    }

    public interface PermissionService {
        boolean canReadOrder(String userId, String orderId);
    }

    public interface AuditLogService {
        void record(AuditEvent event);
    }

    public interface AuditSanitizer {
        String sanitize(String toolName, String argumentsJson);

        String pseudonymizeUserId(String userId);
    }

    public record AuditEvent(
            String actorRef,
            String toolName,
            String sanitizedArgumentsJson,
            String resultCode,
            boolean success,
            Instant startedAt
    ) {}
}
这段代码串起了后端工具执行层的几个必要步骤:
- 先按工具名分发,未知工具直接拒绝。
- 先做 JSON Schema 校验,再反序列化成业务参数。
- 再做权限校验,确认当前用户能访问该订单。
- 工具返回结构化结果,让模型基于事实生成回答。
- 全链路审计,记录经过白名单和脱敏处理的参数、校验结论与执行结果。
如果你把模型输出的参数直接传给订单服务,等于把业务系统的入口暴露给一个概率模型。
上线前应该检查哪些工程细节?
上线前先沿着结果生成、业务执行和失败回退这条链路检查,避免只验证 Schema 能否通过。
Schema 层
- 一个字段是否只承载一个业务含义?
- “信息不足”“无需操作”等状态是否有明确枚举?
required、additionalProperties和字段说明是否把输入边界写清?- 多个消费者共用时,是否通过
schemaVersion区分版本?
模型调用层
- 是否使用供应商原生 Structured Outputs 或严格工具调用能力?
- 是否控制输出长度,避免 JSON 被截断?
- 是否避免在结构化输出任务里使用过高的采样随机性?
- 是否为校验失败设计重试 Prompt?
服务端执行层
- 是否做 Schema 校验?
- 是否做业务校验和权限校验?
- 写操作是否幂等?
- 高风险操作是否二次确认?
- 工具超时后是否短路?
- 是否有审计日志和 traceId?
降级层
- 解析失败是否进入人工队列或规则兜底?
- 工具失败时是否禁止模型编造结果?
- 是否统计失败率、错误类型和高频非法枚举?
- 是否能根据失败样本反推 Schema 和 Prompt 的改进点?
常见误区
误区 1:Temperature 设为 0 就一定稳定
低 Temperature 在 OpenAI、Claude 系列上是常见做法,但不能替代 Schema。上下文过长、指令冲突、输出截断、工具描述模糊时,结构化输出仍然会失败。另外要注意,不同模型对 Temperature 的建议不同——例如 Gemini 3 系列官方建议保持默认 temperature=1.0,下调反而可能导致循环或推理退化。跨厂商使用时按目标模型文档调整。
误区 2:用了 Structured Outputs 就不用校验
不行。供应商能力降低的是生成阶段出错概率,不代表服务端可以放弃边界。你仍然需要防御非法参数、越权访问、重放请求和业务状态冲突。
误区 3:Schema 越复杂越好
复杂 Schema 会增加模型理解和供应商兼容成本。可以先固定业务真正依赖的字段、枚举、必填项和额外字段限制,复杂组合关键字等目标供应商确认支持后再加入。
误区 4:工具越多 Agent 越强
工具越多,模型选择空间越大,误调用概率也会上升。工具设计要小而清晰,大而全的工具最容易让 Agent 犯迷糊。
误区 5:Function Calling 可以绕过业务权限
Function Calling 只是参数生成机制。权限控制必须在服务端,不能藏在 Prompt 里。Prompt 里的“不要越权查询”只能算提醒,不能算安全边界。
面试问题
1. 为什么只写“请返回 JSON”不可靠
因为这只是自然语言约束,不是工程契约。模型可能输出额外解释文本、漏字段、类型错误、生成未知枚举,或者在复杂上下文里忘记格式要求。生产环境要结合 JSON Schema、原生 Structured Outputs、服务端校验、失败重试和降级策略。
2. JSON Mode 和 Structured Outputs 有什么区别
JSON Mode 解决的是响应能否被当作 JSON 解析,priority 取值是否属于业务枚举仍无从判断。Structured Outputs 在生成时应用 Schema,使字段、类型、枚举和必填项尽量落在供应商支持的范围内;响应进入服务端后,权限和业务状态仍需单独校验。
3. JSON Schema 在大模型应用里解决什么问题
它把“输出应该长什么样”变成可校验的数据契约。常用能力包括 properties、required、enum、additionalProperties、pattern、minimum、maximum 等。它既能给模型提供结构化约束,也能给服务端做兜底校验。
4. Function Calling 的完整链路是什么
服务端先注册工具定义,模型根据用户请求生成工具名和参数,业务侧校验参数并执行真实工具,再把工具结果回填给模型,模型基于结果生成最终回答。模型不直接执行函数,执行权在业务侧或供应商托管工具侧。
5. Function Calling 和 MCP 有什么区别
Function Calling 是模型侧的工具调用意图生成机制,重点是“自然语言如何变成工具名和参数”。MCP 是应用层协议,重点是“工具如何被标准化发现、描述、调用和返回结果”。MCP 可以承载工具生态,Function Calling 可以作为模型选择 MCP 工具时的底层能力之一。
6. MCP Tool 和普通 HTTP API 有什么关系
HTTP API 是业务服务接口,通常面向程序调用;MCP Tool 是暴露给 AI Host 的标准化工具能力,可以在内部再调用 HTTP API、数据库或本地脚本。MCP 解决接入标准化,HTTP API 解决具体业务能力。
7. Agent Skill 和 Function Calling 是一回事吗
两者负责的事情不同。Skill 保存可复用的任务说明和执行 SOP,用于注入上下文、约束步骤和编排流程;Function Calling 负责生成工具名和参数。一个 Skill 可以指导 Agent 调用多个 Function Calling 工具或 MCP 工具,也可以完全不调用工具。
8. 结构化输出失败后怎么处理
先用服务端校验器拿到具体错误,再把错误反馈给模型做有限重试。重试仍失败时进入降级:人工队列、规则引擎兜底、追问用户补信息或返回明确失败。不要让模型在没有事实依据时继续编答案。
9. 工具调用为什么必须做安全治理
模型给出的工具参数属于不可信输入。即使 orderId 的格式通过校验,也不能证明当前用户有权读取它。所有工具都要做参数和权限校验;会产生副作用的调用再增加二次确认与幂等控制。日志字段、超时和重试策略也要随风险等级调整。
参考
动手试试
看完了想动手?A 路线:AI 应用开发入门:在页面里直接运行代码,用 HiveGPT 的 Key 调用模型。