
GPT 看图识图 API
一句话: 把图片放进消息的 content 里,和文字问题一起发过去就行。Chat Completions 用 {"type": "image_url", "image_url": {"url": ...}},url 可以是网上的图片链接,也可以是本地图片转成的 data:image/png;base64,...。gpt-6.1-sol、gpt-6-luna、gpt-5.5 等模型都能看图。
更新于 2026-10,本页示例都在 HiveGPT 上实际跑过。
识别一张本地图片
import base64, os
from openai import OpenAI

client = OpenAI(base_url="https://hivegpt.cn/v1", api_key=os.environ["HIVEGPT_API_KEY"])

def image_url(path):
    """本地图片转成 data URL。"""
    ext = path.rsplit(".", 1)[-1].lower().replace("jpg", "jpeg")
    with open(path, "rb") as f:
        return f"data:image/{ext};base64," + base64.b64encode(f.read()).decode()

resp = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[{
        "role": "user",
        "content": [
            {"type": "text", "text": "图里是什么?书的封面上写了什么?"},
            {"type": "image_url", "image_url": {"url": image_url("cat.png")}},
        ],
    }],
)
print(resp.choices[0].message.content)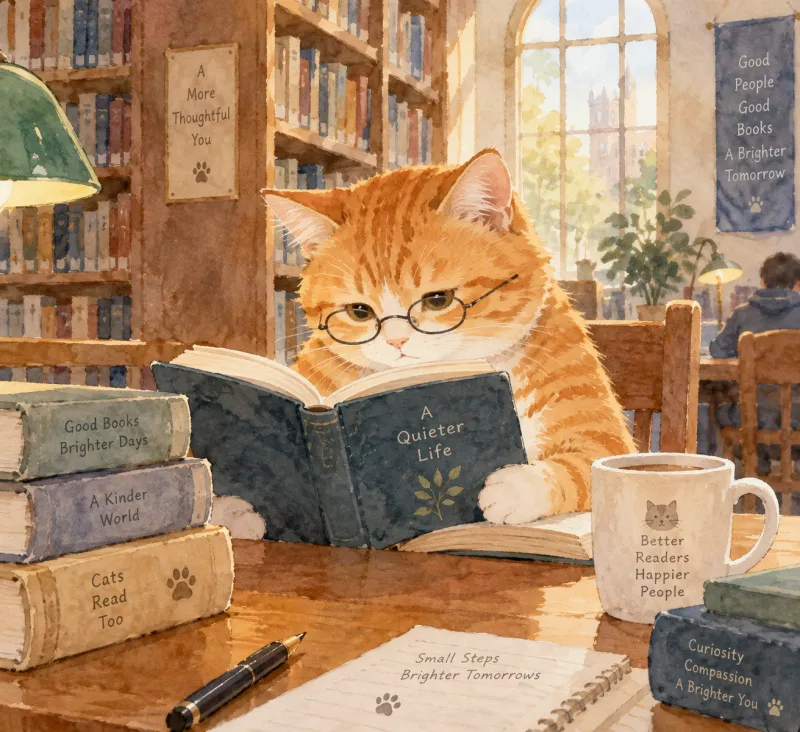
用上面这张图实测,回答是:图中是一只戴着眼镜的橘猫,正坐在图书馆里看书,书封面写着 “A Quieter Life”。连书上的英文小字都认出来了。
直接传图片链接
图片已经在网上,就不用转 base64,直接给链接:
{"type": "image_url", "image_url": {"url": "https://example.com/photo.jpg"}}链接要能被公网直接访问(不需要登录、没有防盗链)。内网地址、需要登录的网盘链接都读不到,这种情况先下载再转 base64。
一次发多张图
content 里放多个 image_url 即可,在文字里说清楚哪张是哪张:
content = [
    {"type": "text", "text": "第一张是设计稿,第二张是实际页面截图,找出两者不一致的地方"},
    {"type": "image_url", "image_url": {"url": image_url("design.png")}},
    {"type": "image_url", "image_url": {"url": image_url("screenshot.png")}},
]
提取文字(OCR)和表格
截图、扫描件、照片里的文字都能提取。要拿去程序里用的,让它直接返回 JSON:
import json

resp = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[{
        "role": "user",
        "content": [
            {"type": "text", "text": "提取这张发票的信息"},
            {"type": "image_url", "image_url": {"url": image_url("invoice.jpg")}},
        ],
    }],
    response_format={"type": "json_schema", "json_schema": {
        "name": "invoice",
        "strict": True,
        "schema": {
            "type": "object",
            "properties": {
                "seller": {"type": "string"},
                "date": {"type": "string", "description": "YYYY-MM-DD"},
                "total": {"type": "number"},
                "items": {"type": "array", "items": {
                    "type": "object",
                    "properties": {"name": {"type": "string"}, "amount": {"type": "number"}},
                    "required": ["name", "amount"],
                    "additionalProperties": False,
                }},
            },
            "required": ["seller", "date", "total", "items"],
            "additionalProperties": False,
        },
    }},
)
print(json.loads(resp.choices[0].message.content))
几个经验:
- 只要原文的话,在提示词里写「逐字提取,不要改写、不要总结」,否则模型可能顺手帮你润色。
- 表格要求「输出 Markdown 表格」或按上面的写法返回 JSON,比让它自由发挥稳定。
- 金额、身份证号、合同条款等重要信息,模型可能认错,要人工核对。
- 图片太糊、太小,认错的概率会明显变大。手机拍照尽量正对、光线均匀。
读 PDF
PDF 可以整个文件发过去,不用先转成图片:
with open("report.pdf", "rb") as f:
    pdf = base64.b64encode(f.read()).decode()

resp = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[{
        "role": "user",
        "content": [
            {"type": "file", "file": {"filename": "report.pdf", "file_data": "data:application/pdf;base64," + pdf}},
            {"type": "text", "text": "哪个区增长最快?"},
        ],
    }],
)
print(resp.choices[0].message.content)
页数多的 PDF token 也多。只关心其中几页的话,先把那几页拆出来再发,省钱也更准。
Responses 接口的写法
用 Responses API 时,类型名不一样:图片是 input_image,文件是 input_file,文字是 input_text:
resp = client.responses.create(
    model="gpt-6.1-sol",
    input=[{
        "role": "user",
        "content": [
            {"type": "input_text", "text": "图里是什么?"},
            {"type": "input_image", "image_url": image_url("cat.png")},
            # PDF:{"type": "input_file", "filename": "report.pdf", "file_data": "data:application/pdf;base64,..."}
        ],
    }],
)
print(resp.output_text)
一张图多少钱
图片会换算成输入 token 计费。实测一张 400 像素宽的图大约 4500 个输入 token,一页简单的 PDF 也差不多。按 模型怎么选 里的价格算:
| 模型 | 一张图约 |
|---|---|
gpt-6-luna | $0.0005 |
gpt-6.1-sol | $0.009 |
gpt-5.5 | $0.023 |
批量识别几百上千张图时,先用 gpt-6-luna 试几张,准确率够就用它。多轮对话里图片会跟着历史记录重复发送,每轮都计费,问完图片相关的问题最好开新对话。
常见问题
| 现象 | 原因 | 处理 |
|---|---|---|
| 回答「我看不到图片」或答非所问 | 图片没放进 content 数组,或写成了字符串 | 按上面的格式,content 是列表,图片是单独一项 |
| 400,提到 image_url / invalid image | base64 前面少了 data:image/png;base64,,或图片格式不支持 | 补上前缀;用 png、jpeg、webp、非动图的 gif |
| 链接图片读取失败 | 链接需要登录、有防盗链,或是内网地址 | 下载后转 base64 再发 |
| 413:请求内容太大 | 图片或 PDF 太大 | 压缩图片(长边 2000 像素以内足够)、拆分 PDF |
| 文字认错、漏字 | 图片模糊或字太小 | 换清晰的图,或把要识别的区域裁出来放大 |
| 费用比预期高 | 多轮对话重复带着图片 | 问完开新对话;批量任务每张图单独请求 |
能识别手写字吗? 能,字迹清楚的话准确率不错,潦草的手写容易认错,要人工检查。
能用在 Cherry Studio、Chatbox 这些客户端里吗? 能,直接在对话框里粘贴或上传图片,选一个支持看图的模型(如 gpt-6.1-sol)即可。
更多:Responses API 教程 · Python 完整示例 · 批量处理 Excel · 报错速查