
踩坑实验室 #05:1 秒的窗口,结果晚了 20 秒才出来
Apache Flink 源码学习
作者 X老师(DaemonforY),Flink 2.3.0 源码,按 CC BY-NC-SA 4.0 发布。
基于 Flink 2.3.0 本机实测(核对日期 2026-10-02)。对应课程:第七讲(上)第四节“Watermark 也是一条数据”、第四讲第八节“Buffer Debloating”。配套示例:
flink-notes/demos/src/main/java/study/time/BackpressureWindowDemo.java
现象
1 秒的滚动窗口,正常情况下窗口结束后零点几秒就出结果。可一旦下游有个算子变慢,窗口结果就开始一路落后,最后稳定在晚 20 秒左右。实时报表总是落后几十秒,问题未必出在窗口本身。
复现
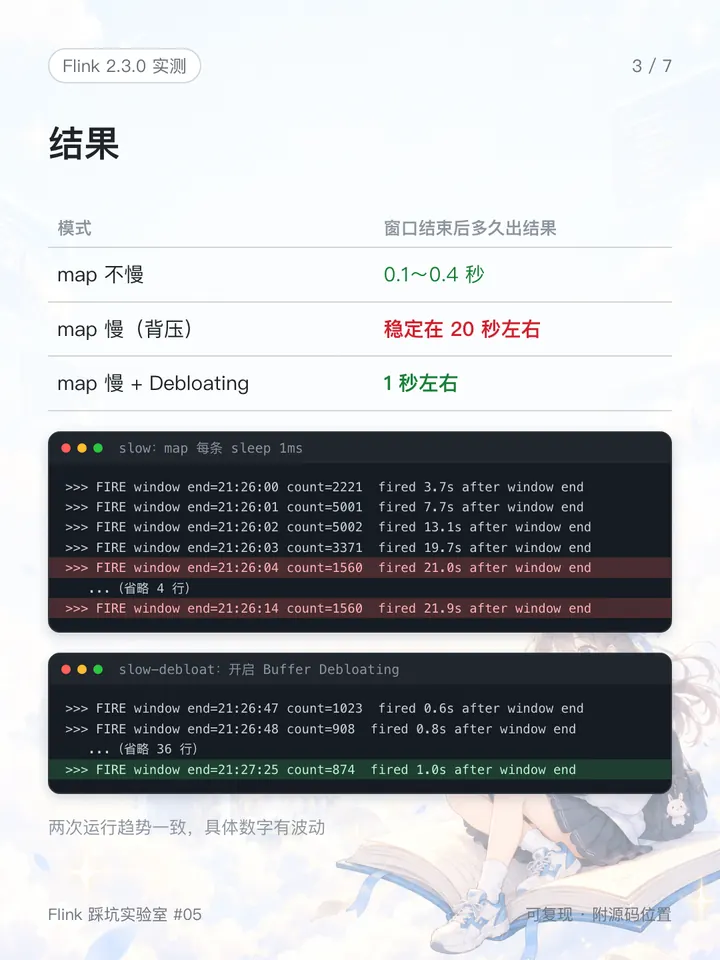
实验配置:Source 每秒 5000 条,事件时间 = 产生这条数据的时刻 → 经过网络(rebalance)→ map → 1 秒滚动窗口。所有算子并行度 1,MiniCluster 2 个 TaskManager。每个窗口触发时打印“比窗口结束晚了多久”,各模式运行 40 秒。
| 模式 | map | 窗口结束后多久出结果 |
|---|---|---|
normal | 不 sleep | 40 秒内触发 40 个窗口,都在 0.1~0.4 秒 |
slow | 每条 sleep 1ms | 从 3.7 秒一路涨,第一次运行稳定在约 19~23 秒,第二次约 17~19 秒 |
slow-debloat | 同 slow,开启 Buffer Debloating | 第一次运行 40 秒内触发 39 个窗口,稳定后在 0.9~1.3 秒,多数是 1.0~1.1 秒;第二次大多在 1.0~1.1 秒,后段个别窗口到过 2.5 秒 |
slow 模式第一次运行的输出(节选):
>>> FIRE window end=21:26:00 count=2221  fired 3.7s after window end
>>> FIRE window end=21:26:01 count=5001  fired 7.7s after window end
>>> FIRE window end=21:26:02 count=5002  fired 13.1s after window end
>>> FIRE window end=21:26:03 count=3371  fired 19.7s after window end
>>> FIRE window end=21:26:04 count=1560  fired 21.0s after window end
>>> FIRE window end=21:26:06 count=1560  fired 19.7s after window end
>>> FIRE window end=21:26:08 count=1559  fired 21.7s after window end
>>> FIRE window end=21:26:10 count=1559  fired 22.5s after window end
>>> FIRE window end=21:26:12 count=1560  fired 23.0s after window end
>>> FIRE window end=21:26:14 count=1560  fired 21.9s after window end
怎么读:前几个窗口里有 5000 条左右,因为作业刚启动时缓冲区还没满,Source 还能按每秒 5000 条发。缓冲区满了以后,Source 被背压拖慢,每个窗口只剩 1560 条,而且每隔一秒才有一个窗口。1560 条 / 2 秒 ≈ 每秒 780 条,正好是 map 的实际处理能力(sleep(1) 实际每条要 1 毫秒多)。延迟涨到 20 秒左右就不再涨了,因为缓冲区已经装满。
结论可以复现,但具体数字会随机器负载波动,只能说“20 秒左右”“1 秒左右”。
原因
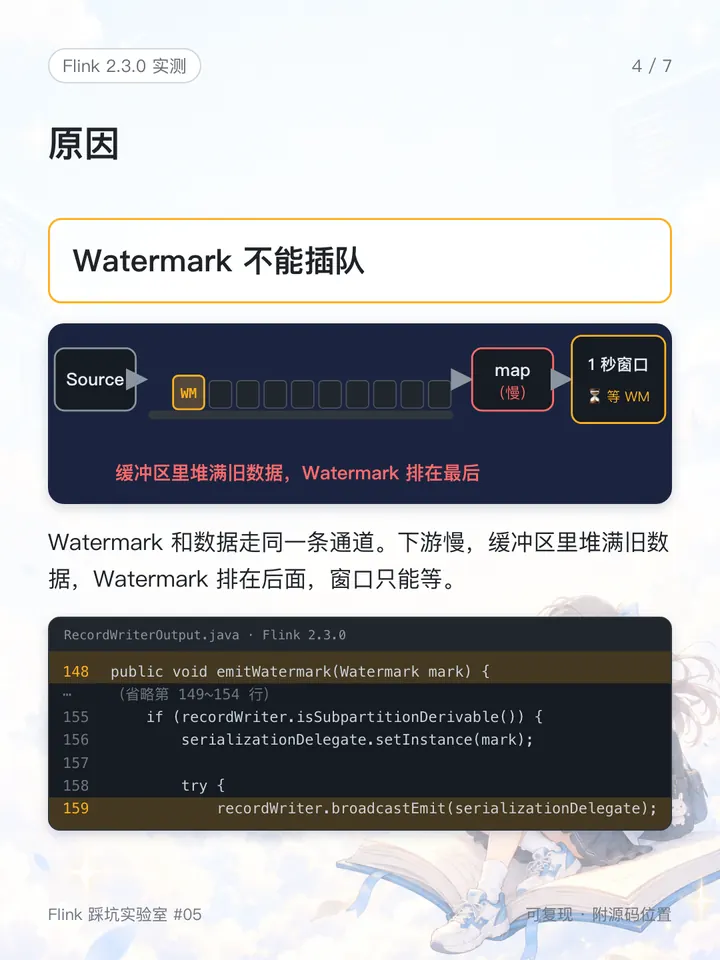
Watermark 和数据走同一条通道:同样序列化、同样进网络缓冲区,广播给所有下游(RecordWriterOutput.java:148-159,emitWatermark 调用 recordWriter.broadcastEmit)。
所以在同一个通道里,Watermark 排在它前面的数据后面,前面的数据没处理完,下游就看不到这个 Watermark。背压时,缓冲区里积压着大量“旧”数据,Watermark 被堵在它们后面,窗口要等 Watermark,就只能干等。
缓冲区的容量是有限的,所以延迟不会无限增长,而是稳定在某个值附近。这个值取决于缓冲区里能装多少条数据、下游每秒能处理多少条;换一个作业,数字会完全不同。
另外,背压时 Source 本身也会变慢,单位时间内产生的数据变少,有的 1 秒窗口里一条数据都没有。没有数据的窗口不会输出,这就是 slow 模式里每隔一秒才有一个窗口的原因(“整秒没有数据”是根据输出推断的)。
怎么解决
缓解:开启 Buffer Debloating。
taskmanager.network.memory.buffer-debloat.enabled: true它让缓冲区里的数据“刚好够下游处理 1 秒”,目标由 taskmanager.network.memory.buffer-debloat.target 控制,默认 1 秒(TaskManagerOptions.java:483)。这个功能默认是关闭的(buffer-debloat.enabled 默认 false,TaskManagerOptions.java:492)。实测开启后,延迟从 20 秒左右降到了 1 秒左右。
几点注意:
- 它不能把延迟降到 0:目标本身就是“缓冲区里的数据够处理 1 秒”,实测也在 1 秒左右。
- 背压还在:只是缓冲区里积压的数据少了,Watermark 等的时间短了。
- 非对齐 Checkpoint 解决不了这个问题:它只让 Barrier 越过缓冲区里的数据,Watermark 不能越过(本文没有专门做非对齐 Checkpoint 的实验)。
根治:找到并优化那个慢的算子,让它跟得上 Source 的速度(定位方法见第四讲第六节)。
还要和踩坑实验室 #01 区分开:#01 是空闲分区让 Watermark 永远停在最小值,窗口永远不触发;本文是背压把 Watermark 堵住,窗口只是触发得晚。
记住这几点
- Watermark 和数据排在同一条通道里,不能插队;背压时它被堵在旧数据后面,窗口结果随之延迟,并稳定在某个值附近。
- Buffer Debloating 默认关闭,开启后实测把延迟从 20 秒左右降到 1 秒左右,但背压还在,非对齐 Checkpoint 也帮不了 Watermark。
- 真正的解决办法是优化慢的算子;延迟的具体数字取决于缓冲区大小、数据大小和下游速度。