
踩坑实验室 #09:一个 Task 挂了,为什么有时重启 4 个,有时只重启 1 个?
Apache Flink 源码学习
作者 X老师(DaemonforY),Flink 2.3.0 源码,按 CC BY-NC-SA 4.0 发布。
基于 Flink 2.3.0 本机实测(核对日期 2026-10-02)。对应课程:第六讲《调度与容错》第二节“Pipelined Region”。配套示例:
flink-notes/demos/src/main/java/study/scheduler/FailoverDemo.java
现象
同样是并行度 2 的流作业,同样让一个 Task 抛一次异常:有的作业重启了 4 个 Task,连没出错的计数算子也被重启;有的作业只重启了出错的那 1 个,另一个 subtask 完全不受影响。区别只在于上下游是怎么连的。
复现
示例 FailoverDemo:并行度 2,每 2 秒一次 Checkpoint。fail-map 的子任务 0 在前两次执行时各处理 3000 条后抛一次异常。三种拓扑:
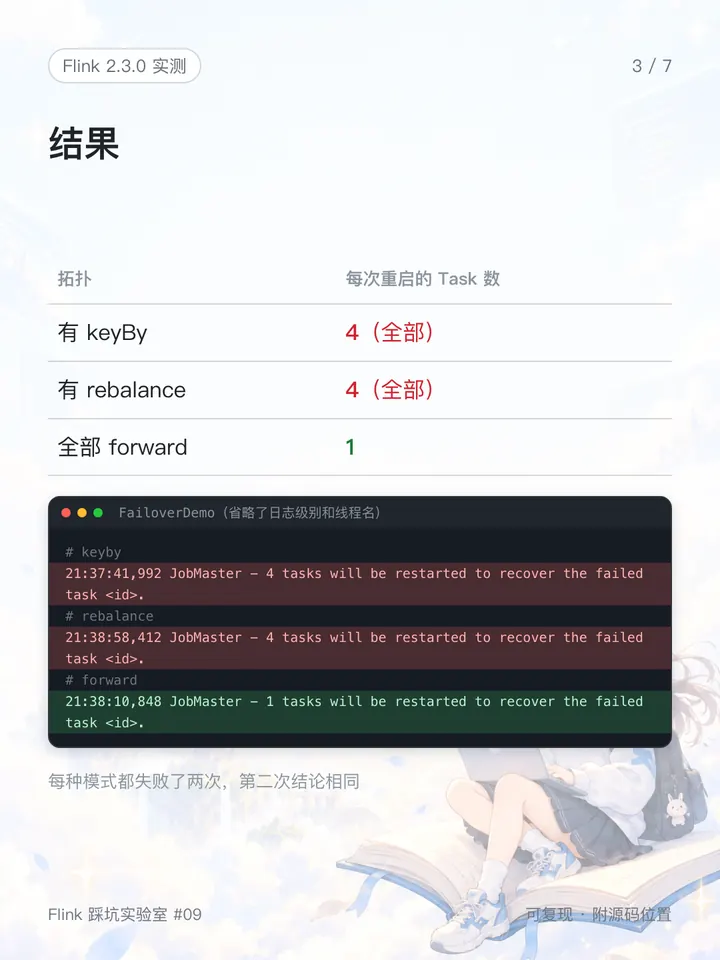
| 模式 | 拓扑 | Task 数 |
|---|---|---|
keyby | Source → fail-map ─keyBy─▶ after-keyby → count → Sink | 4(两条算子链 × 2 个并行度) |
rebalance | Source → fail-map ─rebalance─▶ after-rebalance → count → Sink | 4 |
forward | Source → fail-map → count → Sink,全部链在一起 | 2 |
日志节选(ID 用 <id> 代替,省略了日志级别和线程名):
# keyby
21:37:41,979 Task - Source: source -> fail-map (1/2)#0 switched from RUNNING to FAILED
21:37:41,992 JobMaster - 4 tasks will be restarted to recover the failed task <id>.
>>> [after-keyby -> count -> Sink: Writer (1/2)#1] attempt=1 initializeState: restored=true count=1796
>>> [after-keyby -> count -> Sink: Writer (2/2)#1] attempt=1 initializeState: restored=true count=2316

# rebalance
21:38:58,400 Task - Source: source -> fail-map (1/2)#0 switched from RUNNING to FAILED
21:38:58,412 JobMaster - 4 tasks will be restarted to recover the failed task <id>.

# forward
21:38:10,818 Task - Source: source -> fail-map -> count -> Sink: Writer (1/2)#0 switched from RUNNING to FAILED
21:38:10,848 JobMaster - 1 tasks will be restarted to recover the failed task <id>.
>>> [Source: source -> fail-map -> count -> Sink: Writer (1/2)#1] attempt=1 initializeState: restored=true count=2045| 拓扑 | 每次重启的 Task 数 |
|---|---|
| 有 keyBy | 4(全部) |
| 有 rebalance | 4(全部) |
| 全部 forward | 1 |
每种模式都失败了两次,第二次的结论相同;keyby 和 forward 在写第六讲时还各跑过两次,结论完全一致。
怎么看出一个 Task 被连带重启了:线程名里的 #0、#1 是 attemptNumber,每重启一次加 1。keyby 和 rebalance 里,没出错的 count (2/2) 也从 #0 变成了 #1;forward 里只有 (1/2) 被重新初始化,(2/2) 从头到尾都是 #0。重启后的 restored=true 说明状态从最近一次完成的 Checkpoint 恢复,不是从 0 开始。
原因
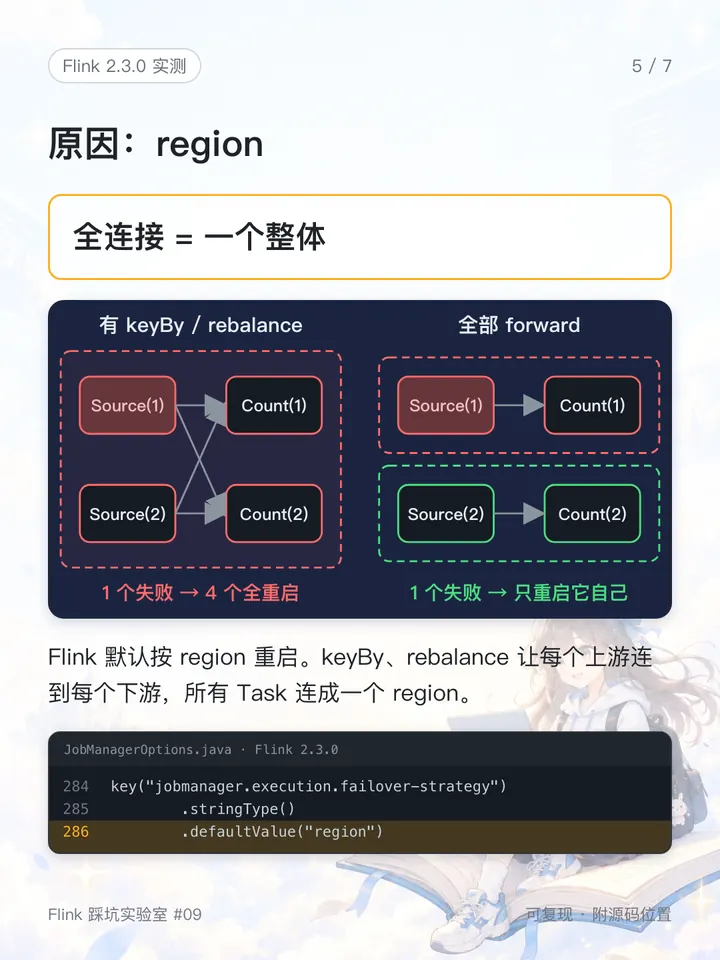
默认的 failover 策略是 region(jobmanager.execution.failover-strategy,JobManagerOptions.java:284-286):一个 Task 失败,只重启它所在的 pipelined region 以及受影响的下游(RestartPipelinedRegionFailoverStrategy.java:110)。
用 pipelined 边(数据在内存里直接流给下游、不落盘)连起来的 Task 属于同一个 region(SchedulingPipelinedRegionComputeUtil.java:46-62)。流作业里所有的边都是 pipelined 的,所以 region 怎么划分,完全取决于上下游怎么连:
keyBy、rebalance是 all-to-all 的边,每个上游连到每个下游,所有 Task 连成一个 region,一个失败就全部重启;- 全部是一对一(forward)连接时,每个 subtask 自成一个 region,只重启失败的那个。
还有一个更隐蔽的情况:没写分区方式时,上下游并行度相同才用 forward,并行度不同时 Flink 会自动用 rebalance(StreamGraph.java:912-920)。也就是说,只改了一个算子的并行度,作业就可能从“只重启一部分”变成“全部重启”。
怎么解决
想缩小重启范围,前提是作业里每一步都是一对一连接,并且上下游并行度一致。只是不用 keyBy 还不够:rebalance 同样是全连接,而并行度不一致时 Flink 会自动加上 rebalance。
对大多数带 keyBy 的流作业来说,一个 region 就是整个作业,region 重启和全量重启的范围是一样的,不要指望它能带来更快的恢复。排查时,可以直接看 tasks will be restarted 这行日志里的数量,以及线程名后面的 # 数字,判断哪些 Task 被重启过。
还要注意适用范围:本文说的是流作业加默认的 DefaultScheduler。批作业里 blocking 边会把 region 切开,情况不同,本文没有验证;AdaptiveScheduler 每次都重启整个作业,没有 region 的概念。另外,重启后从最近一次完成的 Checkpoint 恢复,从那之后处理过的数据会被重新处理一遍。
记住这几点
- Flink 默认按 pipelined region 重启,而不是只重启失败的 Task。
keyBy、rebalance把所有 Task 连成一个 region,一个出错就全部重启;上下游并行度不同时,Flink 会自动用 rebalance。- 只重启一部分的前提:全部一对一连接,并且并行度一致;用线程名里的
#数字确认谁被重启过。