
踩坑实验室 #11:Checkpoint 每 2 秒一次,FileSink 的数据却等了 120 秒
Apache Flink 源码学习
作者 X老师(DaemonforY),Flink 2.3.0 源码,按 CC BY-NC-SA 4.0 发布。
基于 Flink 2.3.0 本机实测(核对日期 2026-10-03)。对应课程:第八讲(下)《Sink 与端到端 exactly-once》第二节。配套示例:
flink-notes/demos/src/main/java/study/connector/FileSinkLatencyDemo.java
现象
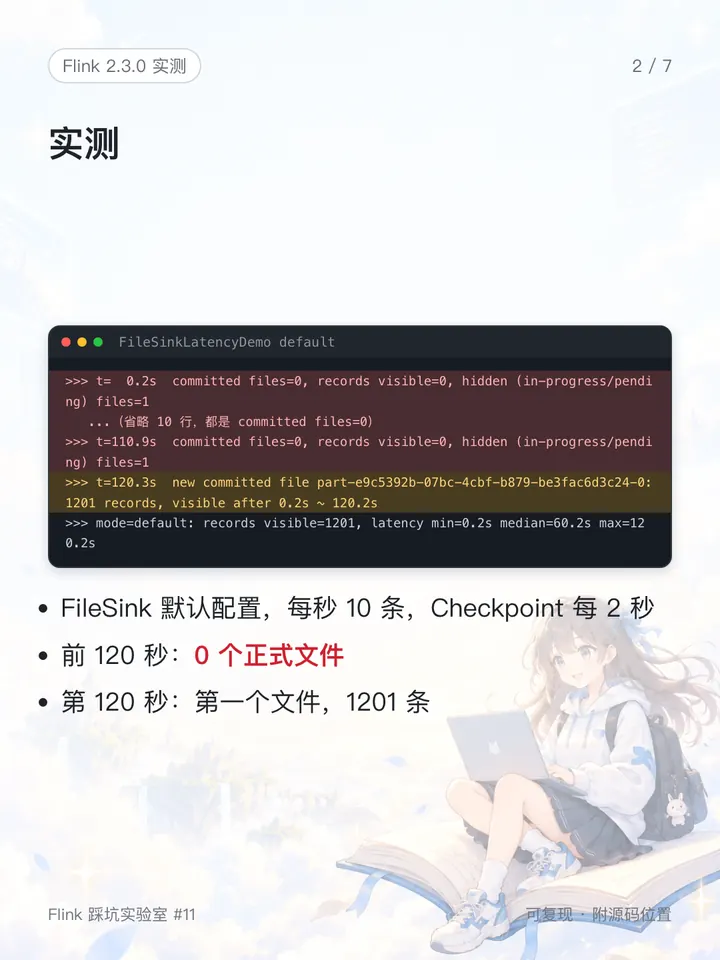
用最普通的方式写一个 FileSink,什么都不配,Checkpoint 每 2 秒一次。作业跑了一分多钟,输出目录里却一个正式文件都没有,只有一个隐藏的临时文件在变大;直到第 120 秒,第一个文件才出现,最早的那条数据等了 120 秒。
复现
示例 FileSinkLatencyDemo:FileSink.forRowFormat,并行度 1,每秒 10 条,Checkpoint 每 2 秒一次。每条数据带上生成时间;主线程每 200ms 扫一次输出目录,记录每个正式文件第一次出现的时刻,算出每条数据从生成到能被看到的延迟。三种模式:
FileSink.DefaultRowFormatBuilder<String> builder =
        FileSink.forRowFormat(new Path(OUT), new SimpleStringEncoder<String>("UTF-8"));

// default:什么都不设
sink = builder.build();

// oncheckpoint:每次 Checkpoint 都滚动
sink = builder.withRollingPolicy(OnCheckpointRollingPolicy.build()).build();

// tuned:仍用 DefaultRollingPolicy,调小滚动时间和检查周期
sink = builder.withRollingPolicy(
                DefaultRollingPolicy.builder()
                        .withRolloverInterval(Duration.ofSeconds(10))
                        .withInactivityInterval(Duration.ofSeconds(10))
                        .build())
        .withBucketCheckInterval(1000)
        .build();
default 模式的输出节选:
>>> t=  0.2s  committed files=0, records visible=0, hidden (in-progress/pending) files=1
...(t=10s ~ 110s 每 10 秒一行,都是 committed files=0)
>>> t=120.3s  new committed file part-e9c5392b-07bc-4cbf-b879-be3fac6d3c24-0: 1201 records, visible after 0.2s ~ 120.2s
>>> mode=default: records visible=1201, latency min=0.2s median=60.2s max=120.2s| 模式 | 第一个正式文件 | 最大延迟 | 中位数 |
|---|---|---|---|
| default | 120 秒 | 120.2 秒 | 60.2 秒 |
| tuned | 12 秒 | 12.8 秒 | 6.8 秒 |
| oncheckpoint | 0.2 秒(只有 1 条),之后每 2 秒一个 | 2.1 秒 | 1.1 秒 |
default 和 oncheckpoint 在写第八讲下篇时跑过一次,这次结果几乎相同(default 两次都是 120 秒);tuned 只跑了一次。等待期间正在写和等待提交的文件以 . 开头(形如 .part-...inprogress...),是隐藏文件,下游按正常方式列目录时看不到。
原因
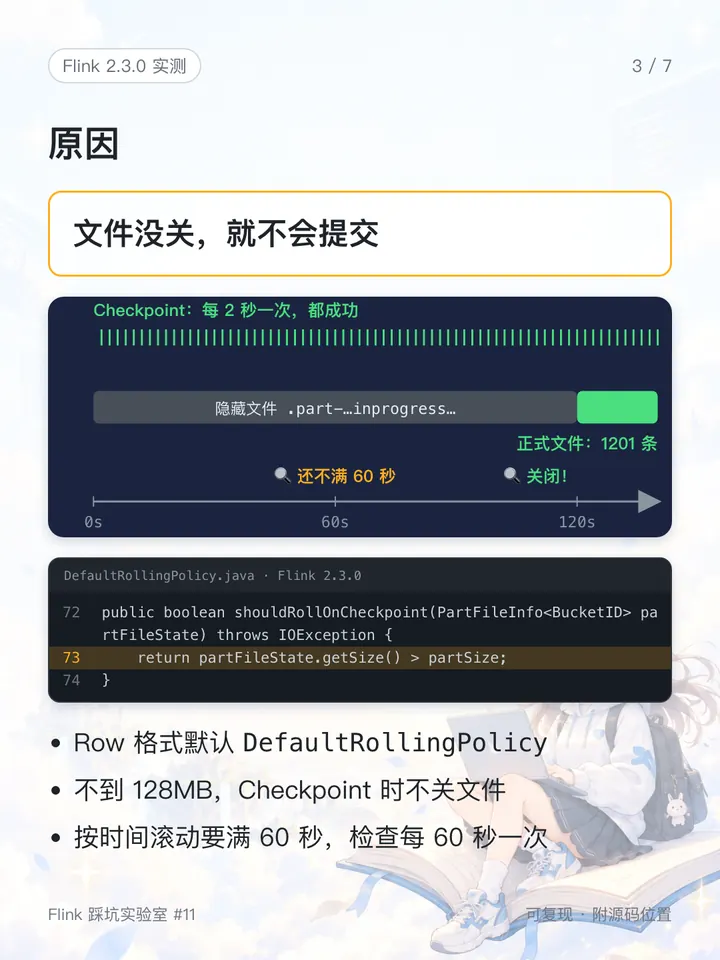
Checkpoint 一直是正常完成的,问题不在 Checkpoint,而在 Writer 在 Checkpoint 时没有可以交出的文件。
FileSink 是两阶段提交:Checkpoint 时交出“已经关闭的文件”,Checkpoint 完成后才把它改名为正式文件(FileWriterBucket.java:194-215,prepareCommit)。正在写的文件要不要在 Checkpoint 时关闭,由滚动策略决定(FileWriterBucket.java:196,rollingPolicy.shouldRollOnCheckpoint(inProgressPart) || endOfInput)。
Row 格式默认用 DefaultRollingPolicy(FileSink.java:364),它的规则是:
- 只有文件超过 128MB 时,才在 Checkpoint 时关闭(
DefaultRollingPolicy.java:72-74,partSize默认值见:52); - 按处理时间滚动:文件创建满 60 秒,或者 60 秒没有新数据(
DefaultRollingPolicy.java:83-87、:48、:50); - 按处理时间滚动的检查,默认每 60 秒才做一次(
FileSink.java:297,DEFAULT_BUCKET_CHECK_INTERVAL)。
每秒 10 条的数据量远不到 128MB,只能等按时间滚动,所以数据要等一到两分钟才能被看到。至于为什么是 120 秒而不是 60 秒:检查定时器在 Writer 初始化时就注册了,比第一条数据早一点,第 60 秒那次检查时文件还不满 60 秒(FileWriter.java:175、:275-279)。这一条是按代码推断的,没有打印定时器和文件创建的精确时间。
这也不是 bug:FileSink 的 Javadoc 写明了 Row 格式默认用 DefaultRollingPolicy、检查周期默认 1 分钟(FileSink.java:105-109)。
怎么解决
- 解法一:
OnCheckpointRollingPolicy。每次 Checkpoint 都关闭文件(CheckpointRollingPolicy.java:30-32,shouldRollOnCheckpoint返回 true),实测最多 2.1 秒可见。 - 解法二:调小
DefaultRollingPolicy的滚动时间和检查周期。滚动 10 秒、检查 1 秒时,实测最多 12.8 秒可见。
两种解法的代价都是小文件变多。以 OnCheckpointRollingPolicy 为例,每个 Checkpoint、每个并行度、每个分桶都会生成一个文件;Checkpoint 间隔 2 秒时,每个并行度每小时约 1800 个文件(按配置计算,没有实测文件数)。延迟和小文件数量之间需要按下游的需求权衡。
如果用的是 Parquet 这类 Bulk 格式,默认就是 OnCheckpointRollingPolicy(FileSink.java:546),没有这个问题,这个坑只出现在 Row 格式里。另外,120 秒是“每秒 10 条、启动后立刻有数据”这个场景下的结果:数据量大到文件超过 128MB 时会在 Checkpoint 时滚动,定时器和第一条数据的先后不同,也可能在 60 秒左右就滚动。本文只验证了 FileSink,Kafka 等事务型 Sink 的可见时间由各自的实现决定。
记住这几点
- Checkpoint 只决定“什么时候能提交”,滚动策略决定“有什么可以提交”;文件没关,就不会被提交。
- Row 格式默认的
DefaultRollingPolicy不到 128MB 不在 Checkpoint 时关文件,按时间滚动要满 60 秒、每 60 秒检查一次。 - 想降低延迟,换
OnCheckpointRollingPolicy或调小滚动时间和检查周期,同时评估小文件变多的代价。