
踩坑实验室 #18:同样四个算子,为什么一会儿 1 个 Task,一会儿 3 个?
Apache Flink 源码学习
作者 X老师(DaemonforY),Flink 2.3.0 源码,按 CC BY-NC-SA 4.0 发布。
基于 Flink 2.3.0 本机实测(核对日期 2026-10-04)。对应课程:第一讲(上)第五节「算子链在这里决定」。配套示例:
flink-notes/demos/src/main/java/study/exec/ChainBreakDemo.java
现象
同样是 source、map-a、map-b、sink 四个算子,什么都不加时只生成 1 个 Task;多写一行代码,就变成了 2 个甚至 3 个。还有一种情况更让人意外:明明显式写了 forward(),作业却直接报错。
一条算子链对应一个 JobVertex,运行时是一个 Task,在 Web UI 上是一个节点。链在一起的算子在同一个线程里直接调用,不序列化、也不走网络缓冲区。所以 Task 的个数,直接反映了算子链在哪里断开。
复现
示例 ChainBreakDemo:基础拓扑 source → map-a → map-b → sink,全部并行度 2。在 map-a 和 map-b 之间换上不同的写法,调用 getJobGraph() 看生成了几个 Task(不提交作业):
| 写法 | Task 数 | 生成的 Task |
|---|---|---|
| ① 什么都不加 | 1 | source -> map-a -> map-b -> sink |
② keyBy | 2 | source -> map-a / map-b -> sink |
③ rebalance() | 2 | source -> map-a / map-b -> sink |
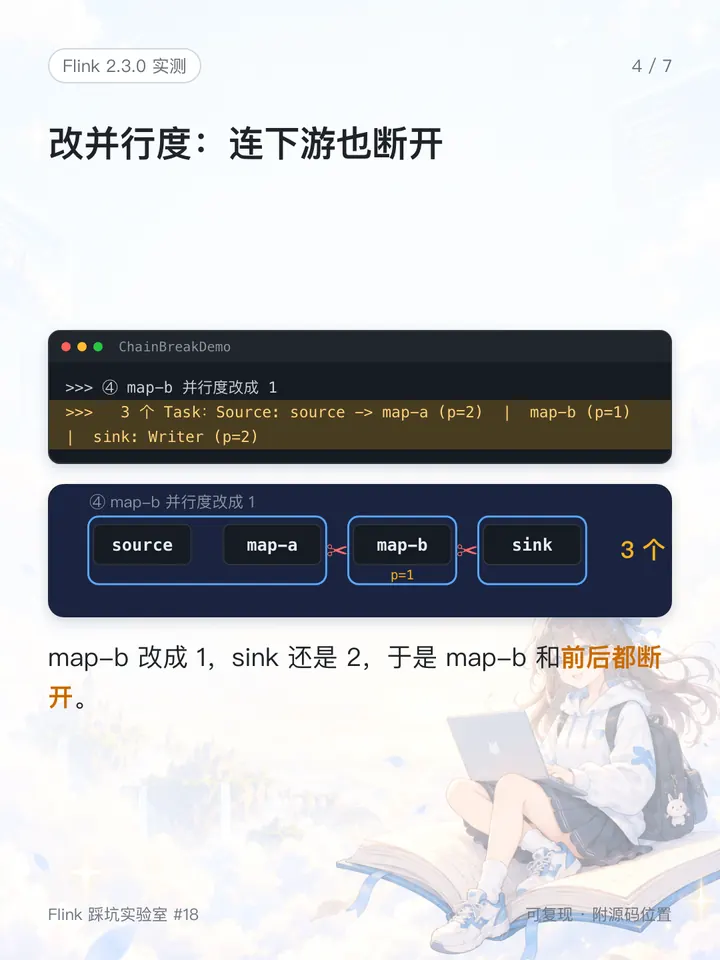
| ④ map-b 并行度改成 1 | 3 | source -> map-a / map-b (p=1) / sink |
| ⑤ map-b 放进另一个 slotSharingGroup | 2 | source -> map-a / map-b -> sink |
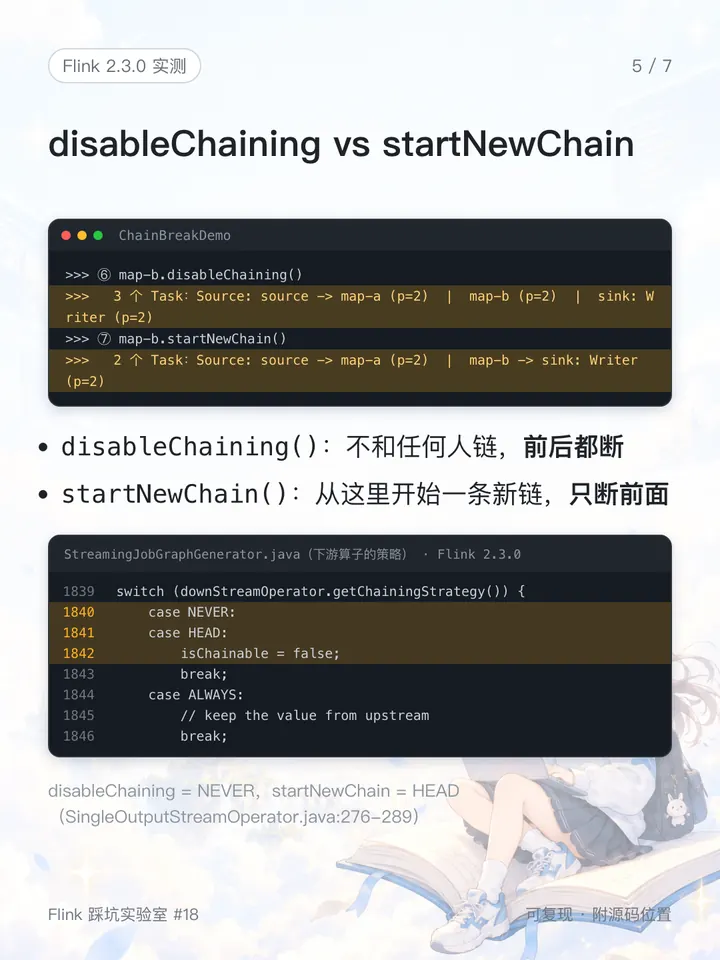
⑥ map-b.disableChaining() | 3 | source -> map-a / map-b / sink |
⑦ map-b.startNewChain() | 2 | source -> map-a / map-b -> sink |
⑧ 显式 forward(),map-b 并行度改成 1 | 报错 | UnsupportedOperationException |
⑧ 的完整报错:
UnsupportedOperationException: Forward partitioning does not allow change of parallelism. Upstream operation: map-a-41 parallelism: 2, downstream operation: map-b-43 parallelism: 1 You must use another partitioning strategy, such as broadcast, rebalance, shuffle or global.其中 map-a-41、map-b-43 是内部编号,换台机器可能不同。这个示例不启动作业、不依赖时序,结果是确定的。
原因
两个算子能链在一起,要同时满足一组条件:开启了算子链、在同一个 slotSharingGroup、链接策略允许、分区方式是 forward、并行度相同等(StreamingJobGraphGenerator.java:1756-1800 的 isChainableInput,以及 :1802 起的 areOperatorsChainable)。逐个对照实测:
- ②③:
keyBy、rebalance()都不是 forward,所以断开。 - ④:没写分区方式时,并行度不同 Flink 会自动改用 rebalance(
StreamGraph.java:912-920)。map-b 改成 1 后,它和上游 map-a 不同,和下游 sink(仍是 2)也不同,所以前后都断开,一共 3 个 Task。 - ⑤:slotSharingGroup 不同会断开(
StreamingJobGraphGenerator.java:1762)。sink 没有指定组,会继承上游的组(StreamGraphGenerator.java:654-669),于是跟着 map-b 进了 "other",两者仍然链在一起。 - ⑥⑦:
disableChaining()把策略设为NEVER(SingleOutputStreamOperator.java:276-278),前后都断;startNewChain()设为HEAD(SingleOutputStreamOperator.java:287-289),只断前面,和后面还能链。两种策略的判断都在StreamingJobGraphGenerator.java:1824-1851。 - ⑧:显式写了
forward()但并行度不同,Flink 不会自动降级,而是直接抛异常(StreamGraph.java:922-935)。
④ 和 ⑥ 都是 3 个 Task,但原因不同:④ 是 map-b 的并行度和前后都不一样,⑥ 是 map-b 不和任何算子链。
怎么解决
想知道作业为什么拆成了这么多 Task,就逐条检查相邻算子之间的"边":分区方式是不是 forward、并行度是否一致、slotSharingGroup 是否相同、有没有调用 disableChaining() / startNewChain()。
几点注意:
- 调整某个算子的并行度时,它和下游也可能断开,因为下游还是原来的并行度;
- 给算子指定 slotSharingGroup 不只影响资源分配,也会让链断开,后面没指定组的算子会跟着继承;
- 需要固定分区方式时,写
forward()前确认上下游并行度一致,否则会直接报错; - 算子链并不是越长越好:一个 Task 里的算子共享一个线程,排查时看不出是哪个算子慢,第四讲建议排查时临时
disableChaining()拆开看(本文没有做性能对比); - 示例里的 Task 数不能直接套到集群上:并行度、默认配置不同时结果会变,第一讲上篇里就有 IDE 中 3 个 Task、集群上 2 个的例子。
记住这几点
- Task 的个数不是由写了几个算子决定的,而是由算子之间的"边"决定的。
disableChaining()前后都断,startNewChain()只断前面。- 没写分区方式时并行度不同会自动用 rebalance;显式
forward()加并行度不同则直接报错。