
S2 第 5 讲:并发提交——乐观锁、冲突检测、重试
Apache Paimon 源码学习
作者 X老师(DaemonforY),Paimon 2.0 / master 源码,按 CC BY-NC-SA 4.0 发布。配套实验和代码在 GitHub。
TL;DR:Paimon 提交不锁表。每次提交先把数据文件和 manifest 都写好,最后抢一个文件名
snapshot-(N+1):rename 成功就赢,失败说明被别人抢了,重读最新快照、退避后重试——实验里两个作业并发提交 60 次,抢号失败 18~25 次,全部自动成功。但如果你要删除的文件已经被别人删了(两个作业合并同一批文件),就是真冲突:File deletion conflicts detected!,直接抛异常、不重试。重启后重复提交同一个 checkpoint 则会被commitUser + identifier过滤掉。
实验:用 Java API 精确控制“谁先提交”
前几讲都用 Flink SQL,这一讲换成 Paimon 的 Java API(StreamWriteBuilder → StreamTableWrite / StreamTableCommit),因为要精确控制两个“作业”谁先提交。实验程序 CommitLab.java 有三个场景,一条命令跑完:
cd labs && MAIN_CLASS=learning.paimon.CommitLab ./run.sh
run.sh新增了MAIN_CLASS变量,默认仍是 SqlRunner。
一、一次提交的五步
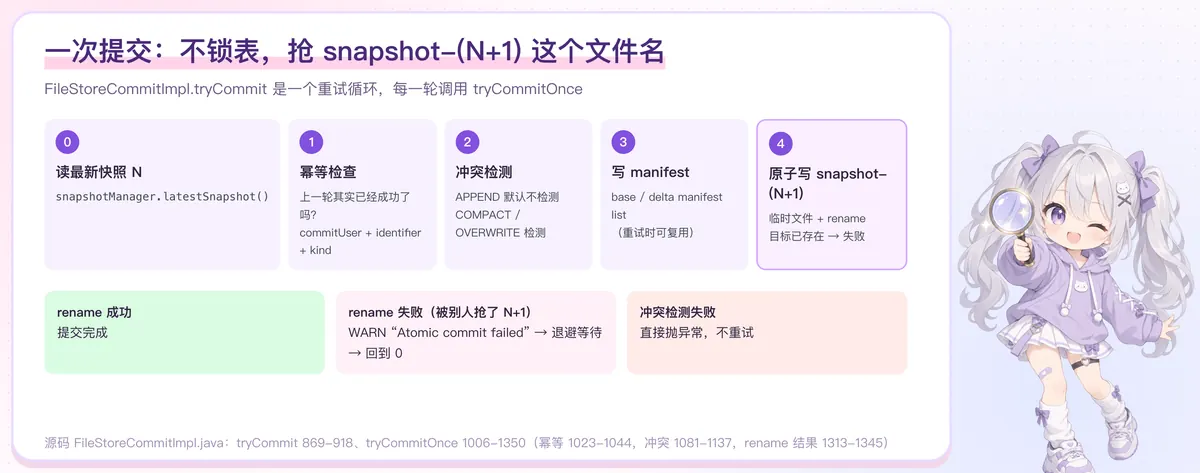
FileStoreCommitImpl.tryCommit(第 869~918 行)是一个重试循环,每一轮调用 tryCommitOnce:
while (true) {
    Snapshot latestSnapshot = snapshotManager.latestSnapshot();       // 0. 读最新快照 N
    CommitResult result = tryCommitOnce(retryResult, ..., latestSnapshot, detectConflicts, ...);
    if (result.isSuccess()) break;
    retryResult = (RetryCommitResult) result;
    if (超时 || retryCount >= commit.max-retries) throw new RuntimeException("Commit failed ...");
    retryWaiter.retryWait(retryCount);                               // 退避
    retryCount++;
}tryCommitOnce(第 1006 行起):
- 幂等检查(第 1023~1044 行):如果上一轮是“提交时出异常、不知道成没成功”,先扫描期间的快照,找到同一
commitUser + identifier + commitKind就直接判定成功; - 冲突检测(第 1081~1137 行):
latestSnapshot != null && (detectConflicts || discardDuplicate)才做; - 写 manifest:base / delta manifest list(第 6 讲 S1 里看过),重试时可复用上一轮的合并结果;
- 原子写
snapshot-(N+1):RenamingSnapshotCommit→ 临时文件 + rename,目标已存在就失败(第 1 讲)。
三种结局(第 1313~1345 行):
| 结局 | 日志 | 处理 |
|---|---|---|
| rename 成功 | Successfully commit snapshot N | 完成 |
| rename 返回 false | WARN Atomic commit failed for snapshot #N ... Skip clean up and try again. | 保留临时文件,退避后重试 |
| 冲突检测失败 | File deletion conflicts detected! Give up committing. | 直接抛异常 |
二、场景 1:两个作业并发 APPEND,抢号
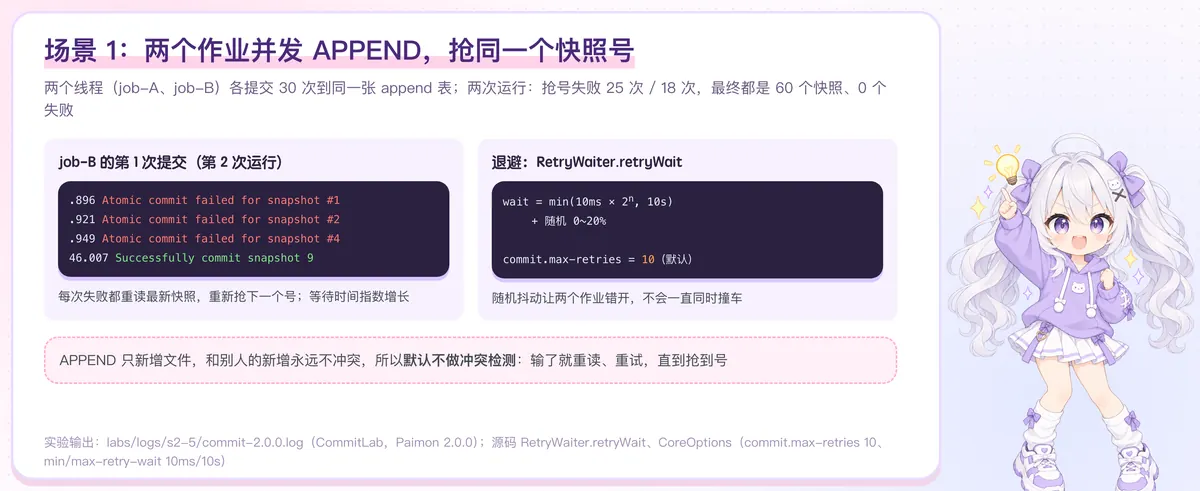
两个线程模拟两个作业(commitUser 分别是 job-A、job-B),同时往一张 append 表各提交 30 次。
结果(运行两次):
第 1 次运行:Atomic commit failed 共 25 次;失败的作业数 = 0;最新快照 id = 60;{job-A=30, job-B=30}
第 2 次运行:Atomic commit failed 共 18 次;失败的作业数 = 0;最新快照 id = 60;{job-A=30, job-B=30}(run-all.sh 冒烟测试里的第 3 次运行:11 次,同样 60/60。)
抢号失败的次数每次都不一样(取决于线程调度),但结果总是一样:60 次提交全部成功,没有丢、没有重。看第 2 次运行里 job-B 的第一次提交:
45.896 WARN Atomic commit failed for snapshot #1 by user job-B with identifier 1 and kind APPEND
45.921 WARN Atomic commit failed for snapshot #2 by user job-B with identifier 1 and kind APPEND
45.949 WARN Atomic commit failed for snapshot #4 by user job-B with identifier 1 and kind APPEND
46.007 INFO Successfully commit snapshot 9 to table race_log by user job-B with identifier 1
每次失败都重读最新快照、抢下一个号;三次失败之间,job-A 已经连续提交了好几个快照。等待时间由 RetryWaiter.retryWait 决定:
int retryWait = (int) Math.min(minRetryWait * Math.pow(2, retryCount), maxRetryWait);   // 10ms × 2^n,上限 10s
retryWait += random.nextInt(Math.max(1, (int) (retryWait * 0.2)));                        // + 0~20% 随机抖动
默认 commit.max-retries = 10、commit.min-retry-wait = 10ms、commit.max-retry-wait = 10s。随机抖动让两个作业错开,不会一直同时撞车。
为什么 APPEND 可以放心重试? 它只新增文件,别人的新增不会让我的新增变得非法,所以默认不做冲突检测(detectConflicts 对 APPEND 默认为 false)——输了就重读、重试,直到抢到号。
三、场景 2:两个作业合并同一个 bucket,真冲突
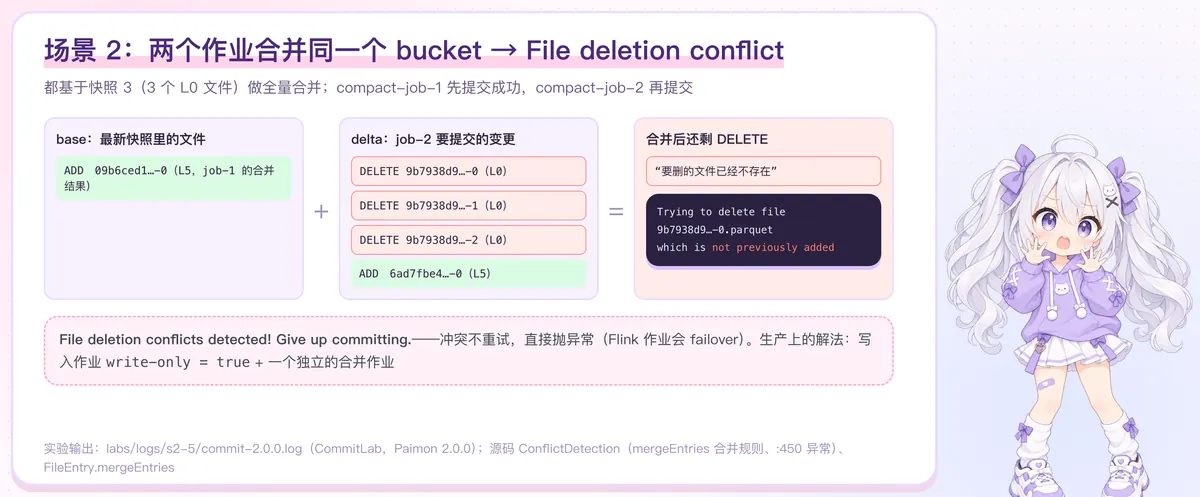
主键表、1 个 bucket,先写 3 次(3 个 L0 文件,快照 1~3)。然后两个合并作业 compact-job-1、compact-job-2 都基于快照 3 做全量合并,各自得到一份变更:
compact-job-1:compactBefore = [9b7938d9…-0, -1, -2],compactAfter = [09b6ced1…-0]
compact-job-2:compactBefore = [9b7938d9…-0, -1, -2],compactAfter = [6ad7fbe4…-0]
两份变更都要删除同样的 3 个 L0 文件。compact-job-1 先提交,成功(快照 5,COMPACT);compact-job-2 再提交:
java.lang.RuntimeException: File deletion conflicts detected! Give up committing.
...
Base entries are:
{kind=ADD, level=5, fileName=data-09b6ced1…-0.parquet, rowCount=3}
Changes are:
{kind=DELETE, level=0, fileName=data-9b7938d9…-0.parquet}
{kind=DELETE, level=0, fileName=data-9b7938d9…-1.parquet}
{kind=DELETE, level=0, fileName=data-9b7938d9…-2.parquet}
{kind=ADD,    level=5, fileName=data-6ad7fbe4…-0.parquet}
Caused by: java.lang.IllegalStateException: Trying to delete file data-9b7938d9…-0.parquet for table conflict_orders which is not previously added.冲突检测的逻辑很朴素:把**最新快照里这些分区的文件(base)和我的变更(delta)**合并——ADD 放进去,DELETE 遇到同名 ADD 就抵消。合并完还剩 DELETE,说明“我要删的文件已经不在了”,一定是别人删的——于是放弃提交。
这种冲突不重试:重试一万次,要删的文件也不会回来。在 Flink 作业里,它会触发 failover,从 checkpoint 重新开始。
生产上的解法(异常信息里也写了):多个作业写同一张表时,写入作业设 write-only = true 只写不合并,另起一个独立的合并作业(dedicated compaction)。
主键表还有第四道检查
PrimaryKeyConflictDetection:同一个 bucket 的 L1 及以上,同层文件的 key 范围不能重叠(“LSM conflicts detected!”)。两个作业各自合并不同的 L0 文件、都输出到同一层时,不会删到同一个文件,但同层会重叠——这时要靠这道检查。本讲未单独做实验。
四、场景 3:重启后重复提交
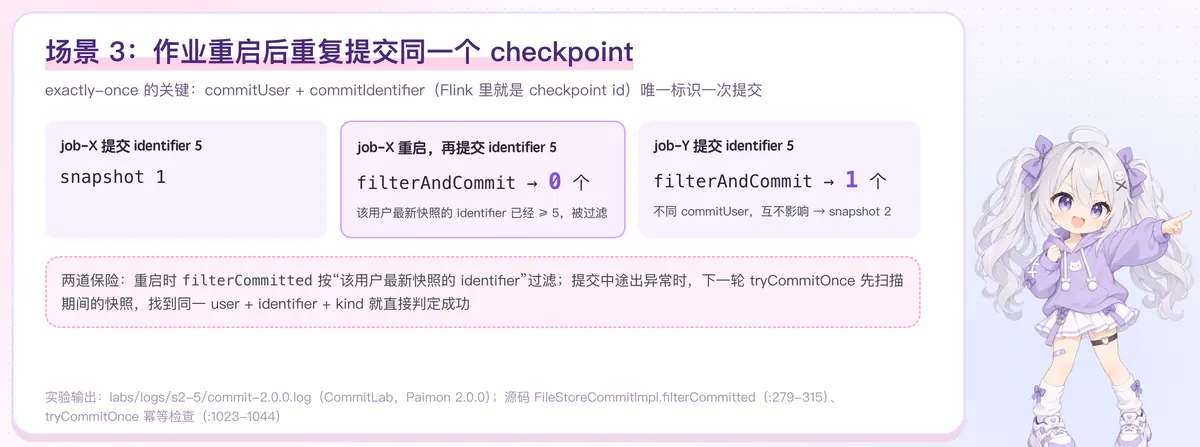
Flink 作业 failover 后,会把 checkpoint 里“还没确认提交”的 CommitMessage 再提交一次。如果上一次其实已经成功了,就会重复。Paimon 怎么防?
job-X 提交 identifier 5                          → snapshot 1
job-X 重启,filterAndCommit(identifier 5)       → 实际提交了 0 个
job-Y filterAndCommit(identifier 5) → 实际提交了 1 个 → snapshot 2FileStoreCommitImpl.filterCommitted(第 279~315 行)找到该 commitUser 的最新快照,只保留 identifier 比它大的提交。Flink 里 identifier 就是 checkpoint id,commitUser 是作业启动时生成并存进 checkpoint 的——所以同一个作业重启后能认出“自己提交过的 checkpoint”;另一个作业(不同 commitUser)则互不影响。
再加上 tryCommitOnce 第一步的幂等检查(提交过程中抛异常、不知道成没成功时,下一轮先扫描期间快照),两道保险一起实现 exactly-once。
五、两个容易误读的细节
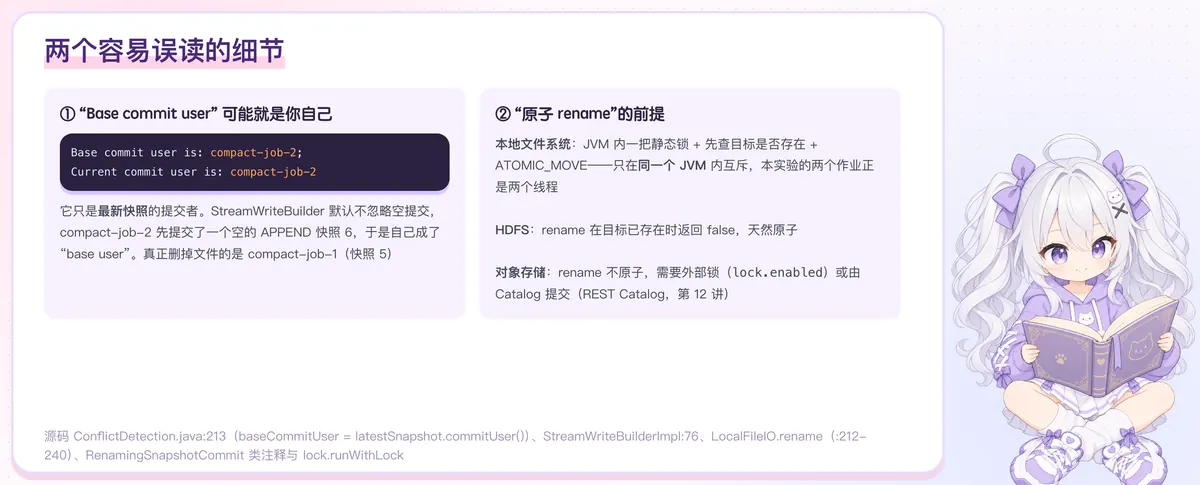
① 冲突信息里的 “Base commit user” 可能就是你自己。 场景 2 的异常里写着:
Base commit user is: compact-job-2; Current commit user is: compact-job-2教程里常说“base 和 current 不同说明有别的作业在写”,但这里两个都是 compact-job-2——因为 baseCommitUser 就是最新快照的提交者(ConflictDetection 第 213 行)。StreamWriteBuilder 的提交默认不忽略空提交(StreamWriteBuilderImpl 第 76 行 ignoreEmptyCommit(false)),compact-job-2 先提交了一个没有新文件的 APPEND 快照 6,紧接着它的 COMPACT 才检测出冲突,于是最新快照的作者正是它自己。真正删掉文件的,是快照 5 的 compact-job-1。排查冲突时,别只看这一行,要翻 $snapshots 看最近都是谁提交的。
同样的原因,场景 2 里每个合并作业都先产生一个空的 APPEND 快照(快照 4、6),再产生 COMPACT 快照:一次
commit里 APPEND 和 COMPACT 分开提交,APPEND 部分在ignoreEmptyCommit = false时即使为空也会生成快照(FileStoreCommitImpl.commit)。
② “原子 rename”的前提。 第 1 讲留了一个问题:rename 真的原子吗?看 RenamingSnapshotCommit 的类注释和各个 FileIO:
- 本地文件系统(
LocalFileIO.rename第 212~240 行):一把 JVM 内的静态锁 → 检查目标是否存在 →ATOMIC_MOVE。互斥只在同一个 JVM 内有效;本实验的两个“作业”正是同一 JVM 的两个线程。本地文件系统只适合开发测试; - HDFS:rename 在目标已存在时返回 false,类注释认为它是原子的;
- 对象存储:rename 不原子,需要外部锁(Catalog 配置
lock.enabled)——加锁后RenamingSnapshotCommit先检查exists再 rename;或者由 Catalog 负责提交(REST Catalog,第 12 讲)。
小结
| 情况 | 是否重试 | 结果 |
|---|---|---|
| 两个作业都只 APPEND | 是(抢号失败) | 全部成功 |
| 两个作业合并同一批文件 | 否 | File deletion conflict,作业 failover |
| 同一作业重启后重复提交 | — | 被 commitUser + identifier 过滤 |
| 提交时出异常、不确定成没成功 | 是 | 下一轮先做幂等检查 |
下一讲:读的时候,什么时候要归并、什么时候可以直接读?删除向量怎么帮忙?
自测题:把场景 2 改成“compact-job-1 合并 L0 文件 0、1,compact-job-2 合并 L0 文件 2,都输出到 L5”,第二个提交会成功吗?(答案:不会删到同一个文件,File deletion 检查能通过;但两个输出文件都在 L5,key 范围如果重叠,会被 PrimaryKeyConflictDetection 判为 LSM conflict。按源码推导,未单独运行。)