
踩坑实验室 #10:不开 Checkpoint,一次异常作业就结束了
Apache Flink 源码学习
作者 X老师(DaemonforY),Flink 2.3.0 源码,按 CC BY-NC-SA 4.0 发布。
基于 Flink 2.3.0 本机实测(核对日期 2026-10-02)。对应课程:第六讲《调度与容错》第三、四节。配套示例:
flink-notes/demos/src/main/java/study/scheduler/FailoverDemo.java
现象
很多人默认 Flink 会自动重启失败的作业。但本地调试时如果没开 Checkpoint,一个偶发的异常就会让作业直接结束,没有任何重试。补上一个重启策略之后,作业确实“活”了过来,可之前算出来的状态全没了,从 0 开始。
复现
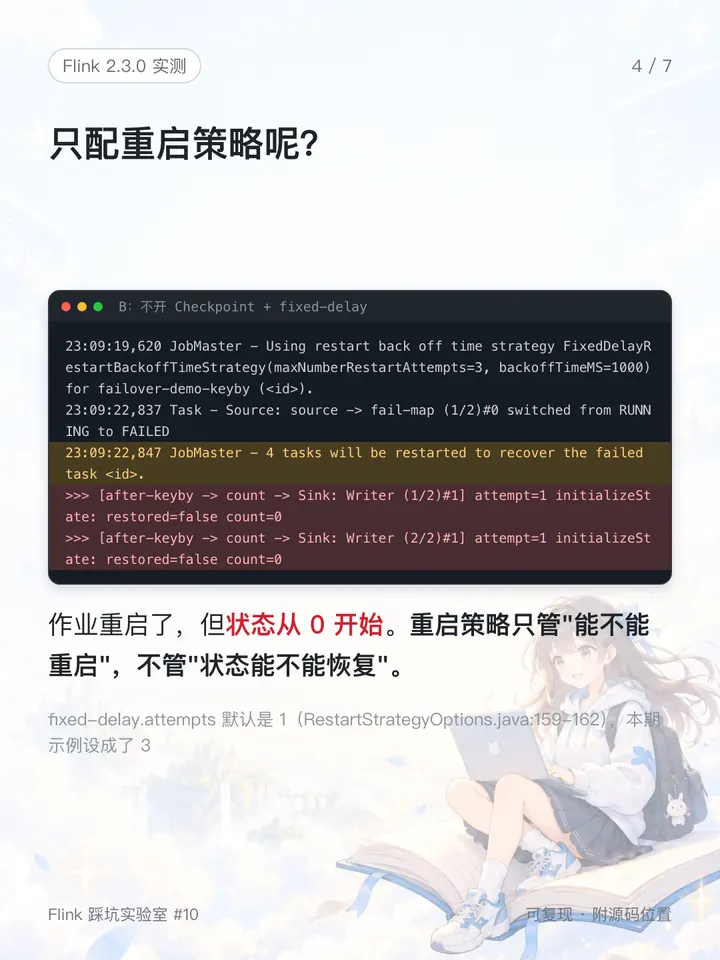
示例 FailoverDemo keyby,并行度 2。fail-map 的子任务 0 在前两次执行时各处理 3000 条后抛一次异常;count 用 operator state 记录处理过的条数,并在 initializeState 时打印。三次运行:
| 运行 | Checkpoint | 重启策略 |
|---|---|---|
| A | 不开 | 不配置(默认) |
| B | 不开 | fixed-delay,最多 3 次,间隔 1 秒 |
| C | 每 2 秒 | 不配置(默认) |
日志节选(ID 用 <id> 代替,省略了日志级别和线程名):
# A:不开 Checkpoint
23:09:13,253 JobMaster - Using restart back off time strategy NoRestartBackoffTimeStrategy for failover-demo-keyby (<id>).
23:09:16,494 Task - Source: source -> fail-map (1/2)#0 switched from RUNNING to FAILED
>>> cause: JobException: Recovery is suppressed by NoRestartBackoffTimeStrategy
>>> cause: RuntimeException: boom (attempt 0)

# B:不开 Checkpoint + fixed-delay
23:09:19,620 JobMaster - Using restart back off time strategy FixedDelayRestartBackoffTimeStrategy(maxNumberRestartAttempts=3, backoffTimeMS=1000) for failover-demo-keyby (<id>).
23:09:22,847 JobMaster - 4 tasks will be restarted to recover the failed task <id>.
>>> [after-keyby -> count -> Sink: Writer (1/2)#1] attempt=1 initializeState: restored=false count=0
>>> [after-keyby -> count -> Sink: Writer (2/2)#1] attempt=1 initializeState: restored=false count=0

# C:开 Checkpoint
23:09:48,099 JobMaster - Using restart back off time strategy ExponentialDelayRestartBackoffTimeStrategy(initialBackoffMS=1000, maxBackoffMS=60000, backoffMultiplier=1.5, ..., attemptsBeforeResetBackoff=2147483647, ...) for failover-demo-keyby (<id>).
23:09:51,328 JobMaster - 4 tasks will be restarted to recover the failed task <id>.
23:09:52,359 CheckpointCoordinator - Restoring job <id> from Checkpoint 2.
>>> [after-keyby -> count -> Sink: Writer (2/2)#1] attempt=1 initializeState: restored=true count=2308
>>> [after-keyby -> count -> Sink: Writer (1/2)#1] attempt=1 initializeState: restored=true count=1792| 运行 | 启动时的策略 | 结果 |
|---|---|---|
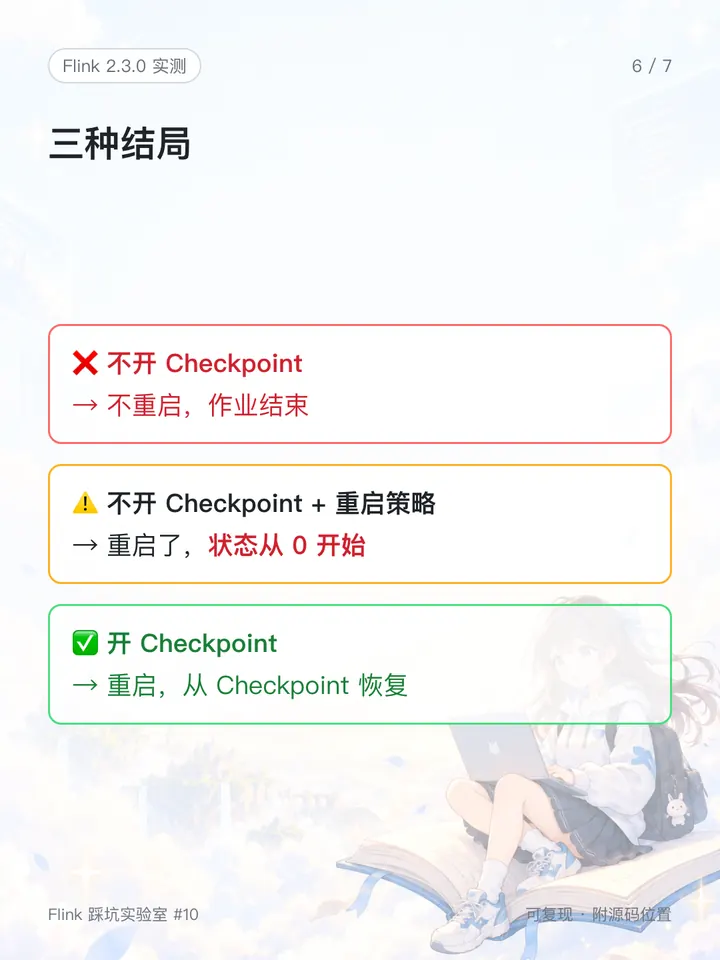
| A | NoRestartBackoffTimeStrategy | 第一次异常后作业结束 |
| B | FixedDelayRestartBackoffTimeStrategy | 4 个 Task 重启,但 restored=false count=0 |
| C | ExponentialDelayRestartBackoffTimeStrategy | 从 Checkpoint 2 恢复,count 接着 1792、2308 继续数 |
B 和 C 都重启了两次,第二次的情况和第一次相同;A 在写第六讲时也跑过两次,结果相同。
原因
没有配置 restart-strategy.type 时,默认的重启策略由是否开启 Checkpoint 决定(RestartBackoffTimeStrategyFactoryLoader.java:94-121,getDefaultRestartStrategyFactory):
- 开了 Checkpoint:默认
exponential-delay(指数退避),不限次数(:97),对应 C 日志里的attemptsBeforeResetBackoff=2147483647; - 没开 Checkpoint:默认不重启,即
NoRestartBackoffTimeStrategy(:118),一次失败作业就结束。
所以 A 在作业启动的那一刻就已经决定了“不重启”。这一点可以从 JobMaster 的启动日志直接看出来:Using restart back off time strategy ... 这一行会打印用的是哪种策略(DefaultSchedulerFactory.java:120)。
B 说明了另一件事:重启策略只决定“能不能重启”,状态能不能恢复要靠 Checkpoint。不开 Checkpoint 时,没有可以恢复的快照,重启后状态只能从 0 开始;C 开了 Checkpoint,重启后从最近一次完成的 Checkpoint 恢复。
怎么解决
需要容错的作业,开启 Checkpoint:既能自动重启,状态也能从 Checkpoint 恢复。
如果开了 Checkpoint,又希望“失败几次就停下来报警”,要自己配置重启策略,因为默认的指数退避是不限次数的。用 fixed-delay 时注意,restart-strategy.fixed-delay.attempts 默认只有 1 次(RestartStrategyOptions.java:159-162),本文示例显式设成了 3 次。
有两点不要误读。第一,本文只验证了算子状态是否恢复;不开 Checkpoint 重启后,Source 从哪里开始读取决于具体的连接器,这里没有验证。第二,开了 Checkpoint 也不等于不会丢数据,还要看 Source 能不能回退、Sink 是不是两阶段提交(见踩坑实验室 #06、#07)。
记住这几点
- 没配重启策略时:开了 Checkpoint,默认指数退避、不限次数;没开 Checkpoint,默认不重启。
- 重启策略管“能不能重启”,Checkpoint 管“状态能不能恢复”;只配重启策略,状态会从 0 开始。
- 启动日志里搜
Using restart back off time strategy,就能确认作业实际用的是哪种策略。