
踩坑实验室 #12:并行度随便改,maxParallelism 却改不了
Apache Flink 源码学习
作者 X老师(DaemonforY),Flink 2.3.0 源码,按 CC BY-NC-SA 4.0 发布。
基于 Flink 2.3.0 本机实测(核对日期 2026-10-03)。对应课程:第三讲(上)《State Backend 与扩缩容》第二节、第六节。配套示例:
flink-notes/demos/src/main/java/study/state/StateBackendDemo.java
现象
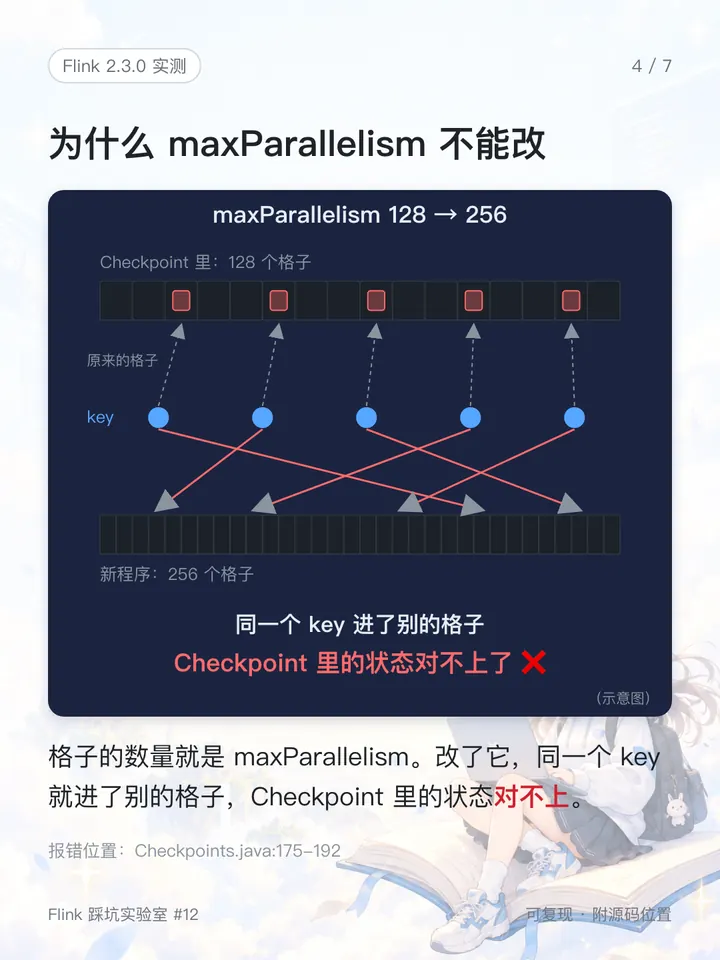
从 Checkpoint 恢复时,把并行度从 2 改成 3,状态一个不少;把 maxParallelism 从 128 改成 256,作业直接起不来。更隐蔽的是,从来没设置过 maxParallelism 的作业,平时看起来一切正常,直到某天业务量上涨、想把并行度调到 130 时,作业同样起不来。
复现
示例 StateBackendDemo:HashMap 状态后端,1000 个 key,每个 key 一个计数。每次先跑 22 秒生成 Checkpoint,再从 chk-5 恢复。maxParallelism 通过 -Dmaxp=N 设置,-1 表示不设置。四个实验:
| 实验 | 生成 Checkpoint 时 | 恢复时 | 结果 |
|---|---|---|---|
| 一 | 并行度 2,maxParallelism 128 | 并行度 3,maxParallelism 128 | 成功,1000 个 key 全部恢复 |
| 二 | 并行度 2,maxParallelism 128 | 并行度 2,maxParallelism 256 | 失败,起不来 |
| 三 | 并行度 2,maxParallelism 256 | 并行度 2,不设置 | 成功,实际生效的是 256 |
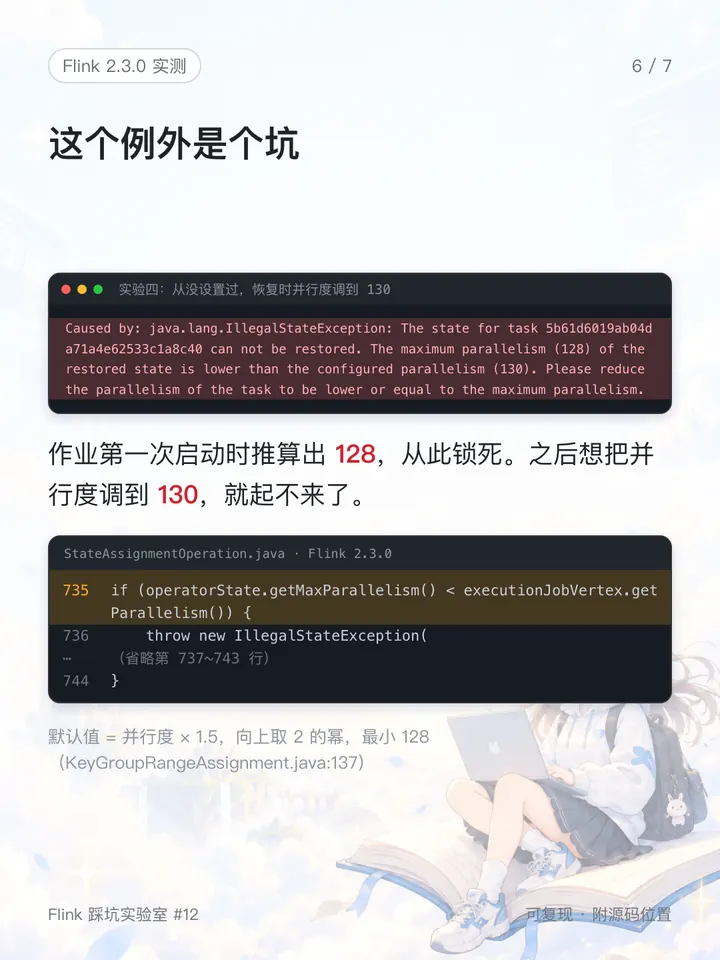
| 四 | 并行度 2,不设置(推算为 128) | 并行度 130,不设置 | 失败,起不来 |
输出节选:
# 实验一:并行度 2 → 3
>>> [count-per-key -> Sink: Writer (1/3)#0] maxParallelism=128 keyGroups=[0, 42] keys=359 restoredKeys=359 keysOutOfRange=0
>>> [count-per-key -> Sink: Writer (2/3)#0] maxParallelism=128 keyGroups=[43, 85] keys=311 restoredKeys=311 keysOutOfRange=0
>>> [count-per-key -> Sink: Writer (3/3)#0] maxParallelism=128 keyGroups=[86, 127] keys=330 restoredKeys=330 keysOutOfRange=0

# 实验二:maxParallelism 128 → 256
Max parallelism mismatch between checkpoint/savepoint state and new program. Cannot map operator 5b61d6019ab04da71a4e62533c1a8c40 with max parallelism 128 to new program with max parallelism 256. This indicates that the program has been changed in a non-compatible way after the checkpoint/savepoint.

# 实验三:Checkpoint 里是 256,恢复时不设置
>>> [count-per-key -> Sink: Writer (1/2)#0] maxParallelism=256 keyGroups=[0, 127] keys=494 restoredKeys=494 keysOutOfRange=0
>>> [count-per-key -> Sink: Writer (2/2)#0] maxParallelism=256 keyGroups=[128, 255] keys=506 restoredKeys=506 keysOutOfRange=0

# 实验四:从没设置过,恢复时并行度调到 130
The state for task 5b61d6019ab04da71a4e62533c1a8c40 can not be restored. The maximum parallelism (128) of the restored state is lower than the configured parallelism (130). Please reduce the parallelism of the task to be lower or equal to the maximum parallelism.
实验一到三在写第三讲上篇时跑过一次,这次的数字完全相同(359 / 311 / 330,494 / 506);实验四只跑了一次。
怎么读:实验一里三个子任务的 keyGroups 把 0~127 重新切成了三段,restoredKeys 等于 keys;实验三恢复时没设置,运行时打印的却是 maxParallelism=256;实验四报错里的 128,就是作业第一次启动时按并行度 2 推算出来的默认值。
原因
keyed state 的分配分两步:key 先按 maxParallelism 哈希到 KeyGroup,KeyGroup 再按连续区间分给子任务(KeyGroupRangeAssignment.java:76)。key 属于哪个 KeyGroup,只取决于 maxParallelism。
- 改并行度:KeyGroup 不变,只是重新分配给子任务,所以实验一能完整恢复;
- 改 maxParallelism:同一个 key 落进了不同的 KeyGroup,Checkpoint 里的状态对不上,于是报错(
Checkpoints.java:175-192)。
实验三是一个例外:没有显式设置时,Flink 推算出来的默认值会被 Checkpoint 里的值覆盖(SchedulerBase.java:357-377,autoConfigured),所以能恢复。默认值的推算规则是:并行度 × 1.5,向上取到 2 的幂,最小 128,最大 32768(KeyGroupRangeAssignment.java:137 起、:32、:35)。
这个例外恰恰是坑。从没设置过 maxParallelism 的作业,会一直沿用第一次启动时推算的那个数。实验四里,并行度 130 本来会推算出 256(130 × 1.5 = 195,向上取 2 的幂),但从 Checkpoint 恢复时被 Checkpoint 里的 128 覆盖了;并行度超过了 maxParallelism,状态无法分配(StateAssignmentOperation.java:730-745)。
怎么解决
作业上线第一天就显式设置 pipeline.max-parallelism(PipelineOptions.java:190),按未来可能的最大并行度留出余量。
需要注意几点:
- 并行度是可以改的,只要不超过 maxParallelism;不要因为这个坑就认为扩缩容不安全。
- “不设置最安全”恰恰相反:不设置会把值锁定在第一次启动时的推算值上。
- 也不是设得越大越好:maxParallelism 越大,KeyGroup 越多,元数据和管理开销越大。本文没有测量具体开销,只建议按未来可能的最大并行度留余量。
- 已经上线、确实要改 maxParallelism 的作业,可以考虑用 State Processor API 之类的办法重写状态,但本文没有验证,既不能说不可能,也不能说很简单。
本文只验证了 keyed state,结论不要外推到 operator state。
记住这几点
- key 属于哪个 KeyGroup 只取决于 maxParallelism:并行度可以改,maxParallelism 改了状态就对不上。
- 没显式设置时,maxParallelism 会沿用 Checkpoint 里的值,等于锁定在第一次启动时推算的数(并行度较小时是 128)。
- 上线第一天就设置
pipeline.max-parallelism,按未来可能的最大并行度留余量。