
S2 第 9 讲:Flink 写入——两阶段提交与 exactly-once
Apache Paimon 源码学习
作者 X老师(DaemonforY),Paimon 2.0 / master 源码,按 CC BY-NC-SA 4.0 发布。配套实验和代码在 GitHub。
TL;DR:第一季第八讲(下)讲过 Flink Sink V2 的两阶段提交:barrier 之前
prepareCommit,checkpoint 完成后commit,恢复时“一律再提交一次”,所以提交必须幂等。Paimon 的 Flink sink 是同一个形状,但没有实现 Sink V2 接口,而是自己搭了两个算子:Writer 在 barrier 之前把“这次新写的文件清单”发给全局唯一的 Committer,Committer 把它存进 checkpoint,checkpoint 完成后才生成快照,快照的 identifier 就是 checkpoint id。恢复时 Committer 把状态里的待提交内容再提交一遍,用 commitUser + identifier 过滤掉已经提交过的。实验:不开 checkpoint 的作业跑 10 秒,0 个快照;Append 表写 200 行、第 120 行抛异常,恢复后还是 200 行、200 个不同 id。
实验:三个场景
labs 新增的 SinkLab 用嵌入式 Flink 2.2.0 跑流作业:datagen 每秒 20 行,并行度 1,写一张没有主键的 Append 表——没有主键去重,数据重复会直接体现在行数上。
| 场景 | 做法 |
|---|---|
| ① checkpoint | 每 2 秒一次 checkpoint,写 1~100 |
| ② nockpt | 不开 checkpoint,无界数据源,跑 10 秒后取消 |
| ③ failover | 每 2 秒一次 checkpoint,写 1~200;一个 UDF 在第一次处理到 id = 120 时抛异常,fixed-delay 重启 |
一、两个阶段:identifier 就是 checkpoint id
场景 ①,Flink 的 checkpoint 日志和 Paimon 的提交日志交替出现(节选自 sink-2.0.0-flink2.2.log,省略了 job id 后面的统计):
08:00:15.942 INFO  [CheckpointCoordinator] Completed checkpoint 1 for job efc63e9c…
08:00:16.227 INFO  [FileStoreCommitImpl] Successfully commit snapshot 1 to table sk_ckpt by user 7809c009-6500-4715-ac37-30bac202019e with identifier 1 and kind APPEND.
08:00:17.416 INFO  [CheckpointCoordinator] Completed checkpoint 2 for job efc63e9c…
08:00:17.450 INFO  [FileStoreCommitImpl] Successfully commit snapshot 2 to table sk_ckpt by user 7809c009-6500-4715-ac37-30bac202019e with identifier 2 and kind APPEND.
08:00:19.091 INFO  [CheckpointCoordinator] Completed checkpoint 3 for job efc63e9c…
08:00:19.105 INFO  [FileStoreCommitImpl] Successfully commit snapshot 3 to table sk_ckpt by user 7809c009-6500-4715-ac37-30bac202019e with identifier 9223372036854775807 and kind APPEND.
sk_ckpt$snapshots 里三个快照分别是 40、40、20 行,合计 100(每个 checkpoint 写了多少行取决于时序,每次运行会不同)。规律是:每个 checkpoint 完成之后几十毫秒,提交一个 identifier 等于这个 checkpoint id 的快照。最后一次是输入结束后的 checkpoint,identifier 是 Long.MAX_VALUE——和 S1 第 1 期批作业的 identifier 一样,代表“输入结束”。
两个阶段在源码里是这样的:
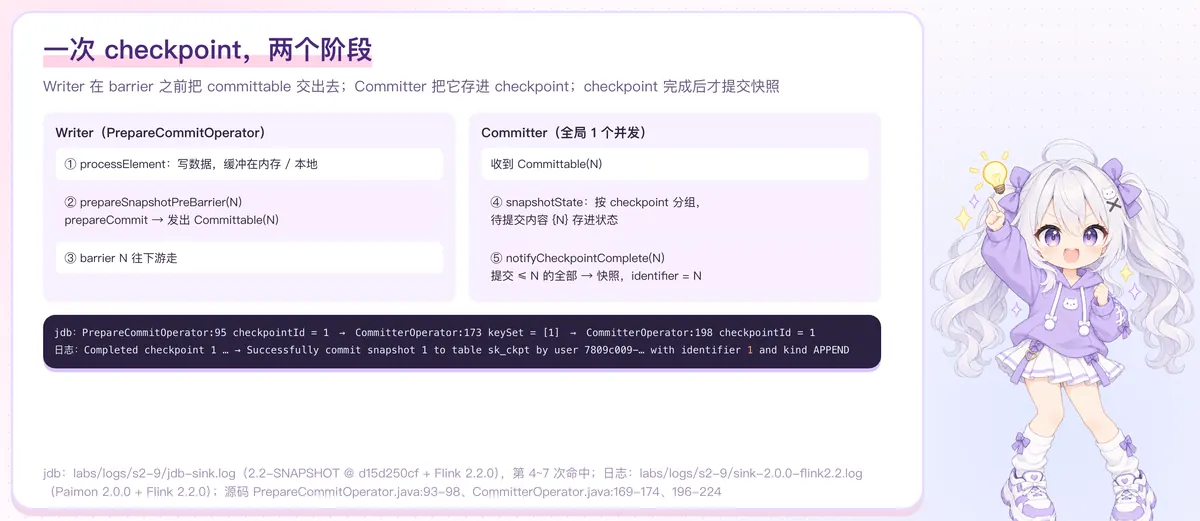
第一阶段,barrier 之前。 PrepareCommitOperator.prepareSnapshotPreBarrier(第 93~98 行):
public void prepareSnapshotPreBarrier(long checkpointId) throws Exception {
    if (!endOfInput) {
        emitCommittables(false, checkpointId);
    }
}
Writer 调 prepareCommit 把内存里的数据刷成文件(第 2 讲),每个 bucket 一条 CommitMessage,包成 Committable(checkpointId, message) 发给下游。因为在 barrier 之前发,Committer 一定先收到 checkpoint N 的 committable,再收到 barrier N。
Committer 做 checkpoint。 CommitterOperator.snapshotState(第 169~174 行)把收到的 committable 按 checkpoint 分组,合成一个 ManifestCommittable,identifier 就是 checkpoint id(StoreCommitter.combine,第 91~95 行),存进状态。到这里,“这次要提交哪些文件”已经随 checkpoint 持久化了。
第二阶段,checkpoint 完成之后。 CommitterOperator.notifyCheckpointComplete(第 196~199 行)→ commitUpToCheckpoint(第 201~224 行),把 ≤ N 的待提交内容一起提交:用 headMap(checkpointId, true) 而不是只提交 N,是因为 Flink 不保证每次完成通知都送达,N-1 的通知丢了,N 来的时候一起补上。
jdb 在三处下断点,场景 ③ 第一个 checkpoint 的顺序(jdb-sink.log 第 4~7 次命中):
#4/#5  PrepareCommitOperator:95     checkpointId = 1
#6     CommitterOperator:173        committablesPerCheckpoint.keySet() = [1]
#7     CommitterOperator:198        checkpointId = 1
(第 4、5 次是同一个断点在两个线程上各命中一次:这个作业里 PrepareCommitOperator 的子类不止一个,jdb 打印的线程名不同,未逐个区分是哪个算子。)
Committer 只有一个。 CommitterOperator.initializeState 第 119~123 行检查并行度必须为 1(“Committer Operator parallelism in paimon MUST be one.”)。同一张表的一次提交只生成一个快照,多个 committer 并发提交同一张表只会互相抢快照号(第 5 讲)。
另外,流作业对 checkpoint 有两条硬性要求(FlinkSink.java 第 316~327 行):必须是 EXACTLY_ONCE 模式,且不支持 unaligned checkpoint——committable 要靠对齐的 barrier 保证“在 N 的状态里收齐了 N 的所有文件”。
二、和第一季的 Sink V2 对照
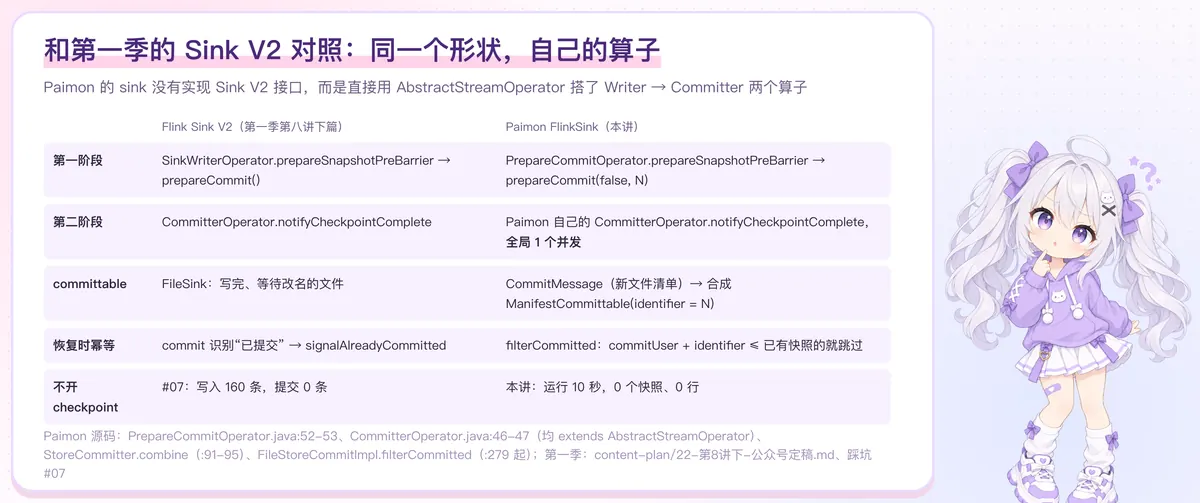
第一季第八讲(下)看的是 Flink 自带的 SinkWriterOperator / CommitterOperator。Paimon 的 PrepareCommitOperator(第 52~53 行)和 CommitterOperator(第 46~47 行)都是直接继承 AbstractStreamOperator 的普通算子,没有走 Sink V2 接口。形状一样,细节不同:
| Flink Sink V2(第一季) | Paimon FlinkSink(本讲) | |
|---|---|---|
| 第一阶段 | SinkWriterOperator.prepareSnapshotPreBarrier → prepareCommit() | PrepareCommitOperator.prepareSnapshotPreBarrier → prepareCommit(false, N) |
| 第二阶段 | CommitterOperator.notifyCheckpointComplete | Paimon 自己的 CommitterOperator.notifyCheckpointComplete,全局 1 个并发 |
| committable | FileSink:写完、等待改名的文件 | 新文件清单 CommitMessage → 合成 ManifestCommittable(identifier = N) |
| 恢复时幂等 | commit 识别“已提交”,signalAlreadyCommitted | filterCommitted:按 commitUser + identifier 跳过已提交的 |
| 不开 checkpoint | #07:写入 160 条,提交 0 条 | 本讲场景 ②:0 个快照、0 行 |
三、不开 checkpoint:作业一直在跑,表里一行都没有
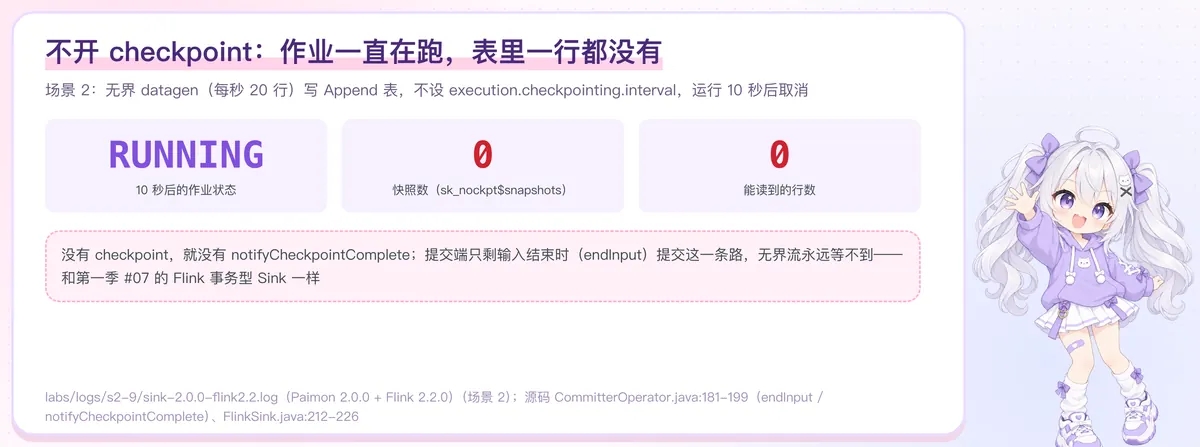
场景 ② 没有设 execution.checkpointing.interval,无界数据源每秒 20 行(节选):
[SinkLab] 运行 10 秒,作业状态:RUNNING,取消作业
Flink SQL> SELECT COUNT(*) AS snapshots FROM `sk_nockpt$snapshots`;
|                    0 |
Flink SQL> SELECT COUNT(*) AS cnt FROM sk_nockpt;
|                    0 |
作业一直是 RUNNING,没有报错,但 0 个快照、0 行,表目录下也没有任何数据文件。原因:没有 checkpoint 就没有 notifyCheckpointComplete;FlinkSink.doCommit 判断“流作业且开了 checkpoint”不成立(第 215~216 行),Committer 只剩输入结束时 endInput 提交这一条路(CommitterOperator.java:181-193)——无界流永远等不到。和第一季 #07 的结论一模一样。用 Paimon 做流式写入,checkpoint 不是可选项。
四、故障恢复:200 行写进去,200 行
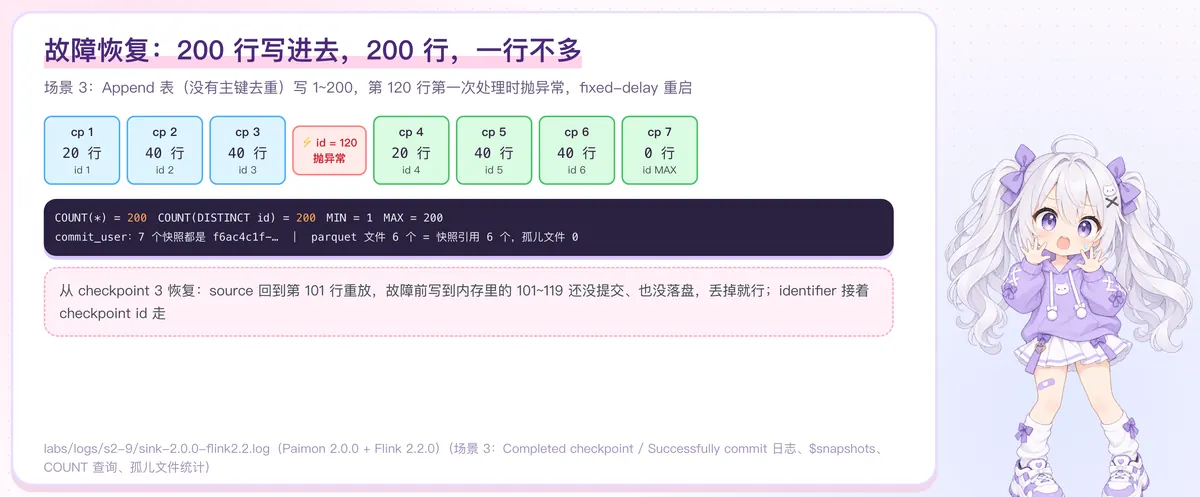
场景 ③ 的提交日志(节选):
… Successfully commit snapshot 1 … with identifier 1 and kind APPEND.
… Successfully commit snapshot 2 … with identifier 2 and kind APPEND.
… Successfully commit snapshot 3 … with identifier 3 and kind APPEND.
[SinkLab] 模拟故障:处理到 id = 120,抛出异常
… Successfully commit snapshot 4 … with identifier 4 and kind APPEND.
… Successfully commit snapshot 5 … with identifier 5 and kind APPEND.
… Successfully commit snapshot 6 … with identifier 6 and kind APPEND.
… Successfully commit snapshot 7 … with identifier 9223372036854775807 and kind APPEND.
7 个快照分别是 20、40、40、20、40、40、0 行,commit_user 全是 f6ac4c1f-…。最终:
Flink SQL> SELECT COUNT(*) AS cnt, COUNT(DISTINCT id) AS distinct_ids, MIN(id) AS min_id, MAX(id) AS max_id FROM sk_fail;
|                  200 |                  200 |                    1 |                  200 |
[SinkLab] sk_fail 目录下的 parquet 文件数:6,快照引用:6,孤儿文件:0
发生了什么:
- checkpoint 3 完成时,1~100 已经提交(20 + 40 + 40)。
- 101~119 写进了 Writer,但还没到下一个 checkpoint——没有 prepareCommit,就没有提交,这次甚至还没刷成文件(磁盘上 6 个文件,正好是 6 个有数据的快照引用的那 6 个)。
- 第 120 行抛异常,作业从 checkpoint 3 恢复:数据源回到 checkpoint 3 记录的位置,从 101 重放;Writer 不在状态里存数据,从最新快照重建文件视图(教程 08 章第 4 节)。
- checkpoint id 接着往下走(4、5、6),commit_user 从状态里读回来,保持不变——它是幂等判断的一半。
commitUser 为什么不能用 job id? CommitterOperator.initializeState 第 127~132 行的注释说得很清楚:用户可能做 savepoint、停作业、再从 savepoint 恢复,job id 会变;commitUser 第一次生成后存在 commit_user_state 里,以后从状态读。
最后那个 0 行的快照:流作业的 Committer 创建时 ignoreEmptyCommit(!streamingCheckpointEnabled)(FlinkWriteSink.java:60),开了 checkpoint 就不忽略空提交(FileStoreCommitImpl.java:341-344);输入结束后最后一个 checkpoint 没有新文件,也生成了一个快照。场景 ① 这次最后 20 行正好落在最后一个 checkpoint 里,所以那个快照不是空的。
五、恢复时,提交端先把“待提交”再提交一遍
第一季讲过 Flink 的规则:从 checkpoint N 恢复时,状态里“N 的快照时刻还没提交”的内容(包括 N 自己的)一律再提交一次。Paimon 也一样,RestoreCommittableStateManager.initializeState(第 60~74 行)把状态里的 committable 读出来交给 filterAndCommit:
// TableCommitImpl.filterAndCommitMultiple,第 319~333 行(节选)
List<ManifestCommittable> retryCommittables = commit.filterCommitted(sortedCommittables);
if (!retryCommittables.isEmpty()) {
    checkFilesExistence(retryCommittables);
    commitMultiple(retryCommittables, checkAppendFiles);
}
return retryCommittables.size();filterCommitted(FileStoreCommitImpl.java 第 279 行起,第 5 讲)按 commitUser 找这个作业最新的快照,identifier 不大于它的都跳过。这就是 exactly-once 里“不重”的那一半:同一个 checkpoint 的文件,无论恢复多少次,只会进一个快照。
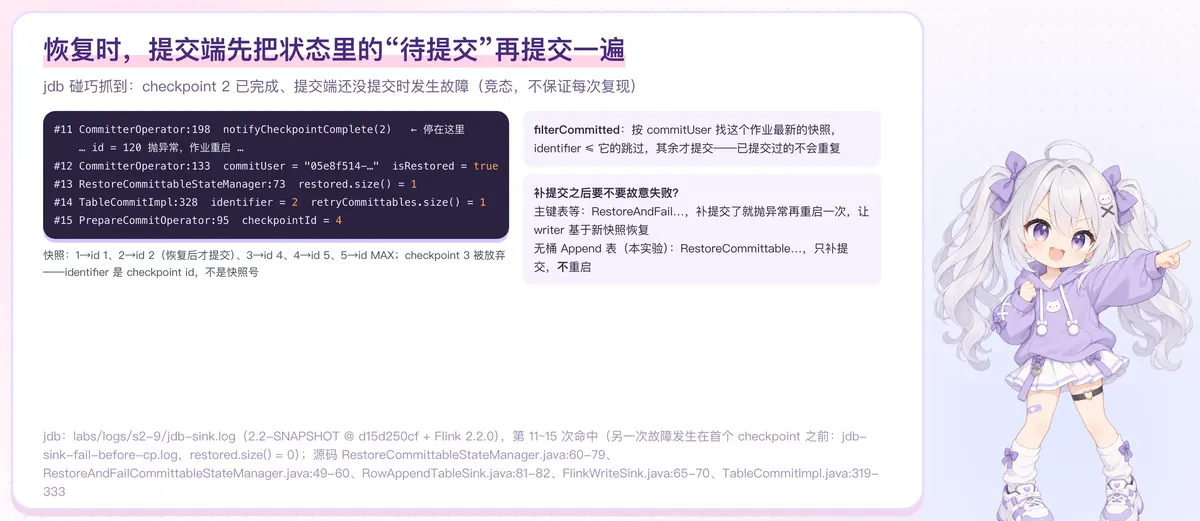
用 jdb 跑场景 ③(调试模式数据源降到每秒 5 行),这次碰巧抓到了最微妙的时机:checkpoint 2 已经完成,Committer 停在 notifyCheckpointComplete(2) 的断点上,还没提交,第 120 行就抛了异常(jdb-sink.log,整理成每行一次命中):
#11  CommitterOperator:198                   checkpointId = 2      ← 停在这里,还没提交
     … id = 120 抛异常,作业重启 …
#12  CommitterOperator:133                   commitUser = "05e8f514-…"   context.isRestored() = true
#13  RestoreCommittableStateManager:73       restored.size() = 1
#14  TableCommitImpl:328                     identifier = 2   retryCommittables.size() = 1
#15  PrepareCommitOperator:95                checkpointId = 4
恢复后状态里有 1 个待提交内容,identifier 2;filterCommitted 发现这个作业还没有 identifier ≥ 2 的快照,于是真的补提交了它——日志里 identifier 2 的快照是在故障之后才出现的。checkpoint 3 因为故障被放弃,后面的快照是 identifier 4、5,最终 $snapshots 是:快照 1→id 1、2→id 2、3→id 4、4→id 5、5→id MAX。identifier 是 checkpoint id,不是快照号,所以会跳号。最终仍是 200 行、200 个不同 id。
这个时机是竞态(断点让 Committer 停住的那几秒里,数据源恰好处理到第 120 行),不保证每次复现。另一次 jdb 运行里,断点把第一个 checkpoint 拖到了 6 秒多,故障发生在任何 checkpoint 完成之前:恢复时 isRestored = false、restored.size() = 0,作业从头重跑,结果同样是 200 行(jdb-sink-fail-before-cp.log)。
补提交之后,要不要故意失败一次? 教程 08 章原来写的是“补提交了就故意抛异常再重启一次”。这次实验里 Append 表补提交之后,作业没有再重启(RestoreAndFailCommittableStateManager 的断点一次都没命中)。查源码:
FlinkWriteSink默认用RestoreAndFailCommittableStateManager(第 65~70 行):补提交了(numCommitted > 0)就抛出 “This exception is intentionally thrown after committing the restored checkpoints…”(第 49~60 行),再重启一次,让 Writer 基于新快照恢复文件视图——主键表的 Writer 要接着做合并,用过期的视图会冲突。- 无桶 Append 表(
RowAppendTableSink.java:81-82)和 postpone bucket 表用RestoreCommittableStateManager:只补提交,不故意失败。
教程已更正,记入 勘误.md(2026-10-05)。主键表的“故意失败”这次没有实验,只有源码依据。
小结
| 故障时刻 | 结果 | 本讲证据 |
|---|---|---|
| 任何 checkpoint 完成之前 | 从头重放,没提交过任何东西 | jdb 第一次运行 |
| checkpoint N 完成、提交之前 | 恢复时补提交 N;主键表再故意失败一次 | jdb 第二次运行(Append 表,未故意失败) |
| checkpoint N 已提交之后 | 恢复时状态里的 N 被 filterCommitted 跳过;N 之后没提交的数据重放 | 场景 ③ |
| 不开 checkpoint 的无界流 | 永远不提交 | 场景 ② |
下一讲:读的那一侧——Flink 流读 Paimon 时,Enumerator 怎么按快照生成 split、consumer-id 怎么记住读到哪了(回扣第一季第八讲上篇)。
自测题:场景 ③ 如果把表换成主键表、故障时机和 jdb 第二次运行一样(checkpoint 2 完成、未提交),作业会重启几次?为什么最终行数仍然正确?(答案:恢复时补提交 identifier 2,RestoreAndFail… 故意抛异常,再重启一次——共两次;第二次恢复时 identifier 2 已在快照里,被 filterCommitted 跳过,不再失败。主键表即使重复写入同一个 key 也会去重,所以行数掩盖不了重复——这正是本讲用 Append 表做实验的原因。按源码推导,未单独运行。)