
踩坑实验室 #15:背压最严重的算子,往往不是瓶颈
Apache Flink 源码学习
作者 X老师(DaemonforY),Flink 2.3.0 源码,按 CC BY-NC-SA 4.0 发布。
基于 Flink 2.3.0 本机实测(核对日期 2026-10-03)。对应课程:第四讲《网络栈与背压》第四~六节。配套示例:
flink-notes/demos/src/main/java/study/network/BackpressureChainDemo.java
现象
作业变慢时,最直接的做法是去看各个算子的背压指标,然后盯着数值最高的那个去优化。这个直觉经常是错的:在下面的实验里,背压最严重的算子 backPressuredTimeMsPerSecond 一直是 1000,但它并不是瓶颈;真正的瓶颈,背压是 0。
复现
示例 BackpressureChainDemo:并行度 1,五个算子之间都调用了 disableChaining(),让数据走网络缓冲区;MiniCluster 启动 2 个 TaskManager。
source(每秒 5000 条)→ map-a → map-b → slow-map(slow 模式每条 sleep 1ms)→ sink每 10 秒通过 REST 接口打印每个算子的 backPressuredTimeMsPerSecond、busyTimeMsPerSecond、idleTimeMsPerSecond。
normal 模式下 slow-map 不 sleep,第 10、20、30 秒三次输出完全一样:五个算子都是 backPressured=0、busy=0.0、idle=1000,每秒 5000 条对它们来说太轻松了。
slow 模式下,只让 slow-map 每条数据 sleep 1ms:
>>> t=10s
>>>   Source: source                            0      0.0     1000
>>>   map-a                                   548      0.0     1000
>>>   map-b                                  1000      0.0      648
>>>   slow-map                                  0    950.0       50
>>>   sink: Writer                              0      0.0     1000
>>> t=20s
>>>   Source: source                            0      0.0     1000
>>>   map-a                                   849      0.0      437
>>>   map-b                                  1000      0.0      216
>>>   slow-map                                  0    984.0       16
>>>   sink: Writer                              0      0.0     1000
>>> t=30s
>>>   Source: source                          774      0.0      365
>>>   map-a                                   910      0.0      262
>>>   map-b                                  1000      0.0      129
>>>   slow-map                                  0    990.0       10
>>>   sink: Writer                              0      0.0     1000
(三列依次是 backPressured、busy、idle。)只看 backPressured 一列:
| 时刻 | Source | map-a | map-b | slow-map |
|---|---|---|---|---|
| 10s | 0 | 548 | 1000 | 0 |
| 20s | 0 | 849 | 1000 | 0 |
| 30s | 774 | 910 | 1000 | 0 |
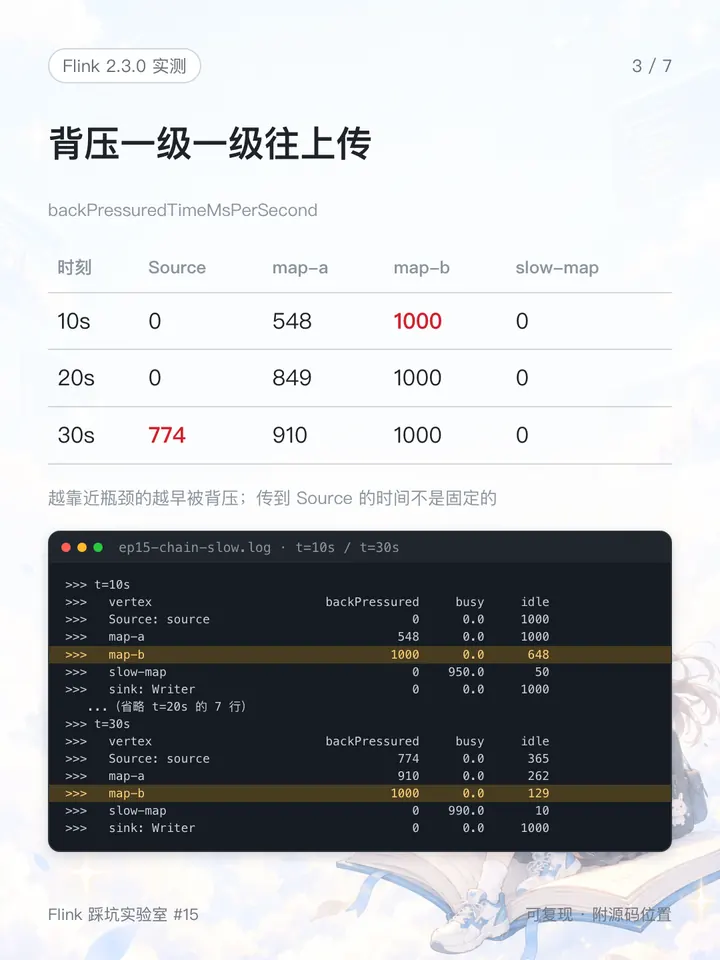
这个示例的 slow 模式只跑了一次。背压传到 Source 的具体时间取决于缓冲区大小和数据大小,"第 30 秒"不是固定值;不变的是顺序:越靠近瓶颈的算子越早被背压。
原因
每个 Task 的每一秒被分成三部分:idle(没有输入可处理)、backPressured(输出被阻塞)、busy(在处理数据)。其中 busy 不是测出来的,而是算出来的:1000 − min(idle + backPressured, 1000)(TaskIOMetricGroup.java:281-284)。
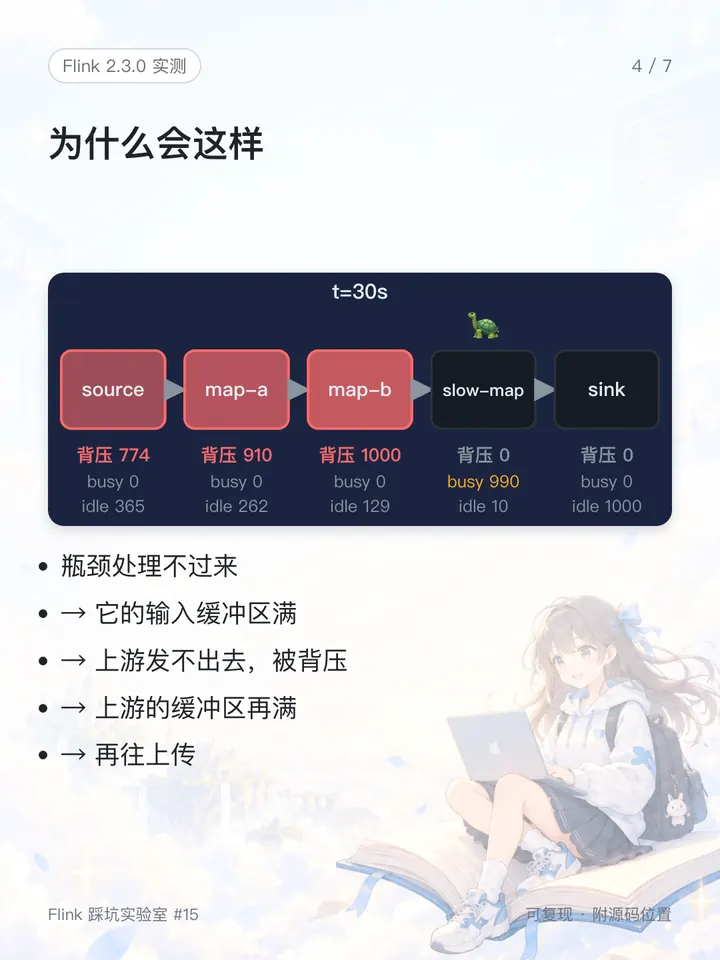
背压的传导方式是:slow-map 处理不过来,它的输入缓冲区先满;紧挨着它的上游 map-b 发不出数据,被背压;map-b 的缓冲区再满,又堵住 map-a,最后才轮到 Source。所以背压是从瓶颈开始、一级一级往上游传的,需要时间:map-b 在第 10 秒已经是 1000,Source 到第 30 秒才明显。
瓶颈本身的输出没有被阻塞,所以 slow-map 的 backPressured 始终是 0,但它的 busy 在 950~990 之间,一直在干活。它下游的 sink 数据来得慢,idle=1000。背压最严重的 map-b 只是离瓶颈最近、最先被堵住的那个上游。
表里还有一个看起来"对不上"的地方:t=10s 时 map-a 的 backPressured=548、idle=1000,加起来超过了 1000,busy 显示为 0。公式里的 Math.min 做了截断,所以三项之和不一定等于 1000。至于两个指标为什么会重叠,是按代码推断的:它们是两个独立统计的计时器。
怎么解决
定位瓶颈的方法:沿着数据流从上往下看 backPressured,找到第一个不被背压、但 busy 很高的算子,它就是瓶颈。本例中 backPressured 一列是 0 → 548 → 1000 → 0,最后一个不为 0 的是 map-b,它下面的 slow-map 背压为 0、busy 接近 1000。
几点注意:
- 看到 Source 被背压,说明它下游某处处理不过来,而不是 Source 本身有问题;
- 如果瓶颈和上下游链在同一个 Task 里,指标是整个 Task 的,分不出是哪个算子慢,可以临时用
disableChaining()拆开再看; - 本文只看了 REST 接口返回的数值,没有核对 Web UI 的颜色规则;
- 不要用三项之和是否等于 1000 去判断指标对不对,
busy是算出来的,并且有截断。
记住这几点
- 背压最严重的算子,通常是离瓶颈最近的上游,不是瓶颈本身。
- 瓶颈的特征是:不被背压,但很忙;它的下游很闲。
- 背压一级一级往上传、需要时间,传到 Source 的时刻不固定,但顺序不变。