
踩坑实验室 #17:6 条数据,print 出来 9 行,-U +U 是什么?
Apache Flink 源码学习
作者 X老师(DaemonforY),Flink 2.3.0 源码,按 CC BY-NC-SA 4.0 发布。
基于 Flink 2.3.0 本机实测(核对日期 2026-10-03)。对应课程:第五讲(下)《Changelog,同一个 GROUP BY 为什么有时输出两条》。配套示例:
flink-notes/demos/src/main/java/study/sql/SqlDemo.java(changelog [minibatch]、sinks模式)
现象
一条最简单的 GROUP BY 计数,输入 6 条数据,写进 print 表后打印出了 9 行,每行前面还带着 +I、-U、+U 这样的前缀。同一个 key 出现了好几次,看起来像是重复数据。
复现
固定输入 6 条:a a b a c b,并行度 1。
SELECT word, COUNT(*) AS cnt FROM words GROUP BY word        -- Q1
SELECT cnt, COUNT(*) AS num_words FROM (Q1) GROUP BY cnt     -- Q2:统计"出现了 cnt 次的单词有几个"
SqlDemo print 把 Q1 INSERT INTO 一张 'connector' = 'print' 的表,输出:
+I[a, 1]
-U[a, 1]
+U[a, 2]
+I[b, 1]
-U[a, 2]
+U[a, 3]
+I[c, 1]
-U[b, 1]
+U[b, 2]逐行读:+I[a, 1] 是 a 第一次出现,计数 1;-U[a, 1] +U[a, 2] 是 a 又来了,先撤回"a 是 1",再告诉你"a 是 2"。每个 key 最后一条 +I 或 +U 才是当前结果:a=3、b=2、c=1。
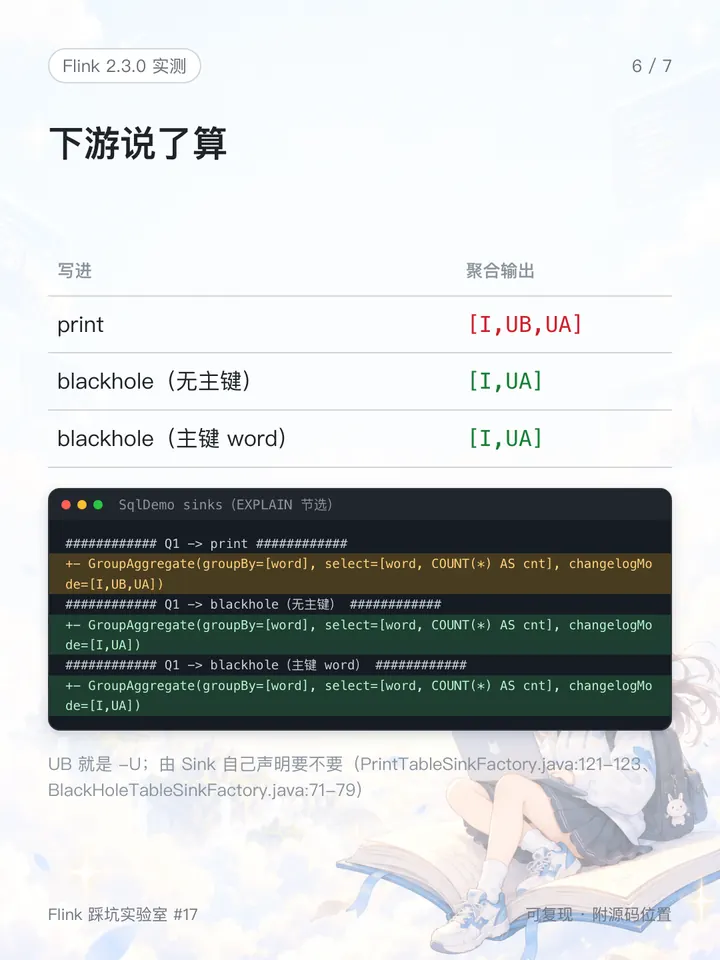
同一条 Q1 写进不同的表,EXPLAIN 里聚合的 changelogMode(SqlDemo sinks):
| 写进 | 聚合输出 |
|---|---|
print | [I,UB,UA](有 -U) |
blackhole(无主键) | [I,UA](没有 -U) |
blackhole(主键 word) | [I,UA] |
开启 MiniBatch 后再跑 Q1(SqlDemo changelog minibatch),只剩 3 行:
+I[b, 2]
+I[a, 3]
+I[c, 1]输入是固定的,结果可复现:changelog、sinks 和 MiniBatch 的输出与第五讲下篇写作时逐行相同;print 模式是新做的,结果和 toChangelogStream 打印的完全一致。
原因
Flink SQL 的结果是一张会变化的表,每次变化用一条带类型的消息表示:+I 新增、-U 撤回旧值、+U 新值、-D 删除(RowKind.java:31-52)。print 打印的前缀就是这个类型,Row.toString() 会先拼上 RowKind.shortString()(RowUtils.java:163;PrintTableSinkFactory.java:187-189)。并行度大于 1 时,print 还会在前面加子任务编号,比如 2> (PrintSinkOutputWriter.java:55-70)。
GROUP BY 的结果中,一个 key 第一次出现发 +I,之后每次变化发一对 -U / +U,所以 6 条输入变成 9 行输出:这是 changelog,不是重复。
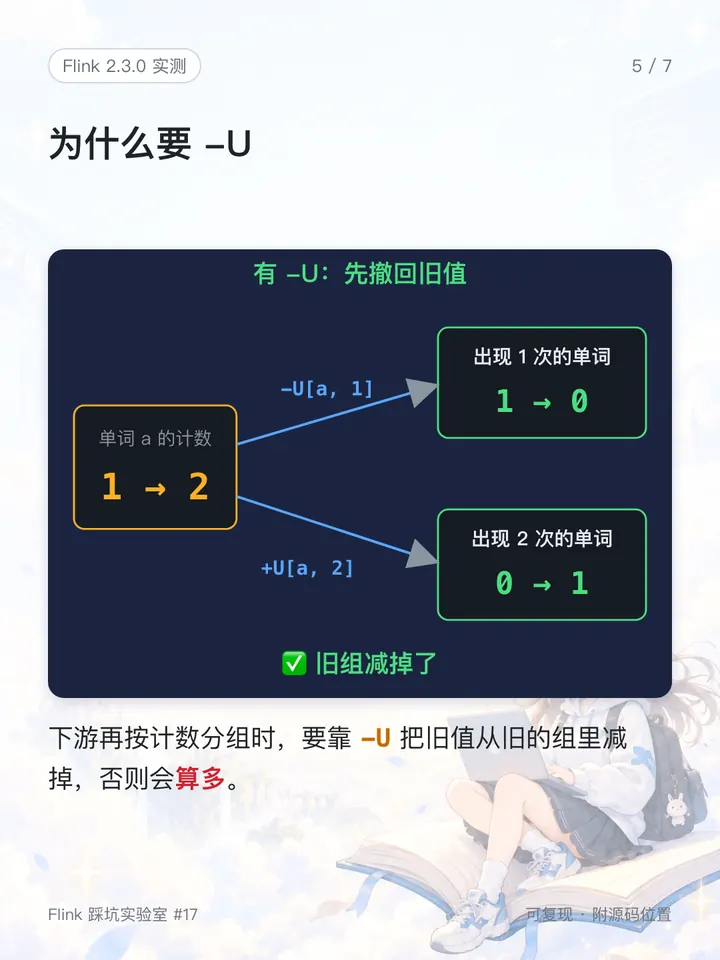
-U 的用处在嵌套聚合里最明显。Q2 按计数再分组,a 从 1 变成 2 时,下游需要知道旧值,才能把 a 从"出现 1 次"那一组里减掉;如果没有 -U,"出现 1 次"那一组就减不掉,最后会算多。Q2 外层的实测输出:
+I[1, 1]
-D[1, 1]
+I[2, 1]
+I[1, 1]
-D[2, 1]
+I[3, 1]
-U[1, 1]
+U[1, 2]
-U[1, 2]
+U[1, 1]
+I[2, 1]
其中的 -D[1, 1] 是计数被撤回到 0 时发出的删除(GroupAggHelper.java:138-145)。
要不要发 -U,由下游的 Sink 决定:Sink 声明自己需要什么。print 原样返回请求的模式,所以带 -U(PrintTableSinkFactory.java:121-123);blackhole 声明不要 -U(BlackHoleTableSinkFactory.java:71-79)。声明不要 -U 的 Sink 如果有主键,主键还要和查询的 upsert key 对得上,否则会退回到带 -U(FlinkChangelogModeInferenceProgram.scala:1012-1020)。
MiniBatch 输出变少,是因为同一批里的多次变化会被合并(MiniBatchGroupAggFunction.java:163 起)。
怎么解决
-U 不是需要"修掉"的问题,关键是正确消费它:
- 读结果时,以每个 key 最后一条
+I/+U为准; - 如果下游不需要撤回消息,选用声明了不要
-U的 Sink;有主键时,确认主键和查询的 upsert key 对得上; - 想减少中间变化,可以开启 MiniBatch。
几点注意:
- 主键本身不决定会不会收到
-U,要看 Sink 声明的模式;按源码,print即使有主键也会要-U(这一点本文没有单独实测); - 本例 MiniBatch 只剩 3 行,是因为 6 条数据一批就处理完了,真实场景下跨批次照样会有
-U/+U,只是少很多; - 本文只验证了
print和blackhole两个内置连接器,Kafka、JDBC 等外部连接器如何处理-U,要看各自的文档和实现。
记住这几点
-U不是重复数据,是撤回旧值,嵌套聚合等场景必须靠它。- 每个 key 最后一条
+I/+U才是当前结果。 - 要不要
-U由下游 Sink 声明的模式决定,开启 MiniBatch 可以合并同一批里的变化。