
S2 第 7 讲:删除向量——把“读时去重”变成“写时标记”
Apache Paimon 源码学习
作者 X老师(DaemonforY),Paimon 2.0 / master 源码,按 CC BY-NC-SA 4.0 发布。配套实验和代码在 GitHub。
TL;DR:默认的主键表把同一个 key 的多个版本留到读的时候归并去重(第 6 讲)。开启
deletion-vectors.enabled后,写入时 L0 文件上推,会到高层查(lookup)同一个 key 的旧版本,把它“在哪个文件的第几行”记进一个位图——删除向量。于是 L1 及以上的文件,套上删除向量后每个 key 只剩一条存活记录,读的时候直接读、按位图跳过即可,value 过滤可以全部下推,COUNT(*) 可以只看元数据。代价:写入要 lookup;批读要跳过还没上推的 L0,数据在合并前不可见。
实验:同样三次写入,两张表
labs/sql/lab09/deletion-vectors.sql 建两张 bucket = 1 的主键表,只差 'deletion-vectors.enabled' = 'true',做同样三件事:
- 写 key 1~100(v = 'a')
- 更新 key 51~60(v = 'b')
DELETE WHERE k = 5
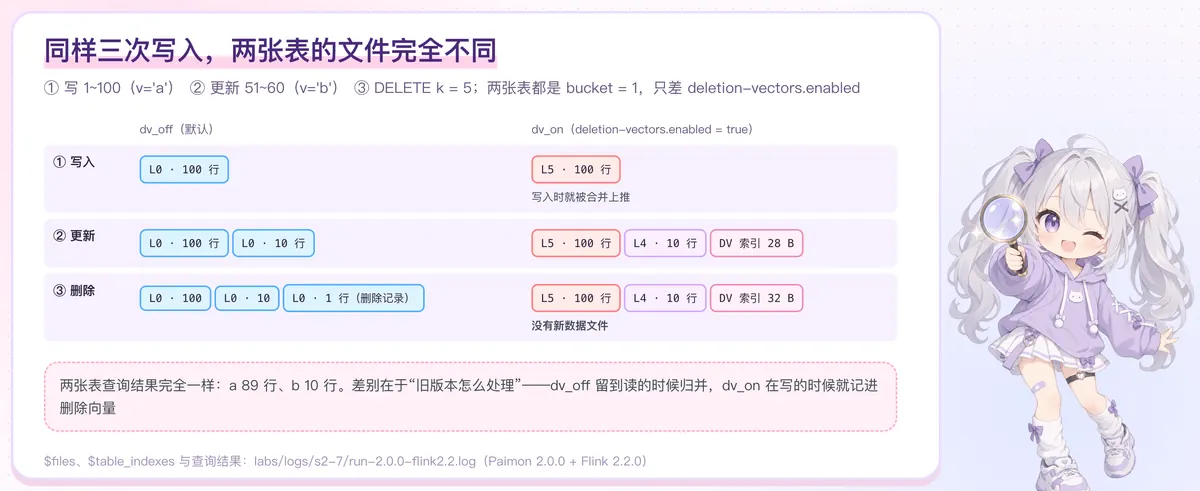
每一步后查 $files 和 $table_indexes(Paimon 2.0.0):
| 步骤 | dv_off(默认) | dv_on(删除向量) |
|---|---|---|
| ① 写入 | L0 · 100 行 | L5 · 100 行 |
| ② 更新 | L0 · 100、L0 · 10 | L5 · 100、L4 · 10;DV 索引文件 28 B |
| ③ 删除 | L0 · 100、L0 · 10、L0 · 1(删除记录) | L5 · 100、L4 · 10;DV 索引文件 32 B,没有新数据文件 |
两张表的查询结果完全一样:a 89 行、b 10 行(100 − 10 被更新 − 1 被删除 = 89)。区别全在“旧版本怎么处理”。
几个一眼能看到的现象:
- dv_on 第一次写就到了 L5:开启删除向量后,表需要 lookup(
CoreOptions.lookupStrategy把deletionVectorsEnabled算进去),合并策略换成ForceUpLevel0Compaction——每次提交都把 L0 推上去(第 3 讲提过)。 - dv_on 删除一行,没有新数据文件,只是 DV 文件从 28 字节变成 32 字节。
一、写时标记:lookup 找到旧版本,记下“文件名 + 行号”
在 LookupChangelogMergeFunctionWrapper 第 126 行下断点(jdb/s2-7-deletion-vectors.txt):
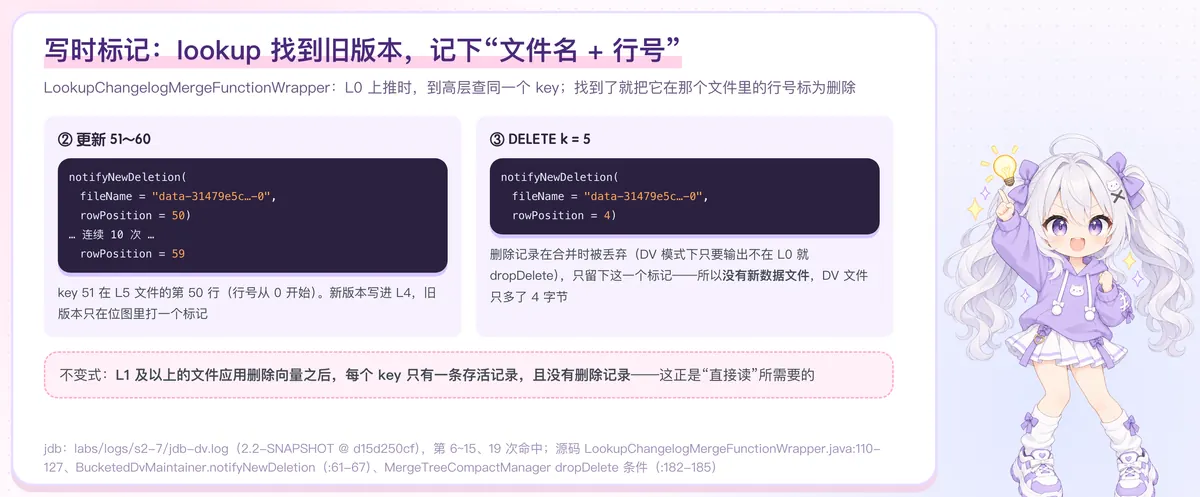
cd labs && PAIMON_VERSION=2.2-SNAPSHOT ./jdb-stacks.sh sql/lab09/deletion-vectors.sql jdb/s2-7-deletion-vectors.txt 300② 更新 51~60 时,连续命中 10 次:
notifyNewDeletion(fileName = "data-31479e5c…-0", rowPosition = 50)
notifyNewDeletion(fileName = "data-31479e5c…-0", rowPosition = 51)
…
notifyNewDeletion(fileName = "data-31479e5c…-0", rowPosition = 59)
key 51 在那个 L5 文件的第 50 行(行号从 0 开始)。源码(第 110~127 行):
if (highLevel == null) {
    T lookupResult = lookup.apply(mergeFunction.key());   // 到高层查同一个 key
    if (lookupResult != null) {
        if (lookupStrategy.deletionVector) {
            ...fileName / rowPosition 来自 lookup 结果...
            deletionVectorsMaintainer.notifyNewDeletion(fileName, rowPosition);
        }
...BucketedDvMaintainer.notifyNewDeletion(第 61~67 行)把这个行号加进该文件对应的位图。新版本写进 L4,旧版本一个字节都没改,只是被标记了。
③ DELETE k = 5 时,命中 1 次:
notifyNewDeletion(fileName = "data-31479e5c…-0", rowPosition = 4)删除记录本身呢?MergeTreeCompactManager 第 182~185 行计算 dropDelete 时有一个条件 || dvMaintainer != null:DV 模式下只要输出不在 L0,删除记录就丢弃。所以 DELETE 最后只剩一个位图标记,没有新的数据文件。
这样维护出一个不变式:
L1 及以上的文件,应用删除向量之后,每个 key 只有一条存活记录,且没有删除记录。
二、读的时候:一个要归并,一个直接读
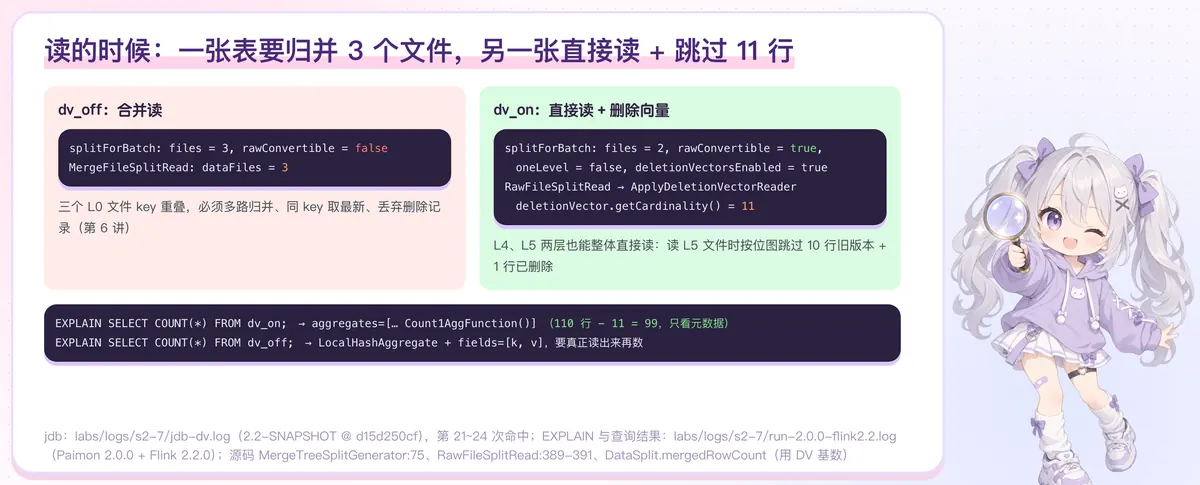
SELECT v, COUNT(*) … GROUP BY v(第 6 讲解释过为什么用 GROUP BY),jdb:
dv_off  splitForBatch: files = 3, rawConvertible = false, oneLevel = true,  deletionVectorsEnabled = false
        MergeFileSplitRead: dataFiles = 3                       ← 合并读
dv_on   splitForBatch: files = 2, rawConvertible = true,  oneLevel = false, deletionVectorsEnabled = true
        RawFileSplitRead → ApplyDeletionVectorReader
        deletionVector.getCardinality() = 11                    ← 直接读 + 跳过 11 行
注意 dv_on 的 oneLevel = false(L4、L5 两层),按第 6 讲的规则本来不能整体直接读——是 splitForBatch 第 75 行的 deletionVectorsEnabled || 让它通过了。因为不变式保证了跨层也不会有重复存活的 key。
读 L5 文件时,RawFileSplitRead 第 389~391 行套上 ApplyDeletionVectorReader,按位图跳过 11 行(10 个被更新的旧版本 + 1 个被删除的)。
COUNT(*) 也能下推了:
EXPLAIN SELECT COUNT(*) FROM dv_on;
  +- TableSourceScan(table=[[paimon, default, dv_on,
       aggregates=[grouping=[], aggFunctions=[Count1AggFunction()]]]], fields=[count1$0])
                                                       → 只看元数据,结果 99
EXPLAIN SELECT COUNT(*) FROM dv_off;
  +- LocalHashAggregate(select=[Partial_COUNT(*) AS count1$0])
     +- TableSourceScan(table=[[paimon, default, dv_off]], fields=[k, v])
                                                       → 要真读再数
(节选自 Flink 2.2.0 的 Optimized Execution Plan,省略了上层的 HashAggregate / Exchange;Flink 1.20.1 上 dv_off 写作 project=[k],结论相同。)
DataSplit.mergedRowCount 在有删除文件时用“文件行数 − 删除向量基数”:110 − 11 = 99,一个数据文件都不用打开。
另外,DV 模式下批扫描会调用 enableValueFilter()(AbstractBatchTableScan 第 81 行)——每个 key 只有一条存活记录,按 value 统计跳过整个文件也是安全的,这是第 6 讲“重叠 section 只能下推主键过滤”问题的解法。
三、代价:L0 在合并之前不可见
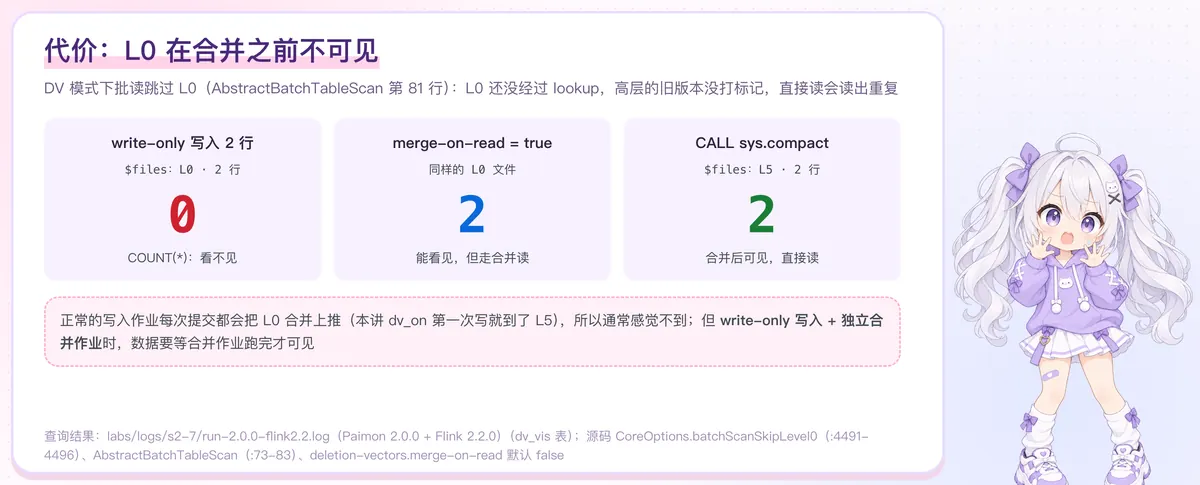
为了让不变式成立,批读必须跳过 L0:L0 还没经过 lookup,高层的旧版本没被标记,直接读会读出重复。CoreOptions.batchScanSkipLevel0()(第 4491~4496 行):DV 开启且 deletion-vectors.merge-on-read = false(默认)时跳过 L0。
实验:一张 DV 表设 write-only = true(只写不合并),写 2 行:
$files:L0 · 2 行
SELECT COUNT(*)                                     → 0      ← 看不见
SELECT COUNT(*) /*+ merge-on-read = true */         → 2      ← 能看见,但走合并读
CALL sys.compact(...);  $files:L5 · 2 行
SELECT COUNT(*)                                     → 2      ← 合并后可见
正常的写入作业每次提交都会把 L0 推上去(dv_on 第一次写就到了 L5),所以通常感觉不到。但如果采用第 5 讲推荐的“写入作业 write-only + 独立合并作业”,数据要等合并作业跑完才可见——这是开 DV 时要特别留意的组合。
另一个代价是写入:每次 L0 上推都要到高层 lookup,需要本地 lookup 缓存和额外 IO。本讲没有做压测,只指出这个成本存在。
四、权衡
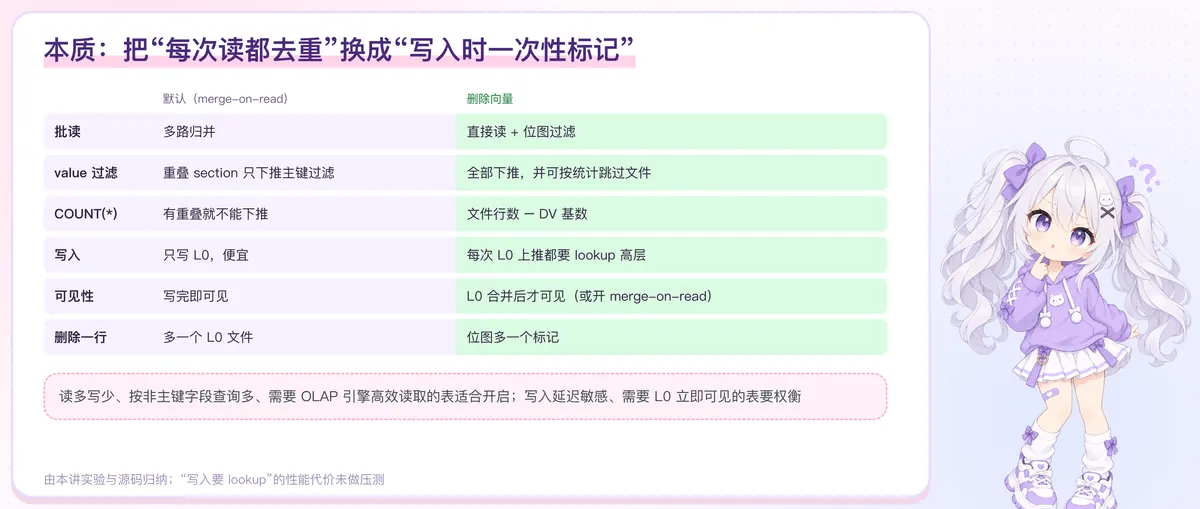
| 默认(merge-on-read) | 删除向量 | |
|---|---|---|
| 批读 | 多路归并 | 直接读 + 位图过滤 |
| value 过滤 | 重叠 section 只下推主键过滤 | 全部下推,并可按统计跳过文件 |
| COUNT(*) | 有重叠就不能下推 | 文件行数 − DV 基数 |
| 写入 | 只写 L0 | 每次 L0 上推都要 lookup |
| 可见性 | 写完即可见 | L0 合并后才可见(或开 merge-on-read) |
| 删除一行 | 多一个 L0 文件 | 位图多一个标记 |
本质:把“每次读都去重”换成“写入时一次性标记”。读多写少、按非主键字段过滤多、需要 OLAP 引擎(Spark、StarRocks 等)高效读取的表适合开启;写入延迟敏感、需要 L0 立即可见的场景要权衡。
下一讲:同样的 lookup,还能顺便算出 changelog 的 -U / +U——Lookup Changelog。
自测题:dv_on 如果再把 key 51~60 更新一次(v = 'c'),新的旧版本在哪个文件、删除向量会怎么变?(答案:上一次的新版本在 L4 文件里,这次 lookup 会命中 L4 文件的行号并标记;或者 L4 文件先被合并重写,旧文件的删除向量随之清理(notifyRewriteCompactBefore)。具体取决于这次合并选中了哪些文件,未单独运行,可用同一断点清单验证。)