
S2 第 2 讲:一条数据的写入之旅(断点实录)
Apache Paimon 源码学习
作者 X老师(DaemonforY),Paimon 2.0 / master 源码,按 CC BY-NC-SA 4.0 发布。配套实验和代码在 GitHub。
TL;DR:一行数据写进 Paimon 主键表要经过六站:① 按
abs(主键哈希 % 桶数)算出 bucket(Source 和 Writer 线程各算一次);② 每个 (分区, bucket) 第一次出现时才创建 writer,并从最新快照恢复这个 bucket 已有的文件;③ 写进内存缓冲,分配 sequence number——起点是恢复出的文件里最大的 seq + 1,所以同一个 bucket 的 seq 跨提交连续递增,不同 bucket 各数各的;④ 提交前刷盘,同 key 多条时才调用合并函数;⑤ 写出 L0 文件;⑥ 每个 bucket 生成一条 CommitMessage 交给提交端。
实验:写两次
第 1 讲用 jdb 抓了调用栈,这一讲更进一步:在每一站打印真实的变量值。jdb-stacks.sh 新增了一个能力——断点清单里,缩进的行是“命中这个断点时额外执行的命令”:
# ③ 每行数据进入写缓冲:分配 sequence number
stop at org.apache.paimon.mergetree.MergeTreeWriter:166
  print kv.key().getLong(0)
  print kv.value().getString(1).toString()
  print this.newSequenceNumber
实验表有 2 个 bucket,写两次:
CREATE TABLE journey (order_id BIGINT, status STRING, PRIMARY KEY (order_id) NOT ENFORCED)
WITH ('bucket' = '2');

INSERT INTO journey VALUES (1, 'A'), (2, 'B'), (1, 'C');   -- 第 1 次
INSERT INTO journey VALUES (1, 'D'), (3, 'E');             -- 第 2 次
复现(需要先在 d15d250cf 上编译安装 2.2-SNAPSHOT):
cd labs && PAIMON_VERSION=2.2-SNAPSHOT ./jdb-stacks.sh sql/lab04/trace-write-twice.sql jdb/s2-2-write-journey.txt 60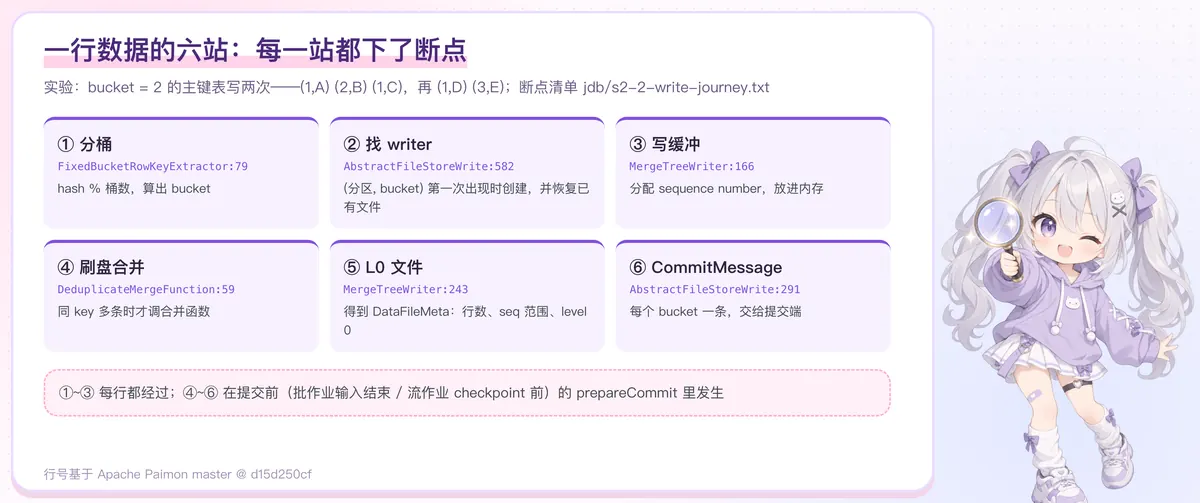
六个断点一共命中 26 次。下面一站一站看。
第一站:分桶
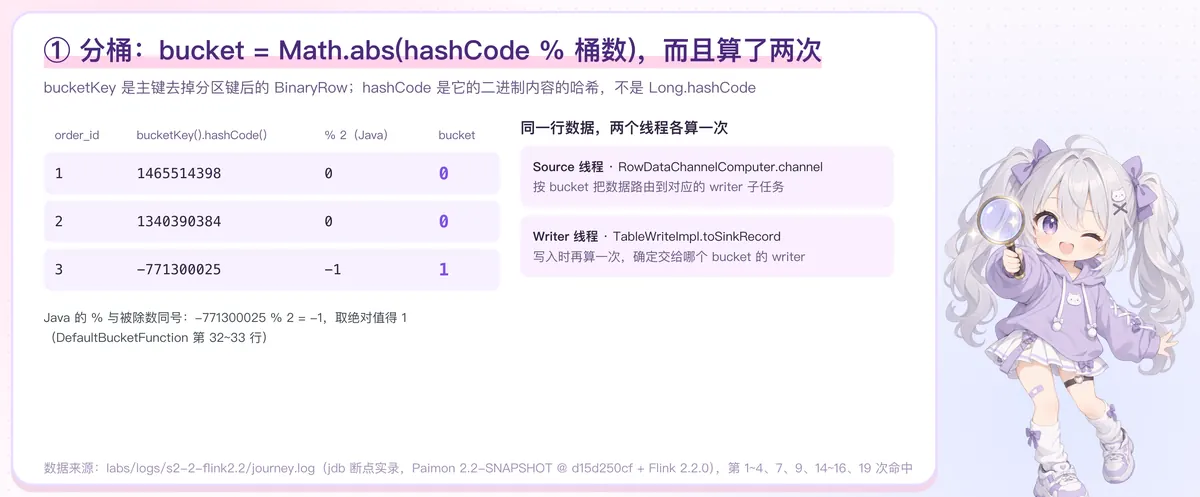
断点在 FixedBucketRowKeyExtractor 第 79 行 bucketFunction.bucket(bucketKey(), numBuckets):
bucketKey().getLong(0) = 1    bucketKey().hashCode() = 1465514398    numBuckets = 2
bucketKey().getLong(0) = 2    bucketKey().hashCode() = 1340390384    numBuckets = 2
bucketKey().getLong(0) = 3    bucketKey().hashCode() = -771300025    numBuckets = 2
DefaultBucketFunction 第 32~33 行:Math.abs(hash % numBuckets)。
- 订单 1、2 的哈希是偶数,落在 bucket 0;
- 订单 3 的哈希是负数:Java 的
%结果和被除数同号,-771300025 % 2 = -1,取绝对值后是 bucket 1。
几个细节:
bucketKey是主键去掉分区字段后的BinaryRow,hashCode是对它的二进制内容按字计算的哈希(BinaryRow.hashCode→MemorySegmentUtils.hashByWords),不是Long.hashCode(1) = 1。所以不要凭直觉认为“订单号为奇数就在 bucket 1”。- 同一行数据的 bucket 算了两次。前三次命中在
Source: Values -> … -> Map线程,调用方是RowDataChannelComputer.channel——Flink 先按 bucket 决定把这行数据发给哪个 writer 子任务;之后在Writer : journey线程又算一次,确定交给哪个 bucket 的 writer。
第二站:找 writer——而且会“恢复”
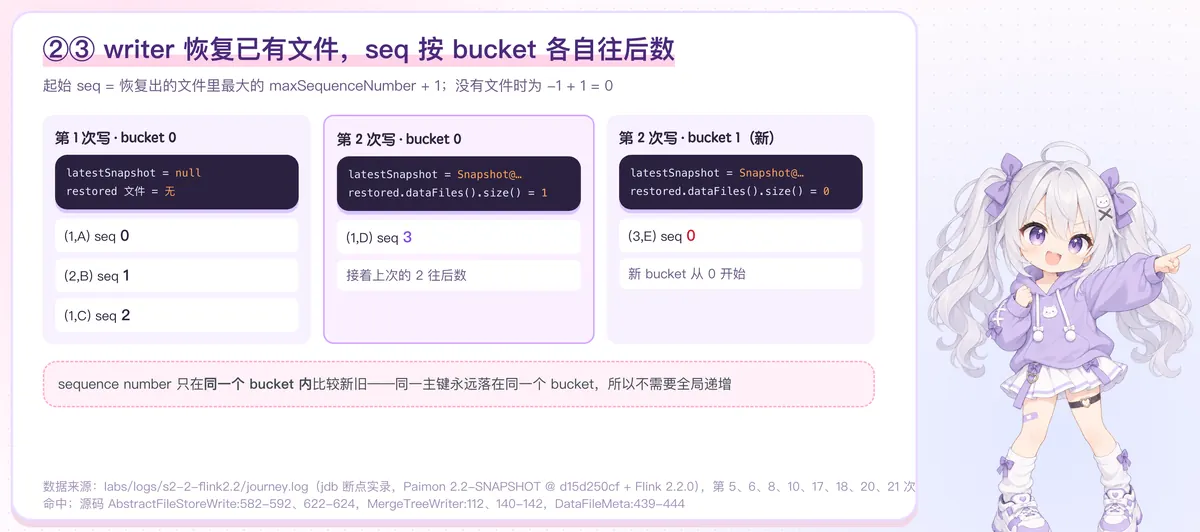
AbstractFileStoreWrite.getWriterWrapper 用 computeIfAbsent 按 (分区, bucket) 取 writer,第一次出现时调用 createWriterContainer(第 531 行起)。断点在第 582 行,此时已经完成了“恢复”:
| 命中 | bucket | latestSnapshot | 恢复出的已有文件 |
|---|---|---|---|
| 第 1 次写 | 0 | null | 无(新表) |
| 第 2 次写 | 0 | Snapshot@… | 1 个 |
| 第 2 次写 | 1 | Snapshot@… | 0 个(这个 bucket 还没有数据) |
第 549 行先读最新快照,第 556 行 scanExistingFileMetas 扫描这个 bucket 已有的数据文件。writer 不是常驻的:每个作业(批作业每次 INSERT,流作业每次启动)都是新的 writer,靠快照里的文件清单恢复出这个 bucket 的 LSM 树——后续的合并(第 3、4 讲)需要知道已有哪些文件。
还有一个小发现:第 1 次写时 bucket 1 根本没有创建 writer(那次只有订单 1、2,都在 bucket 0)。writer 是懒创建的,哪个 bucket 有数据才建哪个。
第三站:写缓冲与 sequence number
断点在 MergeTreeWriter 第 166 行 long sequenceNumber = newSequenceNumber();:
第 1 次写   (1,'A')  newSequenceNumber = 0
            (2,'B')  newSequenceNumber = 1
            (1,'C')  newSequenceNumber = 2
第 2 次写   (1,'D')  newSequenceNumber = 3      ← bucket 0:接着上次往后数
(3,'E') newSequenceNumber = 0 ← bucket 1:新 bucket,从 0 开始起点是怎么来的?createWriterContainer 第 590~592 行把 getMaxSequenceNumber(restoreFiles) 传给 writer:恢复出的文件里最大的 maxSequenceNumber,没有文件时是 -1(DataFileMeta 第 439~444 行);MergeTreeWriter 构造函数第 112 行 this.newSequenceNumber = maxSequenceNumber + 1。
- 第 1 次写 bucket 0:没有文件 → -1 + 1 = 0;
- 第 2 次写 bucket 0:恢复出的文件 seq 范围是 1~2 → 2 + 1 = 3;
- 第 2 次写 bucket 1:没有文件 → 0。
sequence number 只在同一个 bucket 内比较新旧。同一主键永远落在同一个 bucket,所以它不需要全局递增——这也是 Paimon 写入可以按 bucket 完全并行、不需要任何全局协调的原因之一。
默认的
write.sequence-number-init-mode = scan就是上面这种“从恢复文件里取最大值”;另一种snapshot模式会同时参考快照里记录的值(AbstractFileStoreWrite第 622~630 行),本讲不展开。
这一站之后,数据只在内存里(S1 第 5 期)。
第四站:刷盘合并——只有需要时才调合并函数
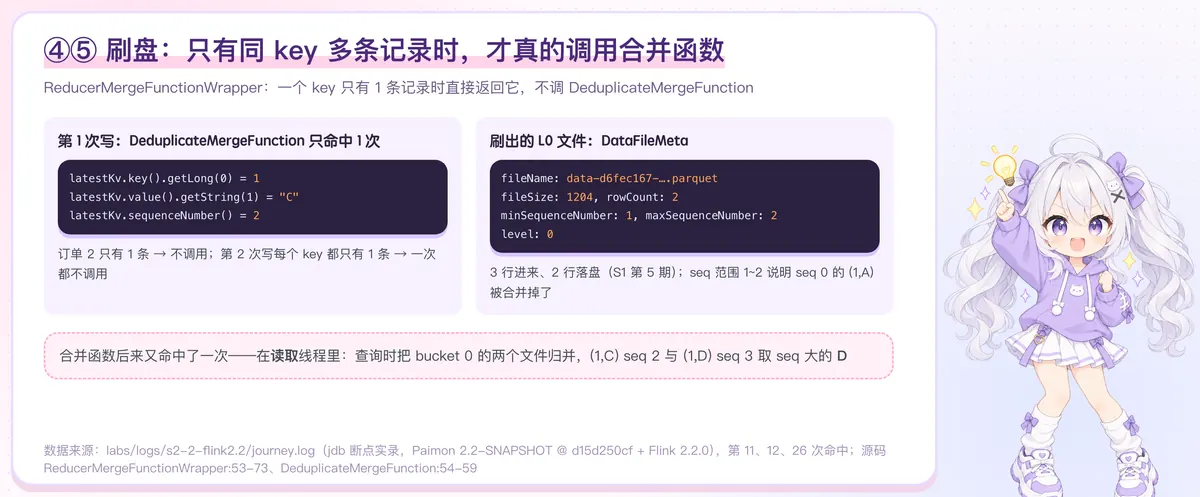
断点在 DeduplicateMergeFunction 第 59 行 return latestKv;。本以为每个 key 都会命中一次,结果第 1 次写只命中 1 次:
latestKv.key().getLong(0) = 1
latestKv.value().getString(1) = "C"
latestKv.sequenceNumber() = 2
订单 1 的 A 和 C 被合并,留下 seq 2 的 C;订单 2 只有一条,根本没有调用合并函数。第 2 次写的两个 key 各只有一条,一次都没调用。
原因在包装类 ReducerMergeFunctionWrapper(第 53~73 行):第一条记录先存成 initialKv,只有同一个 key 来了第二条才真正初始化合并函数;getResult() 在没初始化时直接返回 initialKv。对“绝大多数 key 只写一次”的场景,这省掉了大量合并函数调用。
DeduplicateMergeFunction 后来又命中了一次,是在 Source: journey 线程——最后那条 SELECT * FROM journey 读 bucket 0 时,要把两个文件里订单 1 的 C(seq 2)和 D(seq 3)归并:
latestKv.key().getLong(0) = 1 latestKv.value() = "D" latestKv.sequenceNumber() = 3同一个合并函数,写入刷盘时用、读取归并时也用(还有合并时,第 4 讲)。
第五站:L0 文件
断点在 MergeTreeWriter 第 243 行,打印 dataWriter.result()(DataFileMeta.toString(),节选):
{fileName: data-d6fec167-….parquet, fileSize: 1204, rowCount: 2,
 minSequenceNumber: 1, maxSequenceNumber: 2, schemaId: 0, level: 0, …}
3 行进来,2 行落盘;seq 范围 1~2,说明 seq 0 的 (1,A) 被合并掉了。新文件都在 level 0。DataFileMeta 里还有 minKey / maxKey、keyStats / valueStats——读取时裁剪、合并时选文件都靠它们。
第六站:CommitMessage
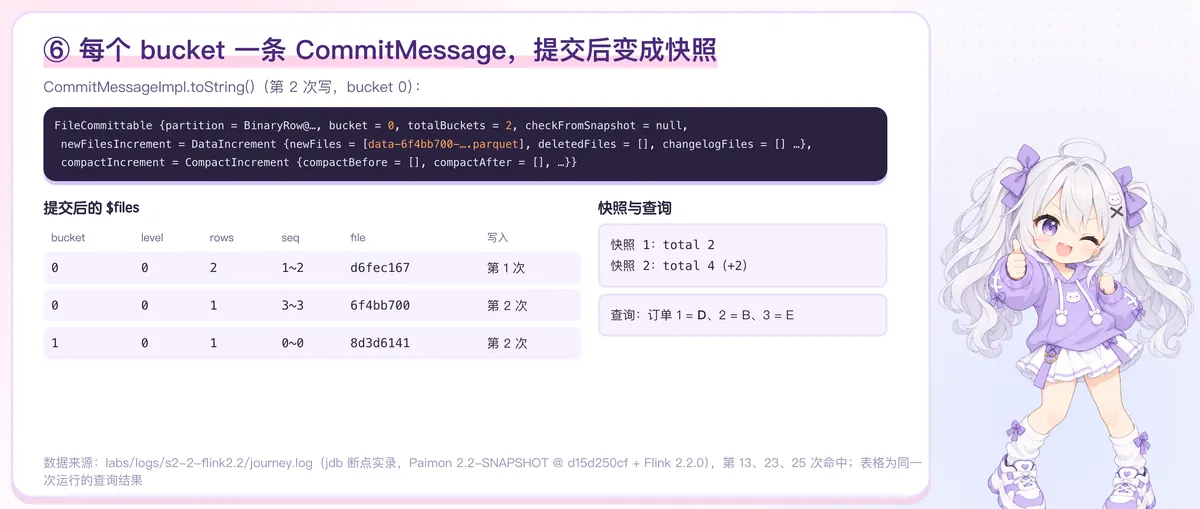
断点在 AbstractFileStoreWrite 第 291 行 result.add(committable)。第 2 次写命中两次,每个 bucket 一条。bucket 0 那条(CommitMessageImpl.toString()):
FileCommittable {partition = BinaryRow@…, bucket = 0, totalBuckets = 2, checkFromSnapshot = null,
  newFilesIncrement = DataIncrement {newFiles = [data-6f4bb700-….parquet], deletedFiles = [], changelogFiles = [] …},
compactIncrement = CompactIncrement {compactBefore = [], compactAfter = [], …}}newFilesIncrement:这次写出的新文件;compactIncrement:合并前后的文件——这次没有发生合并,所以是空的;- 提交端(第 1 讲、第 5 讲)把这些 CommitMessage 汇总成一个新快照。
提交后的结果:
$files
| bucket | level | rows | seq   | file     |
|      0 |     0 |    2 | 1 ~ 2 | d6fec167 |   ← 第 1 次写
|      0 |     0 |    1 | 3 ~ 3 | 6f4bb700 |   ← 第 2 次写
|      1 |     0 |    1 | 0 ~ 0 | 8d3d6141 |   ← 第 2 次写

$snapshots:快照 1 total 2,快照 2 total 4(delta 2)
SELECT *:订单 1 = D、2 = B、3 = E
bucket 0 现在有两个 L0 文件、key 范围重叠——下一次写入时,它们就是合并的候选。
小结:六站各自回答了一个问题
| 站 | 问题 | 答案 |
|---|---|---|
| ① 分桶 | 这行数据归谁? | abs(bucketKey 哈希 % 桶数),Source 和 Writer 各算一次 |
| ② 找 writer | writer 从哪来? | 按 (分区, bucket) 懒创建,从最新快照恢复已有文件 |
| ③ 写缓冲 | 怎么区分新旧? | seq = 恢复文件最大 seq + 1,按 bucket 各自递增 |
| ④ 刷盘合并 | 同 key 怎么办? | 同 key 多条才调合并函数,否则直接写 |
| ⑤ L0 文件 | 落盘了什么? | DataFileMeta:行数、seq 范围、key 范围、level 0 |
| ⑥ CommitMessage | 怎么交给提交端? | 每个 bucket 一条:新文件 + 合并前后文件 |
下一讲:bucket 0 里的两个重叠文件,什么时候会被合并?——UniversalCompaction 怎么选文件。
自测题:把这张表改成 'bucket' = '4' 重新跑,订单 1、2、3 的 bucket 会变吗?第 2 次写时订单 1 的 seq 还是 3 吗?(答案:bucket 会按 abs(hash % 4) 重新计算,可能变;只要订单 1 所在 bucket 的第 1 次写入仍然有 2 条订单 1 的记录并刷出 seq 范围相同的文件,第 2 次写的 seq 仍从该 bucket 已有文件的最大 seq + 1 开始——具体数字取决于第 1 次写时这个 bucket 里还有哪些 key。未单独运行,可改 SQL 后用同一个断点清单验证。)