
S2 第 3 讲:LSM 合并怎么选文件——UniversalCompaction
Apache Paimon 源码学习
作者 X老师(DaemonforY),Paimon 2.0 / master 源码,按 CC BY-NC-SA 4.0 发布。配套实验和代码在 GitHub。
TL;DR:Paimon 主键表默认用
UniversalCompaction决定合并哪些文件。它挑的不是文件,而是 sorted run:L0 每个文件一个 run,L1~L5 每层一个 run,底座也算。pick()依次判断:① 新数据超过底座 2 倍 → 全量合并;② 大小相近 → 从最新的 run 开始“滚雪球”;③ run 数超过 5 → 强制兜底。命中一级就返回。结果只能是最新的一段连续前缀,输出到“下一个更老 run 的上一层”,始终保持 level 越低数据越新。
一个让人意外的现象
先做一个实验:建一张 1 个 bucket 的主键表,写 2000 行,用 CALL sys.compact 全量合并成一个 L5 底座;然后每次提交只写 1 行,每次提交后查 $files。
完整 SQL:
labs/sql/lab04/universal-compaction.sql,一条命令复现:cd labs && ./run.sh sql/lab04/universal-compaction.sql
默认参数 num-sorted-run.compaction-trigger = 5。直觉上,攒够 5 个小文件才会合并。实际结果(Paimon 2.0.0):
第 1~3 次提交:L0 文件 1、2、3 个,L5 底座 1 个
第 4 次提交:  Paimon compact task finished: inputFiles=4, outputFiles=1
               → L4 1230 B(4 行)+ L5 8744 B(2000 行)
第 5、6 次:   L0 1~2 个 + L4 + L5
第 7 次提交: inputFiles=4, outputFiles=1 → L4 1264 B(7 行)+ L5两个问题:为什么第 4 次就合并了?为什么合并到 L4 而不是 L5? 答案都在 UniversalCompaction.java 那 190 行里。
一、合并挑的是 sorted run,底座也算一个
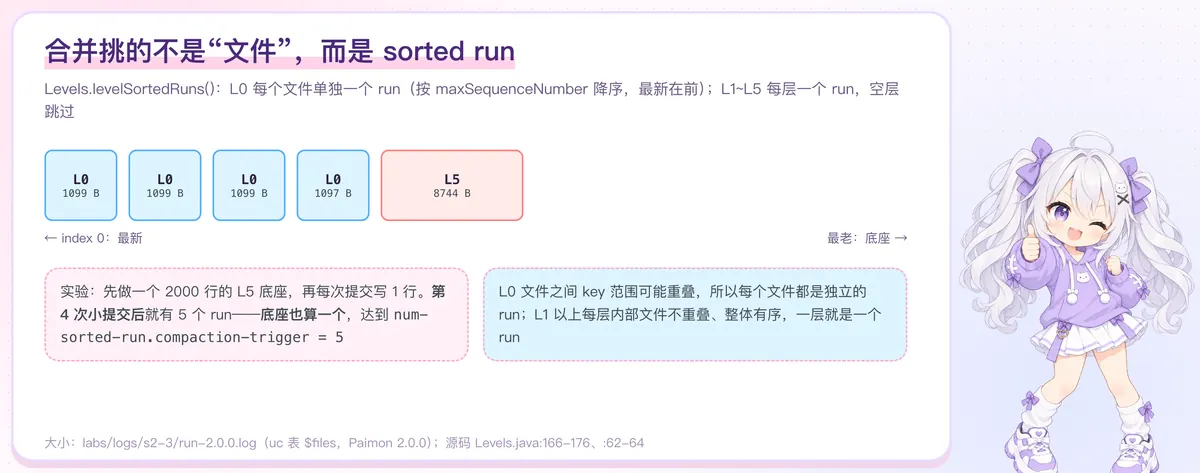
合并前,MergeTreeCompactManager.triggerCompaction() 先调用 Levels.levelSortedRuns()(第 166~176 行)构造输入:
level0.forEach(file -> runs.add(new LevelSortedRun(0, SortedRun.fromSingle(file))));  // L0:每个文件一个 run
for (int i = 0; i < levels.size(); i++) {
    if (levels.get(i).nonEmpty()) runs.add(new LevelSortedRun(i + 1, levels.get(i)));  // L1~L5:每层一个 run
}- L0 文件之间的 key 范围可能重叠,所以每个 L0 文件单独算一个 run,按
maxSequenceNumber降序排(第 62~64 行),index 0 最新; - L1 及以上,每层内部文件不重叠、整体有序,一层就是一个 run,空层跳过。
第 4 次小提交后,runs 是:
[L0 1099 B, L0 1099 B, L0 1099 B, L0 1097 B, L5 8744 B] ← 5 个 run底座也是一个 run。 4 个小文件 + 1 个底座 = 5,达到 trigger。这就是第一个问题的答案。
二、pick 的四级判断
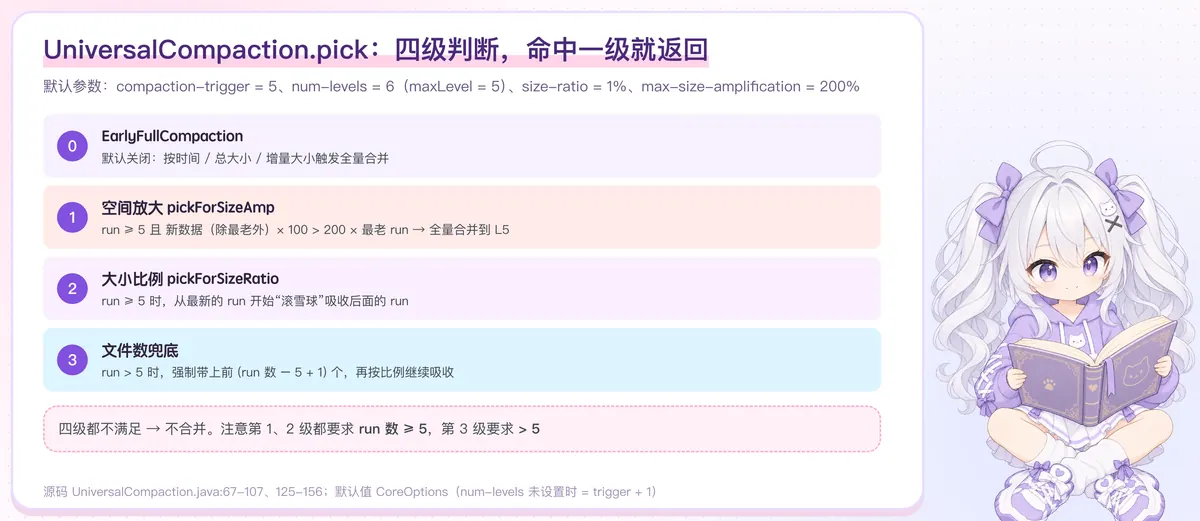
UniversalCompaction.pick()(第 67~107 行):
pick(numLevels, runs)
 ├─ 0. EarlyFullCompaction     默认关闭:按时间 / 总大小 / 增量大小触发全量合并
 ├─ 1. pickForSizeAmp          空间放大过大 → 全量合并到 maxLevel
 ├─ 2. pickForSizeRatio        大小相近 → 从最新的 run 开始滚雪球
 ├─ 3. 文件数兜底              runs > trigger → 强制合并
└─ 都不满足 → Optional.empty()默认值:compaction-trigger = 5、num-levels 未设置时 = trigger + 1 = 6(maxLevel = 5)、compaction.size-ratio = 1(%)、compaction.max-size-amplification-percent = 200。
注意一个细节:第 1、2 级开头都有 if (runs.size() < numRunCompactionTrigger) return null;(第 126、151 行),即 run 数 ≥ 5 才判断;第 3 级要求 > 5。
三、第 4 次提交到底发生了什么:jdb 实录
在 UniversalCompaction 的几个关键位置下断点、打印变量(jdb/s2-3-universal.txt):
cd labs && PAIMON_VERSION=2.2-SNAPSHOT ./jdb-stacks.sh sql/lab04/universal-compaction.sql jdb/s2-3-universal.txt 200第 1 级:空间放大(第 139 行)
candidateSize = 4394        ← 除最老 run 外,所有 run 的大小之和
earliestRunSize = 8744      ← 最老的 run(L5 底座)
4394 × 100 > 200 × 8744 ?   否
新数据还不到底座的 2 倍,不全量合并。
第 2 级:大小比例(第 169 行,每吸收一个 run 前判断一次)
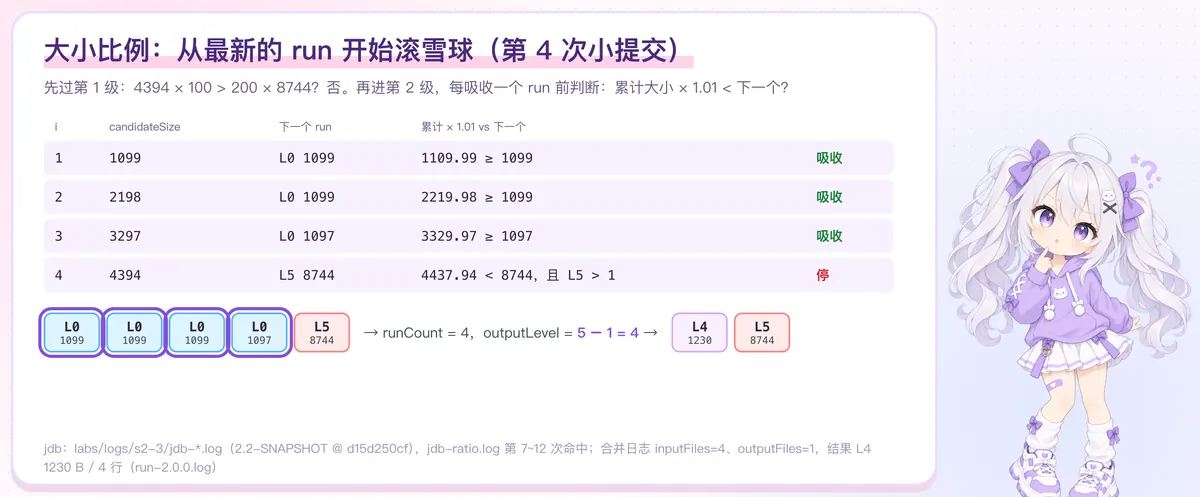
| i | candidateSize | 下一个 run | 累计 × 1.01 vs 下一个 | 结果 |
|---|---|---|---|---|
| 1 | 1099 | L0 1099 | 1109.99 ≥ 1099 | 吸收 |
| 2 | 2198 | L0 1099 | 2219.98 ≥ 1099 | 吸收 |
| 3 | 3297 | L0 1097 | 3329.97 ≥ 1097 | 吸收 |
| 4 | 4394 | L5 8744 | 4437.94 < 8744,且 L5 > 1 | 停 |
对应源码(第 163~182 行):
for (int i = candidateCount; i < runs.size(); i++) {
    LevelSortedRun next = runs.get(i);
    if (candidateSize * (100.0 + sizeRatio + ratioForOffPeak()) / 100.0 < next.run().totalSize()) {
        if (!compactionTriggered || next.level() > 1) break;   // 下一个明显更大:停
    }
    candidateSize += next.run().totalSize();                   // 否则吸收它
    candidateCount++;
    compactionTriggered = true;
}
累计大小像雪球一样越滚越大,直到下一个 run“明显更大”(超过累计的 1.01 倍)才停下。
四、输出到哪一层:下一个更老 run 的上一层
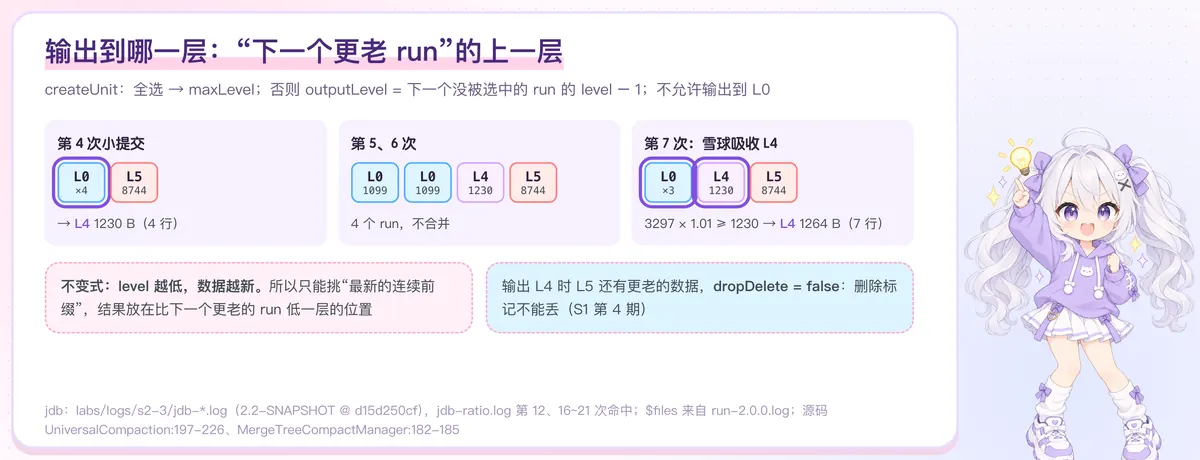
断点在 createUnit 的返回处(第 225 行):
runCount = 4 outputLevel = 4 runs.size() = 5规则(第 197~226 行):
- 全部 run 都选中 → 输出到 maxLevel(L5);
- 否则
outputLevel = 下一个没被选中的 run 的 level − 1:这里下一个是 L5,所以输出到 L4; - 不允许输出到 L0:如果算出来是 0,就继续吸收,直到吸收到第一个非 L0 的 run。
这就是第二个问题的答案。背后是一个不变式:level 越低,数据越新。合并结果比底座新,就必须放在底座上面一层;也正因为如此,合并只能挑“最新的一段连续前缀”,不能跳着选。
第 7 次提交更能体现“滚雪球”:
runs = [L0 1099, L0 1099, L0 1099, L4 1230, L5 8744]
i = 3: candidateSize = 3297, next = L4 1230 → 3329.97 ≥ 1230,吸收 L4
i = 4: candidateSize = 4527, next = L5 8744 → 停
→ runCount = 4, outputLevel = 4:3 个 L0 + 旧的 L4 合并成新的 L4(7 行)
上一次合并出的 L4 被这次的雪球“吞”了进去。
还有一个和 S1 第 4 期呼应的细节:选出 unit 后,MergeTreeCompactManager 第 182~185 行计算 dropDelete = outputLevel != 0 && outputLevel >= 当前最高非空层。这次输出到 L4,而 L5 还有更老的数据,所以 dropDelete = false——删除标记不能丢,否则 L5 里的旧数据会“复活”。
五、另外两条规则
为了看到另外两条规则,再建两张表(labs/sql/lab04/universal-compaction-2.sql)。
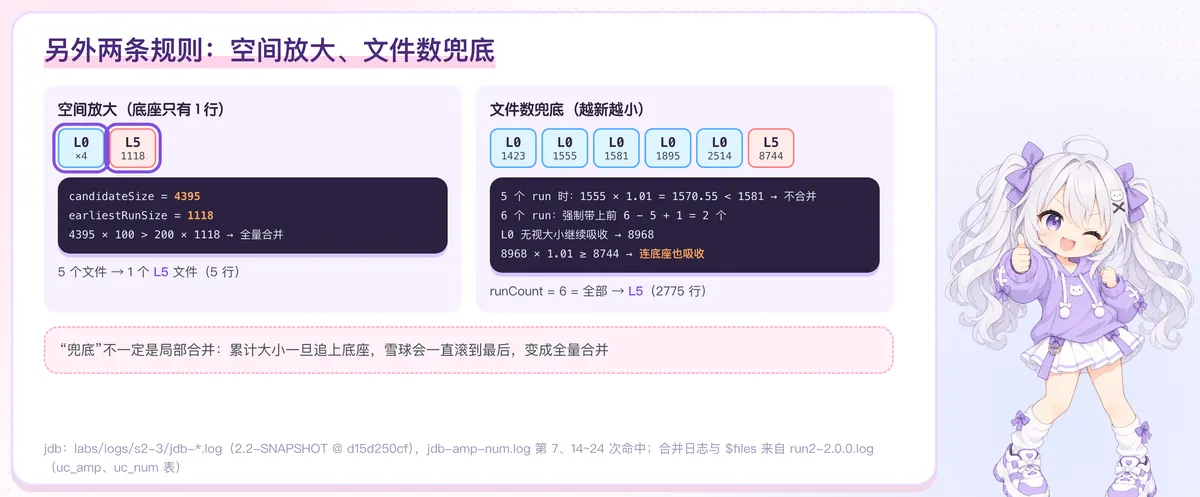
空间放大:底座只有 1 行
底座 1118 B,再写 4 次 1 行。第 4 次后 5 个 run:
candidateSize = 4395, earliestRunSize = 1118
4395 × 100 > 200 × 1118 → 全量合并
5 个文件合并成 1 个 L5 文件(5 行)。pickForSizeAmp 直接返回 CompactUnit.fromLevelRuns(maxLevel, runs),第 2 级根本不会执行。这是全量合并最主要的触发方式:新写入的数据量超过底座的 2 倍。
文件数兜底:每次提交越来越小
底座 2000 行(8744 B),然后依次写 400、200、100、50、25 行。越新的文件越小,雪球滚不起来:
第 4 次提交后(5 个 run):
  空间放大:7545 × 100 > 200 × 8744?否
  大小比例:i = 1,candidateSize = 1555,next = L0 1581
            1555 × 1.01 = 1570.55 < 1581,且还没开始吸收 → 停,返回 null
  run 数 5 不 > 5 → 不合并
第 5 次提交后 6 个 run,第 1、2 级都不满足(8968 × 100 ≤ 200 × 8744;1423 × 1.01 < 1555),进入第 3 级:
runs.size() = 6 > 5 → candidateCount = 6 − 5 + 1 = 2(强制带上最新的 2 个)
i = 2: 2978,next = L0 1581 → 吸收(L0 不管大小,已开始吸收就继续)
i = 3: 4559,next = L0 1895 → 吸收
i = 4: 6454,next = L0 2514 → 吸收
i = 5: 8968,next = L5 8744 → 8968 × 1.01 = 9057.68 ≥ 8744 → 吸收!
→ runCount = 6 = 全部 → outputLevel = 5
结果:6 个文件全量合并成一个 L5 文件(2775 行)。
这里有两个值得记住的点:
- 为什么 L0 / L1 要“无视大小继续吸收”(第 171 行
next.level() > 1才停):输出层必须低于下一个没选中的 run;如果剩下的是 L0,算出来的输出层就是 0 以下,无处可放。 - “兜底”不一定是局部合并:强制起步之后,雪球一旦追上底座,就会一直滚到最后,变成全量合并。我原本以为这次会合并到 L4,实际数字告诉我不是。
小结:一张表手算 pick
| 判断 | 条件 | 结果 | 本文实验 |
|---|---|---|---|
| ① 空间放大 | run ≥ 5 且 新数据 × 100 > 200 × 最老 run | 全量 → L5 | uc_amp:4395 vs 1118 |
| ② 大小比例 | run ≥ 5,从最新的 run 起累计 × 1.01 ≥ 下一个就吸收 | 前缀 → 下一个 run 的上一层 | uc:4 个 L0 → L4 |
| ③ 文件数兜底 | run > 5,强制带上前 (run − 5 + 1) 个再吸收 | 视雪球大小而定 | uc_num:滚到底 → L5 |
| 都不满足 | 不合并 | uc_num 第 4 次提交 |
生产启示
- trigger 包含底座:表里已有 L1~L5 的数据时,几个小提交就可能触发合并。流作业每次 checkpoint 都在产生 L0 文件,合并频率远比“攒 5 个文件”高。
- 小文件多、写入量小的表,合并大多输出到中间层(L4 等),底座很少被重写;写入量大的表,新数据很快超过底座 2 倍,频繁全量合并——这是写放大的主要来源。
- 想控制合并频率,先调
num-sorted-run.compaction-trigger;写入太快、合并跟不上时,run 数超过num-sorted-run.stop-trigger(默认 trigger + 3 = 8)写入会被阻塞等待合并。
下一讲:选好了文件,合并怎么执行?为什么有的文件只改个 level 就“合并完了”,有的要整个重写?
自测题(教程 03 章例 C):runs = [L0:1, L0:5, L0:20, L2:80, L3:300, L5:1000](单位 MB),默认参数下选什么、输出到哪层?(答案:第 1 级 406 < 2000 否;第 2 级 1 × 1.01 < 5 且未开始吸收 → null;第 3 级 6 > 5,强制前 2 个(6),吸收 L0:20(26),遇到 L2:80 时 26.26 < 80 且 L2 > 1 → 停;outputLevel = 2 − 1 = 1。结果 [L1:26, L2:80, L3:300, L5:1000]。按源码逐行推导,未单独运行。)