
S2 第 11 讲:Spark MERGE INTO 的三条路径
Apache Paimon 源码学习
作者 X老师(DaemonforY),Paimon 2.0 / master 源码,按 CC BY-NC-SA 4.0 发布。配套实验和代码在 GitHub。
TL;DR:Paimon 的 Spark
MERGE INTO有三条落地方式,但前半段是同一个引擎:source 和 target 做 full outer join,每一行按 MATCHED / NOT MATCHED / NOT MATCHED BY SOURCE 归类,找第一个成立的动作,输出 +I / +U / -D。区别在后半段:主键表只写变化的行(新 L0 文件),旧版本交给 LSM,提交是 APPEND;追加表把被触及的文件整个重写(copy-on-write),提交升级为 OVERWRITE;追加表 + 删除向量旧文件一个字节不动,按行号打标记,也是 OVERWRITE。默认三者都走 Paimon 自己的 V1 命令MergeIntoPaimonTable;只有打开spark.paimon.write.use-v2-write,追加表才交给 Spark 原生的 V2 copy-on-write。
实验:同一条 MERGE,四张表
这一讲第一次用 Spark:labs 新增了一个 spark/ 子工程(Spark 3.5.8 + paimon-spark-3.5),./spark.sh <sql 文件> 用法和 Flink 的 run.sh 一样,在本地 local[1] 跑(单线程,文件数每次相同)。
labs/sql/lab13/merge-into.sql:每张表先分两批写 (1,a)(2,b)(3,c) 和 (4,d)(5,e)(6,f),得到两个数据文件;然后执行同一条 MERGE:
CREATE TEMPORARY VIEW s AS SELECT * FROM VALUES (2, 'B', 'U'), (3, 'C', 'D'), (7, 'G', 'I') AS s(id, v, op);

MERGE INTO t USING s ON t.id = s.id
  WHEN MATCHED AND s.op = 'D' THEN DELETE
  WHEN MATCHED THEN UPDATE SET v = s.v
  WHEN NOT MATCHED THEN INSERT (id, v) VALUES (s.id, s.v);
即:id 2 改成 B、删除 id 3、插入 id 7。四张表:主键表 t_pk、追加表 t_cow、追加表 + 删除向量 t_dv,以及打开 V2 写的追加表 t_v2。四张表 MERGE 后的查询结果完全一样:1 a、2 B、4 d、5 e、6 f、7 G。
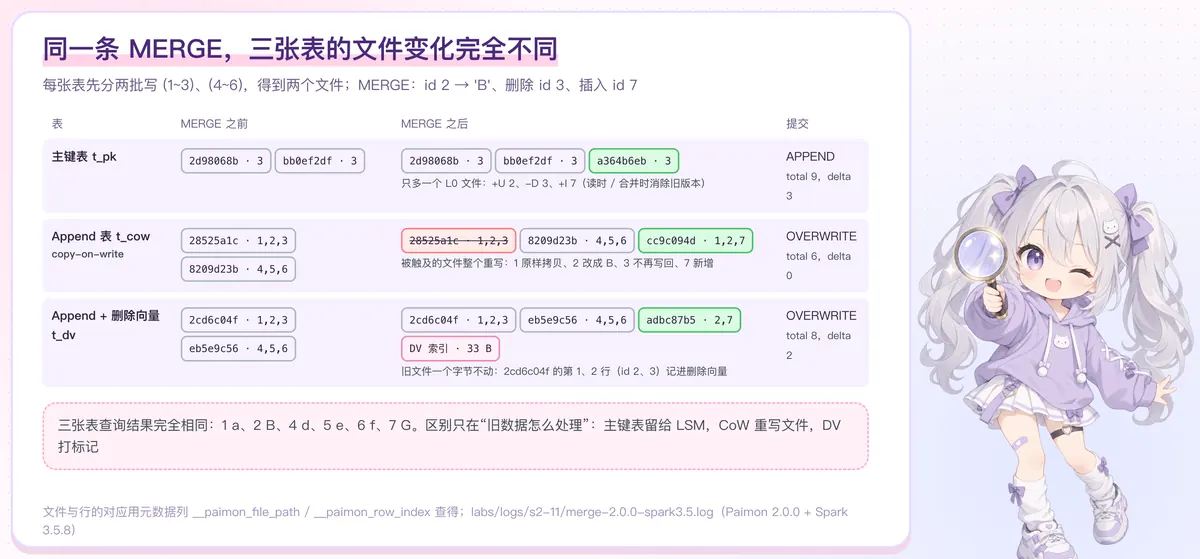
每行在哪个文件、第几行,用 Paimon 的元数据列 __paimon_file_path、__paimon_row_index 直接查(节选,文件名只取前 8 位):
t_cow,MERGE 之前                       t_cow,MERGE 之后
|1  |a  |28525a1c|                      |1  |a  |cc9c094d|
|2  |b  |28525a1c|                      |2  |B  |cc9c094d|
|3  |c  |28525a1c|                      |4  |d  |8209d23b|
|4  |d  |8209d23b|                      |5  |e  |8209d23b|
|5  |e  |8209d23b|                      |6  |f  |8209d23b|
|6 |f |8209d23b| |7 |G |cc9c094d|| 表 | MERGE 后的文件 | 提交 |
|---|---|---|
主键表 t_pk | 原来两个文件不动,多一个 3 条记录的 L0 文件 a364b6eb | APPEND(total 9,delta 3) |
追加表 t_cow | 含 1~3 的 28525a1c 被换成 cc9c094d(1 a、2 B、7 G),含 4~6 的 8209d23b 不动 | OVERWRITE(total 6,delta 0) |
追加 + DV t_dv | 两个旧文件都不动;新增 adbc87b5(2 B、7 G),外加一个 33 字节的删除向量索引 | OVERWRITE(total 8,delta 2) |
t_dv MERGE 之后:id 1 还在 2cd6c04f 的第 0 行,原来的第 1、2 行(id 2、3)查不到了——它们被记进了删除向量,文件本身没变。$snapshots 的 total 是 8(6 + 2),因为物理上 8 行都还在。
一、共用的引擎:full outer join + 逐行判定
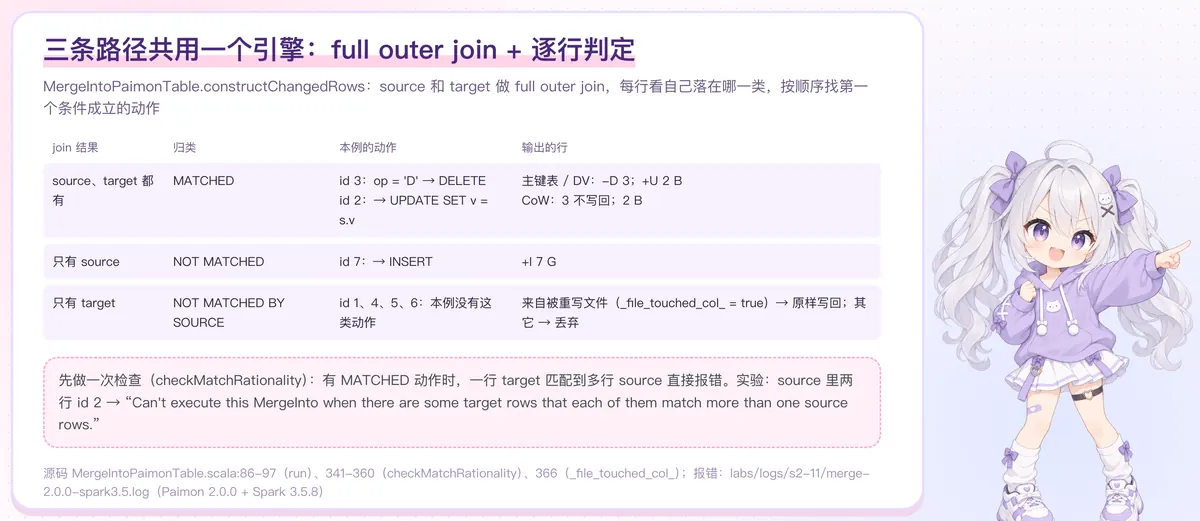
三条 V1 路径都在 MergeIntoPaimonTable(paimon-spark-common)里。run()(第 86~97 行):
checkMatchRationality(sparkSession)            // 一行 target 不能匹配多行 source
...
val commitMessages = if (withPrimaryKeys) {
  performMergeForPkTable(sparkSession)
} else {
  performMergeForNonPkTable(sparkSession)
}
writer.commit(commitMessages, Snapshot.Operation.MERGE)
核心是 constructChangedRows:target 加一列 _target_row_ = true,source 加一列 _source_row_ = true,做 full outer join,然后逐行看:
| join 结果 | 归类 | 本例 | 输出 |
|---|---|---|---|
| 两边都有 | MATCHED | id 3(op = 'D')→ DELETE;id 2 → UPDATE | 主键表 / DV:-D 3、+U 2 B;CoW:3 不写回、写 2 B |
| 只有 source | NOT MATCHED | id 7 → INSERT | +I 7 G |
| 只有 target | NOT MATCHED BY SOURCE | id 1、4、5、6(本例没有这类动作) | 来自被重写的文件(_file_touched_col_ = true)就原样写回,否则丢弃 |
动作按 SQL 里写的顺序匹配,第一个成立的生效——所以 WHEN MATCHED AND s.op = 'D' THEN DELETE 要写在 WHEN MATCHED THEN UPDATE 前面。
先做一次检查(checkMatchRationality,第 341~360 行):只要有 MATCHED 动作,就先 inner join 统计每行 target 匹配了几行 source,有大于 1 的直接报错。实验里拿两行 id = 2 的 source 去 MERGE:
[EXPECTED ERROR] RuntimeException: Can't execute this MergeInto when there are some target rows that each of them match more than one source rows. It may lead to an unexpected result.同一行被改成 X 还是 Y 取决于执行顺序,结果不确定,所以干脆拒绝。用 MERGE 前先对 source 按 key 去重。
二、三条路径怎么落地
主键表:performMergeForPkTable(第 100~106 行)把 constructChangedRows 的结果(remainDeletedRow = true,-D 也保留)直接交给 writer,按主键分 bucket 写成新的 L0 文件。不读也不重写任何旧文件——旧版本在读的时候按 sequence 合并掉(第 6 讲),合并时清除(第 4 讲);如果是 lookup 表,还会为流读算出 -U/+U(第 8 讲)。实验里新文件 a364b6eb 有 3 条记录;t_pk$audit_log 在快照 3 上看到 +U 2 B、-D 3 c、+I 7 G。(新文件里具体是哪 3 条,由 record_count 和 audit_log 推出,未逐行读出该文件。)
追加表(copy-on-write):performMergeForNonPkTable(第 108 行起),没开删除向量时:
- 按 target 上能下推的条件挑候选文件;
- 用 inner join 找出被触及的文件(有 MATCHED 的 UPDATE / DELETE)——本例是
28525a1c;只有 INSERT 时会找“要读但不用重写”的文件(第 152~191 行); - 被触及的文件全部读出来,打上
_file_touched_col_ = true,走同一个引擎:没有动作命中的行(id 1)原样写回,删除的行(id 3)不写回; - 新写一个文件,旧文件记为删除。
所以 id 1 一个字没改,也被拷贝进了新文件。文件越大、要改的行越分散,拷贝越多——这就是 CoW 的写放大。
追加表 + 删除向量:同一个函数里的 DV 分支(第 119~145 行):扫描时带上 __paimon_file_path、__paimon_row_index,引擎输出里 -D 和 +U 的行按“文件 + 行号”收集成删除向量(+U 的位置是被更新那行原来的位置);+I 和 +U 的行写成新文件。旧文件一个字节不动。
三、走哪条路:默认都是 V1
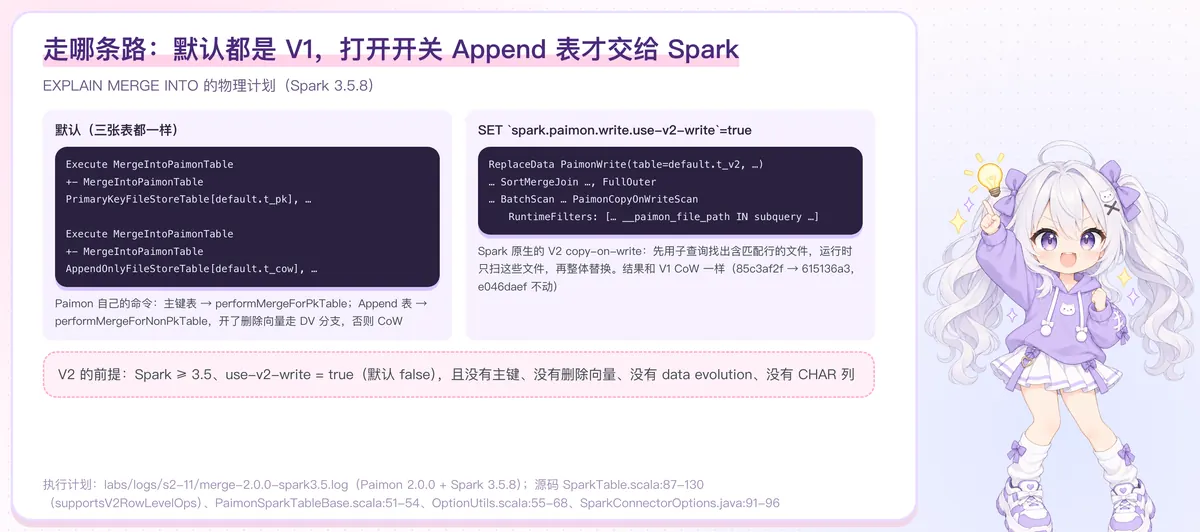
EXPLAIN MERGE INTO 的物理计划,三张表默认都是(节选):
== Physical Plan ==
Execute MergeIntoPaimonTable
   +- MergeIntoPaimonTable PrimaryKeyFileStoreTable[default.t_pk], …
Execute MergeIntoPaimonTable
   +- MergeIntoPaimonTable AppendOnlyFileStoreTable[default.t_cow], …
Execute MergeIntoPaimonTable
   +- MergeIntoPaimonTable AppendOnlyFileStoreTable[default.t_dv], …
追加表什么时候交给 Spark 原生的 V2 行级操作?SparkTable.supportsV2RowLevelOps(第 87~130 行)要求 Spark ≥ 3.5、useV2Write 为 true,并且没有主键、没有删除向量、没有 data evolution、没有 CHAR 列。useV2Write 来自 Spark 会话配置 spark.paimon.write.use-v2-write,默认 false(SparkConnectorOptions.java:91-96、OptionUtils.scala:55-68)。实验里打开它再对 t_v2 做同样的 MERGE:
SET `spark.paimon.write.use-v2-write`=true;

== Physical Plan ==
ReplaceData PaimonWrite(table=default.t_v2, overwriteDynamic=true)
+- AdaptiveSparkPlan isFinalPlan=false
   +- Project [id#1743, v#1744]
      +- MergeRowsExec[id#1743, v#1744, __paimon_file_path#1745]
         +- SortMergeJoin [id#1724], [id#1726], FullOuter
            …
            +- BatchScan default.t_v2[id#1724, v#1725, __paimon_file_path#1732] PaimonCopyOnWriteScan: [t_v2] RuntimeFilters: dynamicpruningexpression(__paimon_file_path#1732 IN subquery#175…
(节选,省略了子查询的展开。)换成了 Spark 的 ReplaceData:同样是 full outer join,但运行时过滤——先用一个子查询(target 与 source 的 LeftSemi join)找出含匹配行的文件,再只扫这些文件、整体替换。结果和 V1 CoW 一样:含 1~3 的 85c3af2f 被换成 615136a3(1 a、2 B、7 G),e046daef 不动,提交也是 OVERWRITE。
注意 SET 的写法:键里有 -,要用反引号包起来,否则 Spark 报 INVALID_SET_SYNTAX(实验第一次就踩了这个坑)。
四、提交:APPEND 还是 OVERWRITE
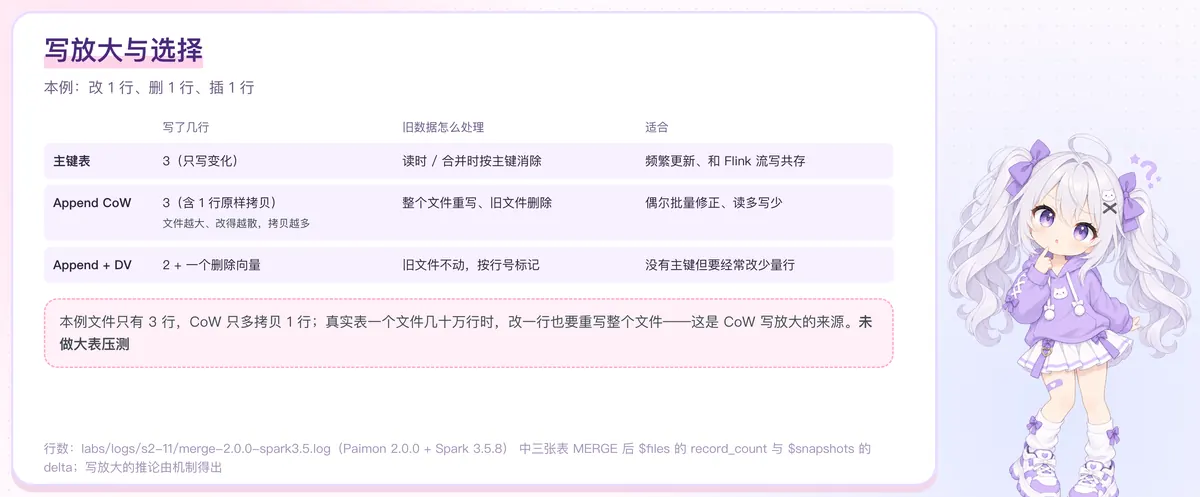
| 本例写了几行 | 旧数据 | 适合 | |
|---|---|---|---|
| 主键表 | 3(只写变化) | 读时 / 合并时按主键消除 | 频繁更新、和 Flink 流写共存 |
| 追加表 CoW | 3(其中 1 行原样拷贝) | 整个文件重写、旧文件删除 | 偶尔批量修正、读多写少 |
| 追加表 + DV | 2 + 一个删除向量 | 旧文件不动,按行号标记 | 没有主键但经常改少量行 |
本例每个文件只有 3 行,CoW 只多拷贝 1 行;真实表一个文件几十万行时,改一行也要重写整个文件。没有做大表压测,这里只说明机制。
小结
- 三条路径共用 full outer join + 逐行判定,一行 target 匹配多行 source 直接报错。
- 主键表只写变化,APPEND 提交;追加表 CoW 重写被触及的文件,DV 只打标记,两者都升级为 OVERWRITE 并强制冲突检测。
- 默认都走 Paimon 的 V1 命令;
spark.paimon.write.use-v2-write = true时,满足条件的追加表交给 Spark 原生 V2,运行时只扫含匹配行的文件。
下一讲:REST Catalog——提交时谁来保证 snapshot-(N+1) 只有一个人写成功?第 5 讲说对象存储上 rename 不可靠,REST Catalog 是服务端的答案。
自测题:给 t_cow 的 MERGE 加一句 WHEN NOT MATCHED BY SOURCE THEN DELETE,会重写几个文件?(答案:两个文件都要重写。id 1、4、5、6 都只在 target 里,会被删除;含 1~3 的文件本来就因 MATCHED 被重写,含 4~6 的 8209d23b 现在也被触及,重写后没有剩下的行。最后表里只剩 2 B、7 G。而且有 NOT MATCHED BY SOURCE 时不能只靠 target 条件裁剪候选文件(教程 10 章第 10 节)。按源码推导,未单独运行。)