
踩坑实验室 #06:用了 exactly-once,数据还是重复了
Apache Flink 源码学习
作者 X老师(DaemonforY),Flink 2.3.0 源码,按 CC BY-NC-SA 4.0 发布。
基于 Flink 2.3.0 本机实测(核对日期 2026-10-02)。对应课程:第八讲《Source / Sink 新架构》。配套示例:
flink-notes/demos/src/main/java/study/connector/SourceSinkDemo.java的fail和fail-naive模式
现象
开了 Checkpoint,自己实现了一个两阶段提交的 Sink,按理说应该是 exactly-once。可作业中途挂过一次、恢复之后,外部系统里多出了一批重复数据。
这不是 Flink 的 exactly-once“是假的”:Flink 的机制是正确的,但它要求 Sink 配合,也就是幂等提交和唯一的事务 ID。
复现
SourceSinkDemo:并行度 2,Checkpoint 间隔 1 秒,共 160 条记录,在第 80 条记录处注入一次故障。
| 模式 | Committer | 最终结果 |
|---|---|---|
fail-naive | 不检查是否已提交;事务号每次从 0 开始 | total=173 distinct=160 duplicates=13 |
fail | 检查是否已提交;事务 ID 带 Checkpoint 编号 | total=160 distinct=160 duplicates=0 |
fail-naive 的关键日志(<task> 是 Task 线程名的缩写):
[+ 4.97s] COMMIT   <task> s0-txn4 n=13 [24..36] (retries=0)        ← chk 5 完成后,第一次提交
[+ 5.22s] MAP      <task> !!! injected failure at record 80        ← 故障
[+ 6.26s] ENUM     ... addSplitsBack([split-2[80,120)]) from failed subtask 0
[+ 6.27s] COMMIT   <task> s0-txn4 n=13 [24..36] (retries=0)        ← 从 chk 5 恢复,同一个事务再提交一次
[+ 6.27s] WRITER   <task> subtask 0 createWriter (restoredCheckpointId=OptionalLong[5])
...
[+ 9.87s] MAIN     main   committed records: total=173 distinct=160 expected=160 duplicates=13
同一个事务 s0-txn4 在故障前提交了一次,恢复后又提交了一次。重复的条数不是固定的:不幂等的写法前后跑出过 10 条(示例第一版,故障点在记录 60)、12 条和 13 条(fail-naive,故障点在记录 80)。重复条数等于恢复时所用 Checkpoint 中那个事务的大小,取决于故障发生的时机,所以准确的说法是“重复了一整个事务”。幂等的写法跑了 4 次(其中 1 次故障点在记录 60),每次都是 0。
fail 模式的关键日志:
[+ 6.91s] COMMIT   <task> s0-chk5 n=12 [24..35] already committed -> signalAlreadyCommitted
...
[+10.61s] MAIN     main   committed records: total=160 distinct=160 expected=160 duplicates=0
原因
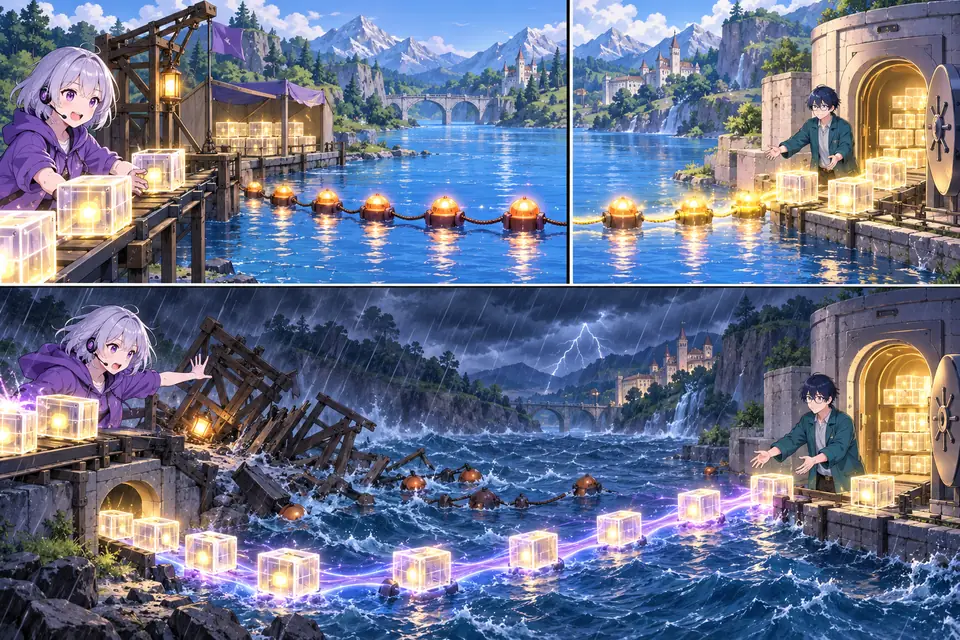
Sink V2 的两阶段提交分两步:第一阶段 prepareCommit 在 Checkpoint Barrier 发给下游之前执行(SinkWriterOperator.java:188-193);第二阶段 commit 在 Checkpoint 完成之后才执行(CommitterOperator.java:159-162,notifyCheckpointComplete)。
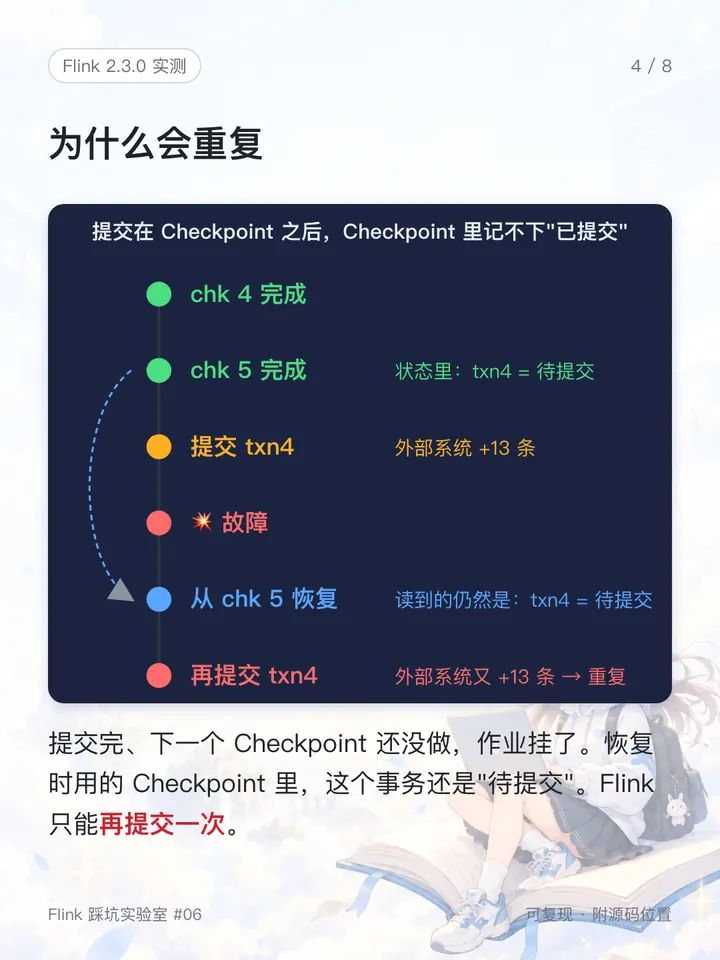
提交发生在 Checkpoint 之后,所以 Checkpoint N 完成后的那次提交,结果没有记录在任何 Checkpoint 里。如果提交完、下一个 Checkpoint 还没做,作业就挂了,恢复时用的还是 Checkpoint N,它的状态里这个事务仍是“待提交”。Flink 不知道刚才那次提交是否成功,只能再提交一次。源码 CommitterOperator.java:135-140 的注释写得很直白:“try to re-commit recovered transactions as quickly as possible”。这是设计如此。
怎么解决
原则一:Committer 必须幂等。 提交前先判断这个事务是不是已经提交过,提交过就跳过,并调用 signalAlreadyCommitted()(Committer.java:100,CommitRequest.signalAlreadyCommitted):
if (alreadyCommitted(txnId)) {
    request.signalAlreadyCommitted();
    continue;
}
改完再跑,重复变成 0。Flink 自带的 FileSink 就是幂等的:恢复后提交时先检查临时文件,还在就改名;不在而目标文件在,就说明已经提交过(FileCommitter.java:61-62 → LocalRecoverableFsDataOutputStream.java:175-197,本地文件系统的实现)。
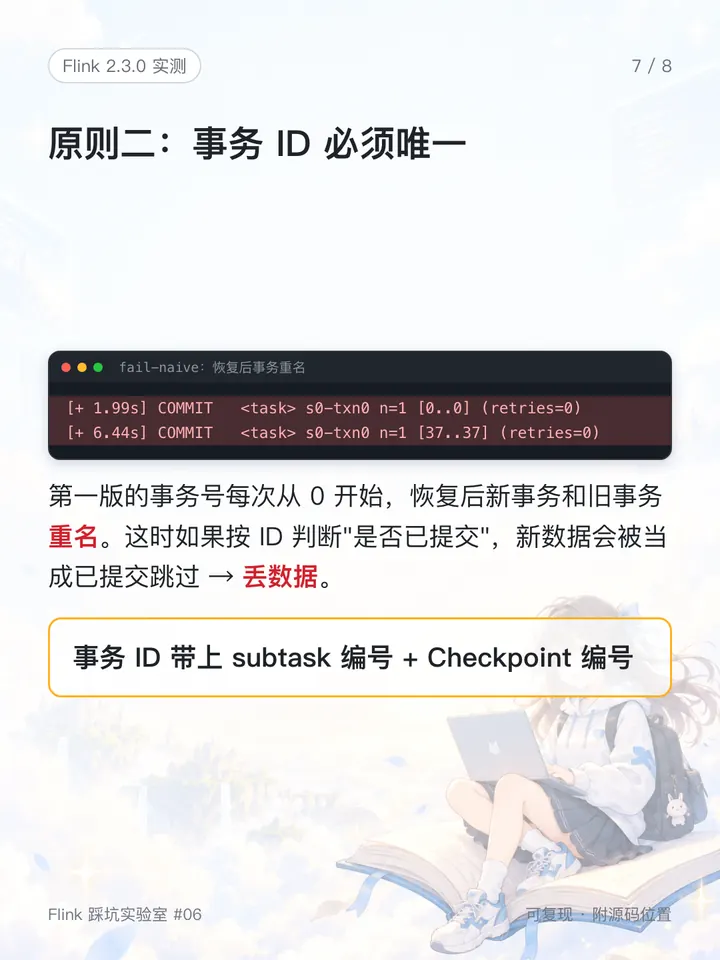
原则二:事务 ID 在重启前后必须唯一。 fail-naive 的事务号每次从 0 开始,恢复后新事务和旧事务重名了:
[+ 1.99s] COMMIT   <task> s0-txn0 n=1 [0..0]
[+ 6.44s] COMMIT   <task> s0-txn0 n=1 [37..37]      ← 恢复后,新事务又叫 s0-txn0
这时如果按 ID 判断“是否已提交”,新数据反而会被当成已提交跳过,变成丢数据。常见做法是在事务 ID 里带上 subtask 编号和 Checkpoint 编号,比如 s0-chk5。
适用范围:本文验证的是自己实现的 Sink,没有验证 Kafka 等官方 connector。另外,只开 Checkpoint 并不等于端到端 exactly-once,还需要 Source 可重放、Sink 支持事务或幂等。
记住这几点
- 两阶段提交的
commit发生在 Checkpoint 完成之后,作业恢复时 Flink 会把恢复出来的事务再提交一次,这是设计如此。 - 自己写 Committer 必须幂等:识别“已提交”并调用
signalAlreadyCommitted()跳过。 - 事务 ID 重启前后必须唯一(带上 subtask 编号和 Checkpoint 编号),否则幂等判断会把新数据当成已提交而丢掉。