
踩坑实验室 #08:retryLater() 并不会“稍后”重试
Apache Flink 源码学习
作者 X老师(DaemonforY),Flink 2.3.0 源码,按 CC BY-NC-SA 4.0 发布。
基于 Flink 2.3.0 本机实测(核对日期 2026-10-02)。对应课程:第八讲《Source / Sink 新架构》。配套示例:
flink-notes/demos/src/main/java/study/connector/CommitRetryDemo.java
现象
自己实现 Sink 的 Committer 时,提交失败可以调用 request.retryLater() 请求重试(Committer.java:82-87)。从名字看,它像是“过一会儿再试”,很容易让人以为外部系统短暂不可用时,Flink 会等它恢复后再提交。
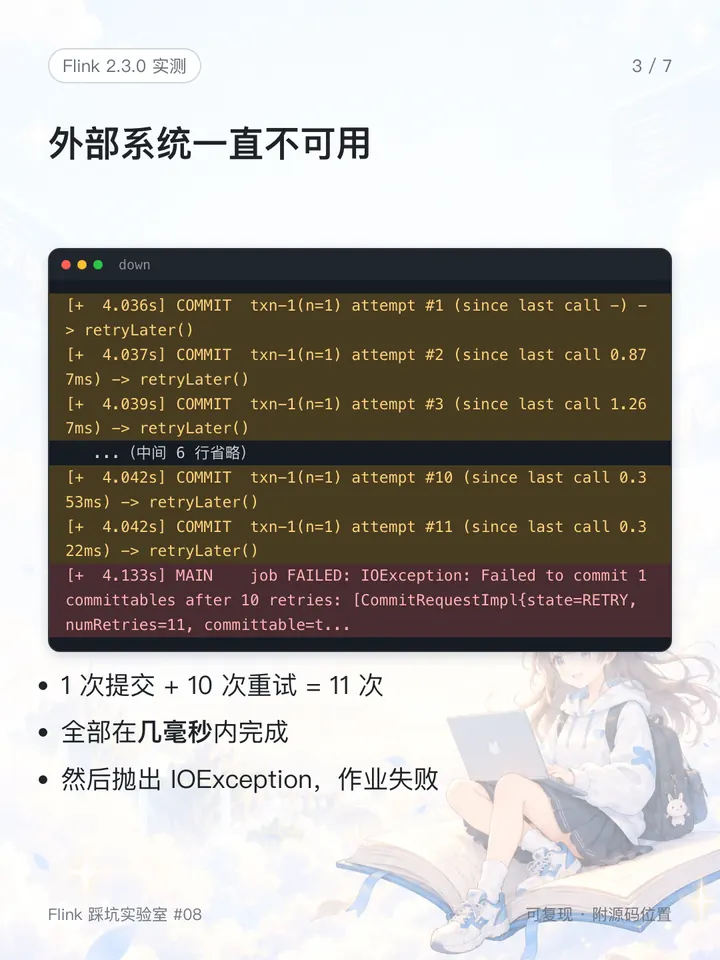
实测的结果并非如此:重试紧挨着上一次调用发生,间隔在 1 毫秒左右;如果外部系统一直不可用,1 次提交加 10 次重试在几毫秒内全部用完,随后抛出 IOException,作业失败。
复现
示例 CommitRetryDemo:并行度 1,Checkpoint 间隔 1 秒,不重启。两种模式:
| 模式 | 行为 |
|---|---|
flaky 3 | 第一个事务的前 3 次调用 retryLater(),第 4 次成功 |
down | 第一个事务永远调用 retryLater(),模拟外部系统一直不可用 |
flaky 3 的输出:
[+  2.659s] COMMIT  txn-1(n=1) attempt #1 (getNumberOfRetries=0, since last call -) -> retryLater()
[+  2.660s] COMMIT  txn-1(n=1) attempt #2 (getNumberOfRetries=1, since last call 0.919ms) -> retryLater()
[+  2.660s] COMMIT  txn-1(n=1) attempt #3 (getNumberOfRetries=2, since last call 0.420ms) -> retryLater()
[+  2.661s] COMMIT  txn-1(n=1) attempt #4 (getNumberOfRetries=3, since last call 0.308ms) -> OK
[+  3.610s] COMMIT  txn-3(n=10) attempt #1 (getNumberOfRetries=0, since last call 948.907ms) -> OK
...
[+  4.693s] MAIN    job FINISHED
down 的输出:
[+  4.036s] COMMIT  txn-1(n=1) attempt #1 (getNumberOfRetries=0, since last call -) -> retryLater()
[+  4.037s] COMMIT  txn-1(n=1) attempt #2 (getNumberOfRetries=1, since last call 0.877ms) -> retryLater()
...
[+  4.042s] COMMIT  txn-1(n=1) attempt #11 (getNumberOfRetries=10, since last call 0.322ms) -> retryLater()
[+  4.133s] MAIN    job FAILED: IOException: Failed to commit 1 committables after 10 retries: CommitRequestImpl{state=RETRY, numRetries=11, committable=t...
flaky 3 跑了 3 次,down 跑了 4 次,结论一致:
| 指标 | 实测 |
|---|---|
| 两次重试之间的间隔 | 0.17~1.27 毫秒,49 个间隔里 48 个不到 1 毫秒 |
down 模式的调用次数 | 每次都是 11 次(1 次提交 + 10 次重试)后失败 |
down 模式 11 次调用的间隔合计 | 约 2~6 毫秒(四次分别约 5.8、2.1、2.2、2.1 毫秒) |
| 对照:正常两次提交之间 | 约 1 秒(since last call 948.907ms),即 Checkpoint 间隔 |
原因
调用 retryLater() 之后,Flink 在同一次 notifyCheckpointComplete 中立即再次调用 commit()。源码是一个 for 循环(CheckpointCommittableManagerImpl.java:145-153):调用 commit(),筛出还没成功的请求,接着调用,循环里没有任何等待。
重试次数由 sink.committer.retries 控制,默认 10 次(SinkOptions.java:34-37),所以总共调用 11 次。用完还没成功,就抛出 IOException: Failed to commit ... after 10 retries,作业失败(CheckpointCommittableManagerImpl.java:155-160)。
这不是 bug,而是有意的设计。FLINK-36455(提交 bc0f241b867,2024-10-18)把重试从异步改成了同步,提交说明里的理由是:notifyCheckpointComplete 的约定要求 RPC 返回时所有事务都已提交,不能留到以后。因此,老资料里“异步重试”的说法在新版本里已经不成立。
怎么解决
retryLater() 本身并非没用:它确实会重试,只是立刻重试,对“偶发、瞬间就能恢复”的错误是有效的。问题出在外部系统需要几秒才能恢复的场景,这时有两种做法:
- 在
commit()内部自己退避:外部系统需要时间恢复时,在commit()里等待、重试,再决定是否调用retryLater()。 - 交给重启策略:让作业失败,由重启策略接管。开启 Checkpoint 时,默认是指数退避重启,从 1 秒开始。
走第二条路时要注意:重启后会从 Checkpoint 恢复,恢复时会把未确认的事务再提交一次(CommitterOperator.java:135-140,见踩坑实验室 #06),所以 Committer 必须幂等。
另外,本文验证的是自己实现的 Committer。官方 connector 在 commit() 内部如何处理异常、会不会自己等待,要看各自的实现,不能直接套用这里的结论。
记住这几点
retryLater()等于在同一次 Checkpoint 完成通知里立即重试,两次调用之间没有等待,实测间隔不到 1 毫秒。- 默认最多重试 10 次(共 11 次调用),用完抛出
IOException,作业失败;这是 FLINK-36455 有意的同步重试设计。 - 外部系统需要时间恢复时,在
commit()里自己退避,或交给重启策略;走重启时,Committer 必须幂等。