
S2 第 1 讲:全景图——一张图看懂 paimon-core
Apache Paimon 源码学习
作者 X老师(DaemonforY),Paimon 2.0 / master 源码,按 CC BY-NC-SA 4.0 发布。配套实验和代码在 GitHub。
TL;DR:paimon-core 可以看成四层——Catalog、Table、FileStore、存储结构。Paimon = 按 bucket 组织的 LSM 树(数据) + snapshot / manifest 元数据树(版本) + 乐观并发提交(ACID)。读源码从
FileStore.java这个“总控台”开始:newWrite、newCommit、newScan、newRead分别通向写入、提交、扫描、读取。本文所有调用链都是用 jdb 在真实运行中抓到的,不是凭记忆画的。
为什么要先看全景
paimon-core 的 src/main/java/org/apache/paimon 下有 971 个 Java 文件。直接从某个类读起,很容易迷失在各种 Abstract*、*Impl、*Provider 里。
S1 的 8 期内容,我们从“表目录里有什么文件”的角度把 Paimon 拆了一遍。S2 换一个角度:这些文件是被哪些类、按什么顺序写出来和读进去的。第一讲先画地图。
一、四层结构
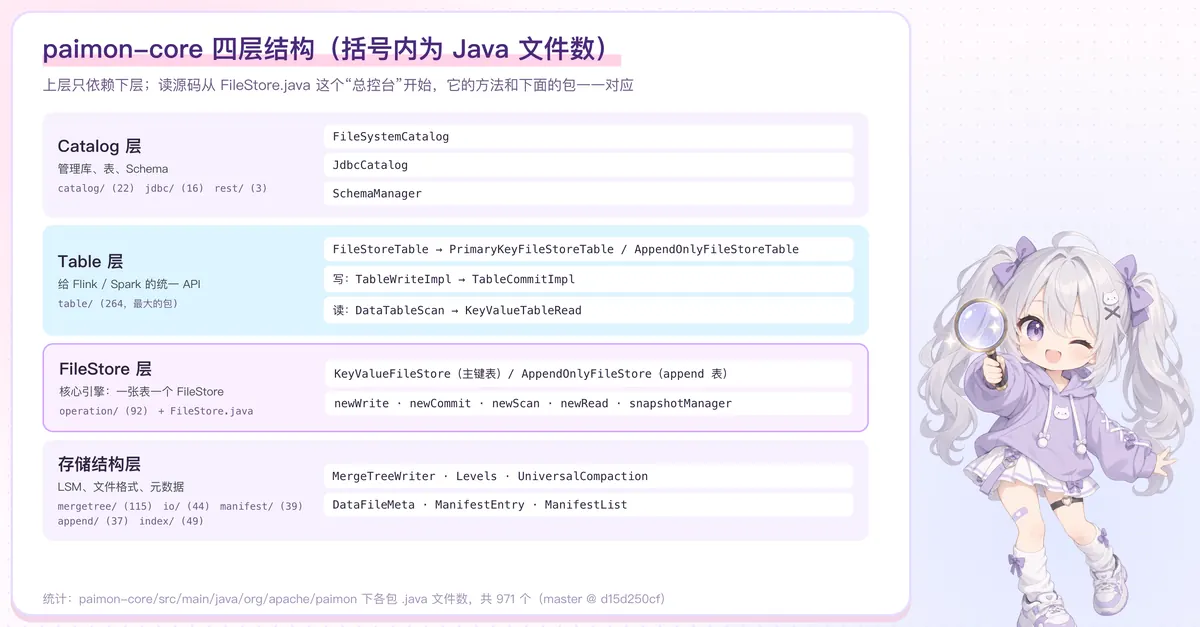
先看各包的规模(括号内为 Java 文件数,d15d250cf):
| 包 | 文件数 | 作用 |
|---|---|---|
table/ | 264 | 对外的 Table 抽象:FileStoreTable、sink、source、系统表 |
mergetree/ | 115 | LSM 核心:写缓冲、层级、合并、合并函数、lookup |
operation/ | 92 | FileStore 的操作:scan / write / commit / read / 过期 / 清理 |
utils/ | 56 | SnapshotManager、TagManager 等工具 |
index/ | 49 | 动态桶、删除向量等索引文件 |
io/ | 44 | 数据文件读写、DataFileMeta |
manifest/ | 39 | 元数据文件:ManifestEntry、ManifestFile、ManifestList |
append/ | 37 | append 表的写入与小文件合并 |
catalog/、jdbc/ | 22、16 | Catalog 实现 |
rest/在 paimon-core 里只有 3 个文件,REST Catalog 的主体不在这个模块,第 12 讲再展开。
按依赖关系,可以分成四层:
- Catalog 层:管理库、表、Schema(
FileSystemCatalog、JdbcCatalog、SchemaManager)。 - Table 层:给 Flink / Spark 的统一 API。
FileStoreTable有两个实现:建表时主键为空就是AppendOnlyFileStoreTable,否则是PrimaryKeyFileStoreTable(FileStoreTableFactory第 221 行)。写走TableWriteImpl → TableCommitImpl,读走DataTableScan → KeyValueTableRead。 - FileStore 层:核心引擎。主键表的
PrimaryKeyFileStoreTable.store()返回KeyValueFileStore,append 表对应AppendOnlyFileStore,二者都继承AbstractFileStore。 - 存储结构层:
mergetree/(LSM)、io/(数据文件)、manifest/(元数据)、append/、index/。
读源码的入口是 FileStore.java(第 65~118 行),它的方法和下面的包一一对应:
SnapshotManager snapshotManager();          // utils/
FileStoreScan newScan();                    // operation/ 扫描 manifest
SplitRead<T> newRead();                     // operation/ 读数据文件
FileStoreWrite<T> newWrite(String commitUser);          // operation/ → mergetree/
FileStoreCommit newCommit(String commitUser, FileStoreTable table);   // operation/
TagManager newTagManager();                 // tag/
主键表里存的不是普通的行,而是 KeyValue:key、sequenceNumber、valueKind(RowKind)、value,外加一个 level(KeyValue.java 第 47~53 行)。sequenceNumber 决定同一主键的新旧,S1 第 4、5 期的实验靠的就是它。
二、一棵元数据树
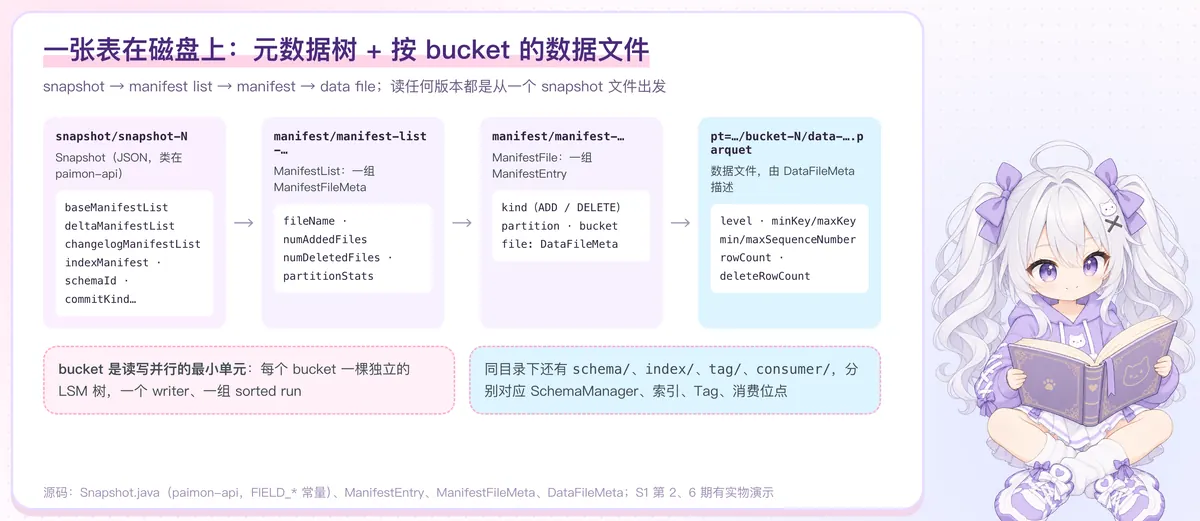
一张表在磁盘上,就是一棵从 snapshot 出发的树:
table/
├── snapshot/snapshot-N            ← Snapshot(JSON,类在 paimon-api)
│     ├─ baseManifestList            之前的全部文件
│     ├─ deltaManifestList           本次提交新增 / 删除的文件
│     ├─ changelogManifestList       本次产生的 changelog(供流读)
│     └─ indexManifest               索引文件(动态桶索引、删除向量)
├── manifest/
│     ├─ manifest-list-xxx         ← ManifestList:一组 ManifestFileMeta
│     └─ manifest-xxx              ← ManifestFile:一组 ManifestEntry(ADD / DELETE + DataFileMeta)
├── schema/schema-N                ← SchemaManager
└── pt=xx/bucket-N/data-xxx.parquet ← 数据文件(DataFileMeta 记录 level、min/max key、seq 范围…)
几个要点:
ManifestEntry= 文件类型(ADD / DELETE)+ 分区 + bucket +DataFileMeta。删文件也是“追加一条 DELETE 记录”,和数据层的 LSM 思路一致。DataFileMeta记着level、minKey / maxKey、minSequenceNumber / maxSequenceNumber、rowCount、deleteRowCount等,读的时候靠它裁剪、判断要不要归并。- bucket 是读写并行的最小单元:每个 bucket 一棵独立的 LSM 树、一个 writer。
S1 第 6 期用实验证明过:新快照复用旧快照的 manifest 和数据文件,时间旅行不复制数据。这就是这棵树的威力。
三、三条主线:用 jdb 抓真实调用栈
画调用链最容易出错的地方,是凭记忆把类名和顺序写错。所以这一讲的调用链全部来自真实运行:用 JDK 自带的 jdb 连上实验程序,在关键方法下断点,命中时执行 where 打印调用栈。
仓库里新增了一个脚本,一条命令就能复现(需要先按教程 01 章在 d15d250cf 上编译安装 2.2-SNAPSHOT,否则行号对不上):
cd labs && PAIMON_VERSION=2.2-SNAPSHOT ./jdb-stacks.sh sql/lab04/trace-write.sql jdb/s2-1-panorama.txt 30断点清单 jdb/s2-1-panorama.txt:
stop at org.apache.paimon.mergetree.MergeTreeWriter:166
stop at org.apache.paimon.mergetree.MergeTreeWriter:255
stop in org.apache.paimon.operation.FileStoreCommitImpl.tryCommitOnce
stop in org.apache.paimon.catalog.RenamingSnapshotCommit.commit
stop in org.apache.paimon.operation.AbstractFileStoreScan.plan
stop at org.apache.paimon.operation.RawFileSplitRead:167
stop at org.apache.paimon.operation.MergeFileSplitRead:253
两个小坑:
MergeTreeWriter.write有重载,jdb 要求写参数类型,所以改用行号;断点打在方法声明那一行(没有字节码)会报 “No code at line”,要打在方法体第一行。
实验 SQL 是 S1 第 5 期用过的那条:INSERT INTO trace_orders VALUES (1,'A'), (2,'B'), (1,'C'),并行度 1,然后查 $files 和整表。
主线 ①:写入——只进内存
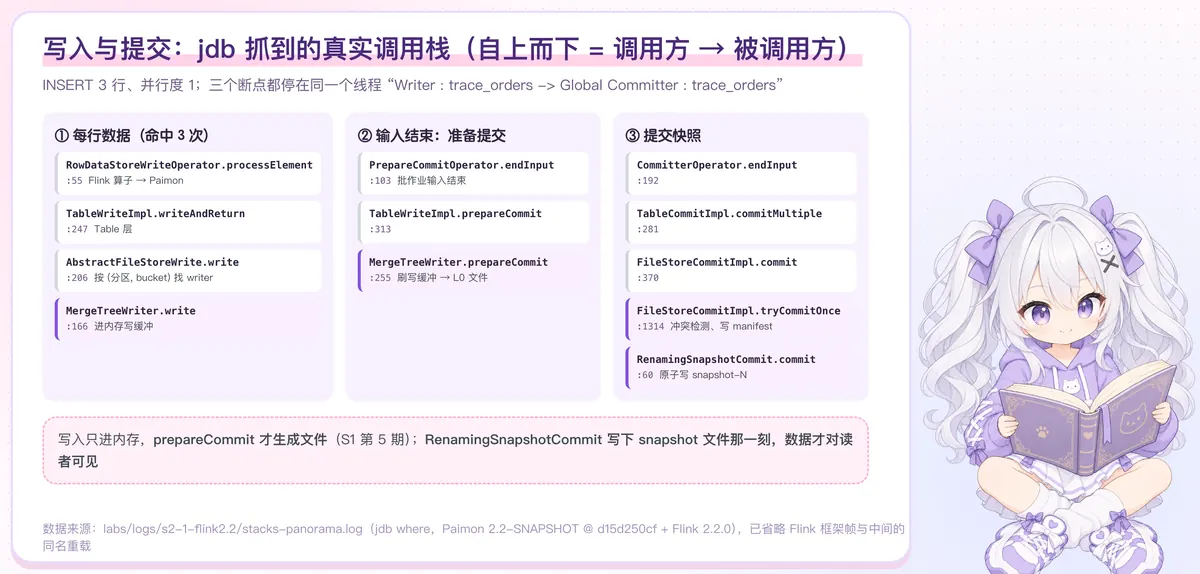
MergeTreeWriter.write 命中 3 次(3 行数据),调用栈(省略 Flink 框架帧和同名重载):
RowDataStoreWriteOperator.processElement   :55    Flink 算子 → Paimon
StoreSinkWriteImpl.write                   :143
TableWriteImpl.writeAndReturn              :247   Table 层
AbstractFileStoreWrite.write               :206   按 (分区, bucket) 找到 writer
MergeTreeWriter.write :166 分配 sequenceNumber,放进写缓冲这一步不产生任何文件,S1 第 5 期已经用实验看到过。
主线 ②:提交——prepareCommit 刷盘,snapshot 落地
批作业输入结束时,先在写端准备提交:
PrepareCommitOperator.endInput             :103   批作业输入结束(流作业是 checkpoint 前)
TableWriteOperator.prepareCommit           :143
TableWriteImpl.prepareCommit               :313
MemoryFileStoreWrite.prepareCommit         :155   KeyValueFileStoreWrite 的父类
AbstractFileStoreWrite.prepareCommit       :266
MergeTreeWriter.prepareCommit              :255   flushWriteBuffer → 写出 L0 文件
然后在提交端提交快照:
CommitterOperator.endInput                 :192
StoreCommitter.filterAndCommit             :123
TableCommitImpl.filterAndCommitMultiple    :330   幂等过滤
TableCommitImpl.commitMultiple             :281
FileStoreCommitImpl.commit                 :370
FileStoreCommitImpl.tryCommit              :885   重试循环
FileStoreCommitImpl.tryCommitOnce          :1314  冲突检测、写 manifest / manifest list
FileStoreCommitImpl.commitSnapshotImpl     :1737
RenamingSnapshotCommit.commit              :60    写 snapshot-N
RenamingSnapshotCommit 第 66 行调用 fileIO.tryToWriteAtomic:先写一个临时文件,再 rename 成 snapshot-N(FileIO.java 第 382~395 行)。rename 成功的那一刻,这次写入才对读者可见。rename 在不同文件系统上的原子性、并发提交时谁赢,是第 5 讲的内容。
一个细节:上面三个断点停在同一个线程里,线程名是 Writer : trace_orders -> Global Committer : trace_orders -> end: Writer (1/1)#0。并行度为 1 时,Flink 把 Writer 和 Committer 两个算子 chain 在了一起。
主线 ③:读取——规划在 JobManager,读文件在 TaskManager
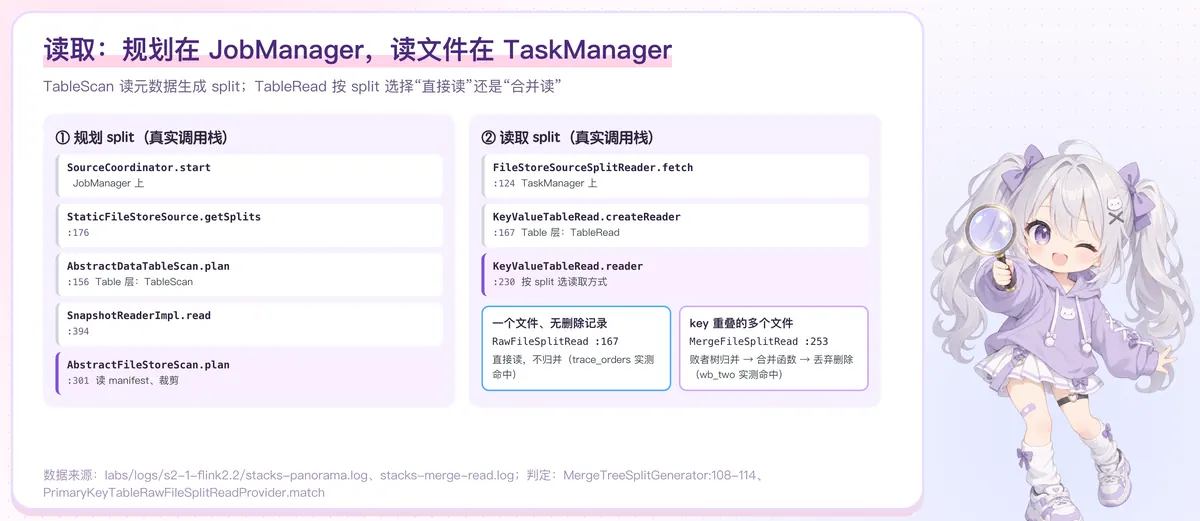
读取分两步。规划(读 manifest、生成 split)发生在 JobManager 的 SourceCoordinator 里,线程是 flink-pekko.actor.default-dispatcher-*:
SourceCoordinator.start                    (Flink)
StaticFileStoreSource.getSplits            :176
AbstractDataTableScan.plan                 :156   Table 层:TableScan
SnapshotReaderImpl.read                    :394
AbstractFileStoreScan.plan :301 读 manifest、按分区 / bucket / 统计信息裁剪读取发生在 TaskManager 的 Source Data Fetcher 线程:
FileStoreSourceSplitReader.fetch           :124
KeyValueTableRead.createReader             :167   Table 层:TableRead
KeyValueTableRead.reader                   :230   依次问 SplitReadProvider:这个 split 归谁读?
RawFileSplitRead.createReader :167 ← trace_orders 实测命中这里这里有个出乎意料的结果:trace_orders 是主键表,文件还在 level 0,但读的时候没有走合并读 MergeFileSplitRead,而是直接读 RawFileSplitRead——MergeFileSplitRead 这个类在整个作业里都没有被加载。
原因在 MergeTreeSplitGenerator.splitForBatch(第 108~114 行):文件先按 key 范围做区间划分,一个区间里只有一个文件、且没有删除记录时,这个 split 被标记为 rawConvertible,PrimaryKeyTableRawFileSplitReadProvider.match 就会接手,直接读文件。只有一个文件,自然不用归并。
换成 S1 第 5 期的 wb_two 表(分两次写入,两个文件的 key 重叠),再抓一次(jdb/s2-1-merge-read.txt),这次命中了合并读:
KeyValueTableRead.reader                   :230
SplitRead$1.createReader                   :103
MergeFileSplitReadProvider (lambda)        :53
MergeFileSplitRead.createReader            :253   区间划分 → 败者树归并 → 合并函数 → DropDeleteReader
同一次运行里还有一个对照:读 audit_log 系统表时,即使只有一个文件也走了 MergeFileSplitRead——因为 audit_log 要保留 -D 记录(forceKeepDelete),直接读的 provider 不接这种 split。
合并读内部的几个组件:IntervalPartition 做区间划分(第 338 行)、归并默认用败者树(sort-engine 默认 LOSER_TREE)、最后 DropDeleteReader 过滤掉删除记录(第 487 行)。什么时候能跳过归并、删除向量怎么帮忙,是第 6、7 讲的内容。
四、读源码路线
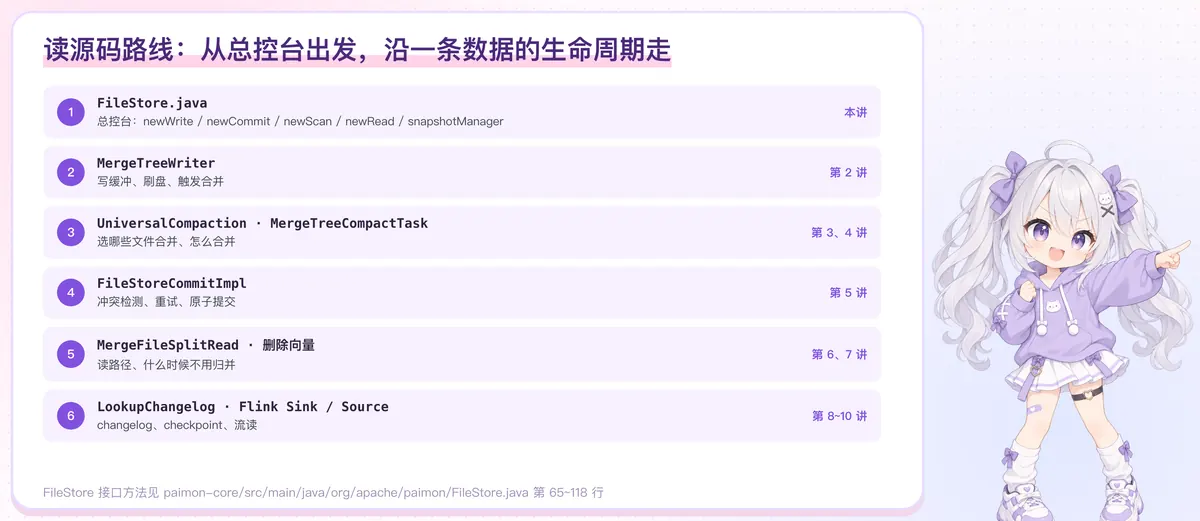
沿着一条数据的生命周期走:
| 顺序 | 从哪个类读 | 看什么 | 本系列 |
|---|---|---|---|
| 1 | FileStore.java | 总控台,方法和包一一对应 | 本讲 |
| 2 | MergeTreeWriter | 写缓冲、刷盘、触发合并 | 第 2 讲 |
| 3 | UniversalCompaction、MergeTreeCompactTask | 选哪些文件合并、怎么合并 | 第 3、4 讲 |
| 4 | FileStoreCommitImpl | 冲突检测、重试、原子提交 | 第 5 讲 |
| 5 | MergeFileSplitRead、删除向量 | 读路径、什么时候不用归并 | 第 6、7 讲 |
| 6 | Lookup changelog、Flink Sink / Source | changelog、checkpoint、流读 | 第 8~10 讲 |
建议的读法:先跑一遍 jdb-stacks.sh 拿到调用栈,再对着栈一层层点进源码。调用栈告诉你“谁调用了谁”,源码告诉你“为什么这样调用”,两者对着看,比从入口硬读快得多。
小结
- 四层:Catalog / Table / FileStore / 存储结构;主键表
PrimaryKeyFileStoreTable+KeyValueFileStore,append 表AppendOnlyFileStoreTable+AppendOnlyFileStore。 - 一棵树:snapshot → manifest list → manifest → 数据文件;bucket 是并行单元。
- 三条主线:写进内存 → prepareCommit 刷成 L0 文件 → 提交写下 snapshot 才可见;读时先规划 split,再按 split 选择直接读或合并读。
下一讲:一条数据的写入之旅——MergeTreeWriter 里的写缓冲、刷盘和合并触发。
自测题:trace_orders 如果连续写两次(不 DROP 表),第二次查询整表时会命中 RawFileSplitRead 还是 MergeFileSplitRead?(答案:取决于两个文件的 key 范围是否重叠。实验里两次都写订单 1,key 重叠,会被划进同一个区间,走 MergeFileSplitRead;如果第二次写的是全新的订单号且 key 范围不重叠,两个区间各一个文件,仍然可以直接读。未单独运行,可以用 jdb-stacks.sh 自己验证。)