
踩坑实验室 #13:并行度从 2 改成 3,有一个子任务要读两份状态
Apache Flink 源码学习
作者 X老师(DaemonforY),Flink 2.3.0 源码,按 CC BY-NC-SA 4.0 发布。
基于 Flink 2.3.0 本机实测(核对日期 2026-10-03)。对应课程:第三讲(上)第五节“扩缩容:状态是怎么切开的”、第三讲(下)第四节“RocksDB 怎么切分状态”。配套示例:
flink-notes/demos/src/main/java/study/state/StateBackendDemo.java、flink-notes/demos/src/main/java/study/state/RescaleOverlapDemo.java
现象
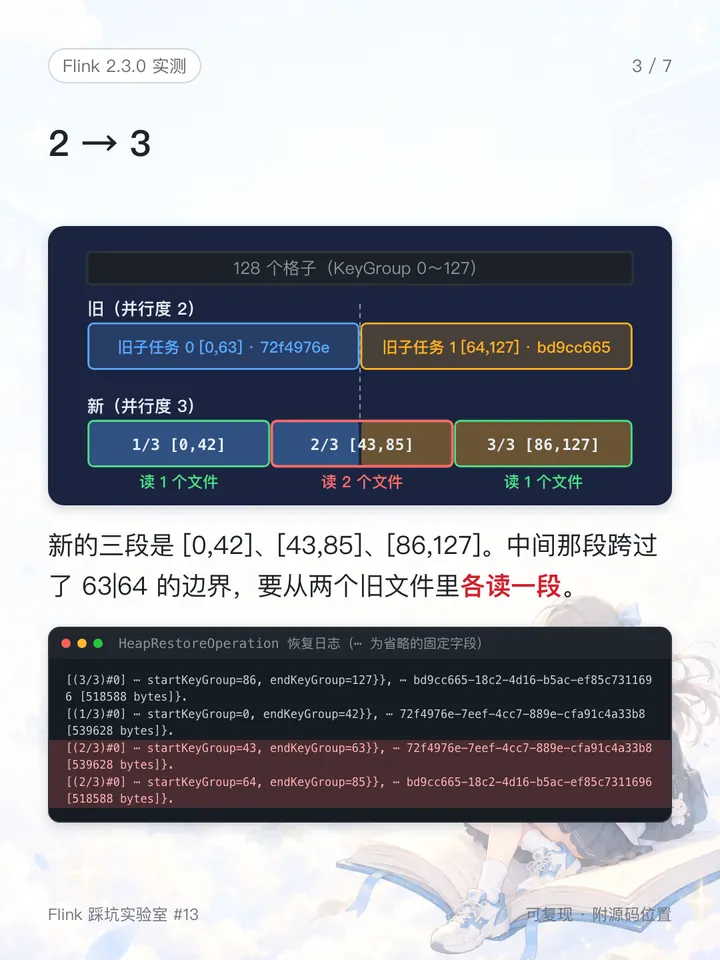
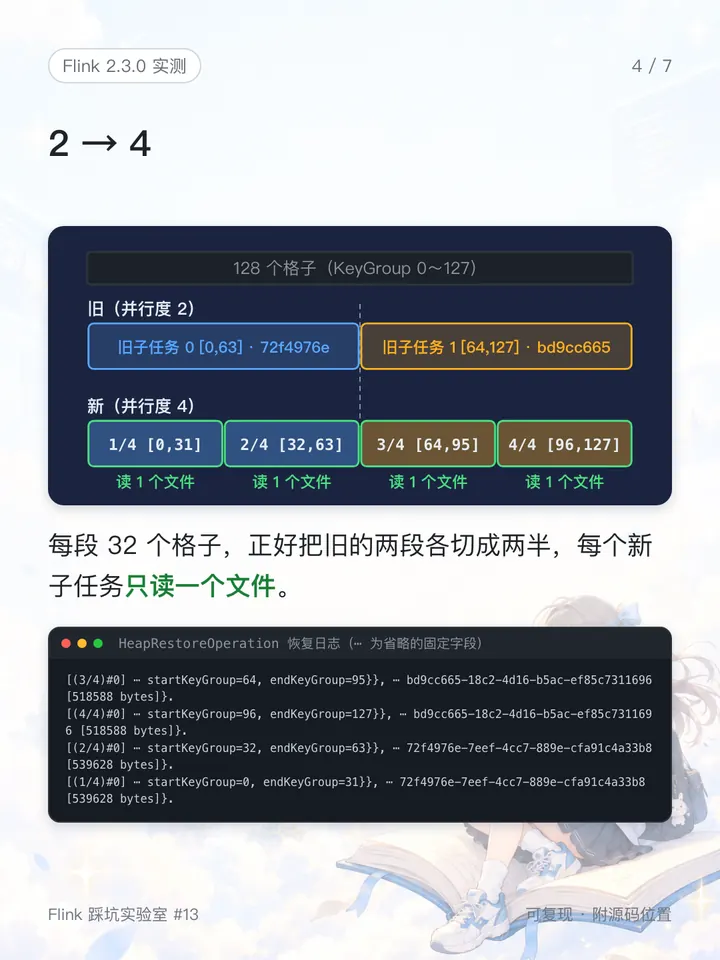
作业从并行度 2 的 Checkpoint 恢复成并行度 3,打开恢复日志会发现:中间那个子任务同时读了两个旧子任务的状态文件,另外两个子任务各读一个。换成恢复到并行度 4,每个新子任务都只读一个文件。扩到 3 和扩到 4,状态的切法完全不一样。
复现
实测一:StateBackendDemo,HashMap 状态后端,maxParallelism 128,并行度 2 生成 Checkpoint(chk-5 里有两个状态文件,分别属于旧子任务 0 和 1),再分别恢复成并行度 3 和 4。下面整理自 HeapRestoreOperation 的 "Starting to restore from state handle" 日志(HeapRestoreOperation.java:123),每一行表示一个新子任务从一个文件里读了一段 KeyGroup:
# 2 -> 3
subtask 1/3  keyGroups=[0,42]   file=72f4976e (539628 bytes)    ← 旧子任务 0
subtask 2/3  keyGroups=[43,63]  file=72f4976e (539628 bytes)    ← 旧子任务 0
subtask 2/3  keyGroups=[64,85]  file=bd9cc665 (518588 bytes)    ← 旧子任务 1
subtask 3/3  keyGroups=[86,127] file=bd9cc665 (518588 bytes)    ← 旧子任务 1

# 2 -> 4
subtask 1/4  keyGroups=[0,31]   file=72f4976e (539628 bytes)
subtask 2/4  keyGroups=[32,63]  file=72f4976e (539628 bytes)
subtask 3/4  keyGroups=[64,95]  file=bd9cc665 (518588 bytes)
subtask 4/4  keyGroups=[96,127] file=bd9cc665 (518588 bytes)
文件名只保留了前 8 位:72f4976e 是旧子任务 0(KeyGroup 0~63)的文件,bd9cc665 是旧子任务 1(64~127)的。恢复后每个子任务的 restoredKeys 都等于 keys:2→3 是 359 / 311 / 330,2→4 是 271 / 239 / 238 / 252,合计都是 1000。
实测二:RescaleOverlapDemo 不启动作业,直接调用 Flink 自己的 KeyGroupRangeAssignment.computeKeyGroupRangeForOperatorIndex 和 KeyGroupRange.getIntersection,计算各种调整下每个新子任务要读几个旧子任务的状态(maxParallelism 128):
| 调整 | 读多份的新子任务 | 每个新子任务读的个数 |
|---|---|---|
| 2 → 3 | 3 个里 1 个 | [1,2,1] |
| 2 → 4 | 0 个 | [1,1,1,1] |
| 3 → 4 | 4 个里 2 个 | [1,2,2,1] |
| 4 → 6 | 6 个里 2 个 | [1,2,1,1,2,1] |
| 4 → 8 | 0 个 | 全部为 1 |
| 10 → 12 | 12 个里 8 个 | [1,2,2,2,2,1,1,2,2,2,2,1] |
| 10 → 20 | 0 个 | 全部为 1 |
| 8 → 6 | 6 个全部 | [2,2,2,2,2,2] |
| 4 → 3 | 3 个全部 | [2,2,2] |
| 4 → 2 | 2 个全部 | [2,2] |
其中 2→3 和 2→4 两行,和实测一的恢复日志完全对得上。
原因
keyed state 按 KeyGroup 存储,KeyGroup 按连续区间分给子任务(KeyGroupRangeAssignment.java:93,computeKeyGroupRangeForOperatorIndex)。并行度 2 时,两个子任务分别管 [0,63] 和 [64,127]。
扩缩容恢复时,JobManager 按新的并行度重新划分区间,再和每个旧子任务的区间求交集,相交的部分就要读(StateAssignmentOperation.java:105 的 assignStates、:710 的 createKeyGroupPartitions、:679 的 extractIntersectingState)。改成 3 之后,新的三段是 [0,42]、[43,85]、[86,127],中间那段正好跨过了 63 和 64 的边界,所以要从两个旧文件里各读一段。改成 4 时每段 32 个 KeyGroup,正好把旧的两段各切成两半,每个新子任务只读一个文件。
读一份和读多份,在不同状态后端上的处理方式不同:
- HashMap 状态后端:按偏移表只读相交的那些 KeyGroup(
KeyGroupsStateHandle.java:104,getIntersection)。 - RocksDB 状态后端:只有一个来源时,打开后用
deleteRange裁掉不属于自己的部分(RocksDBIncrementalCheckpointUtils.java:134,clipDBWithKeyGroupRange);有多个来源时,打开一个并裁剪,再把其他来源的数据合并进来(RocksDBIncrementalRestoreOperation.java:422,restoreFromMultipleStateHandles)。
怎么解决
这不是一个会出错的坑:不管读几份,状态都能完整恢复,实测 1000 个 key 一个不少。它影响的是恢复时走哪条路径。
- 并行度可以随便调,只要不超过 maxParallelism(见踩坑实验室 #12);按整数倍扩容(2→4、4→8、10→20)只是让每个新子任务读的文件更少。
- 状态很大、用 RocksDB 时,扩容可以优先考虑整数倍,让每个新子任务走“打开后裁剪”的路径,避免合并。具体能快多少取决于状态大小,本文没有测量恢复时间,不能说成“扩到 4 一定比扩到 3 快”。HashMap 后端按偏移只读需要的部分,读的总数据量差不多。
- 缩容时,上表的几个例子里每个新子任务都要读 2 个;缩得更多(比如 8→2)时会读更多个,并不固定是 2 个。
以上只针对 keyed state。operator state 按 round-robin 等方式重新分配,不按 KeyGroup,规则不同。
记住这几点
- keyed state 按 KeyGroup 区间分配,扩缩容时新区间和每个旧子任务的区间求交集,跨过旧边界的子任务要读多份。
- 按整数倍扩容时,每个新子任务只读一份旧状态;非整数倍扩容和缩容时,有的要读两份或更多。
- 不管读几份,状态都能完整恢复;RocksDB 读一份只需裁剪,读多份还要合并,状态很大时可以优先考虑整数倍扩容。