
踩坑实验室 #14:开了非对齐 Checkpoint,3 秒变 20 毫秒,代价是什么?
Apache Flink 源码学习
作者 X老师(DaemonforY),Flink 2.3.0 源码,按 CC BY-NC-SA 4.0 发布。
基于 Flink 2.3.0 本机实测(核对日期 2026-10-03)。对应课程:第二讲(上)《Checkpoint 全流程》、第二讲(下)《非对齐 Checkpoint》。配套示例:
flink-notes/demos/src/main/java/study/checkpoint/CheckpointDemo.java
现象
作业有背压时,每次 Checkpoint 要 3 秒左右。打开非对齐 Checkpoint 之后,每次只要几十毫秒,可 Checkpoint 的大小从 5.7KB 涨到了约 600KB,差不多是原来的 100 倍。快了,也大了,多出来的是什么?
复现
示例 CheckpointDemo:并行度 2,keyBy 之后的算子人为变慢制造背压,每 5 秒一次 Checkpoint。三次运行(slow、slow unaligned、slow mixed),取第 2~6 次 Checkpoint。
实测一:CheckpointCoordinator 的 "Completed checkpoint" 日志:
| 配置 | 每次耗时 | 每次大小 |
|---|---|---|
| 对齐(默认) | 2742~3290 ms | 5714 B |
| 非对齐 | 20~45 ms | 595~666 KB |
非对齐 + aligned-checkpoint-timeout = 1 秒 | 1014~1023 ms | 329~410 KB |
写第二讲下篇时也跑过一次,趋势一致,具体数字有波动:对齐 3 秒左右,非对齐几十毫秒,折中方案 1 秒左右。
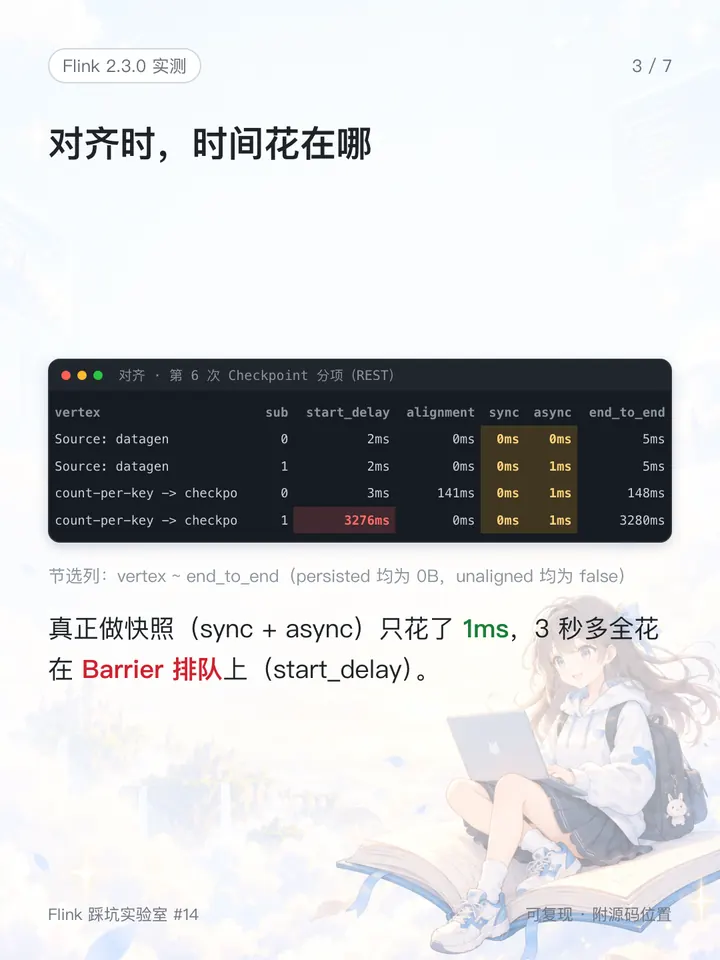
实测二:示例通过 REST 接口查询的第 6 次 Checkpoint 分项(节选):
# 对齐
>>>   vertex                   sub   start_delay  alignment     sync    async   end_to_end  persisted  unaligned
>>>   count-per-key -> checkpo 0             3ms      141ms      0ms      1ms        148ms         0B      false
>>>   count-per-key -> checkpo 1          3276ms        0ms      0ms      1ms       3280ms         0B      false

# 非对齐
>>>   Source: datagen          0             2ms        0ms      0ms      7ms         11ms    262329B       true
>>>   Source: datagen          1             2ms        0ms      0ms      7ms         11ms    306224B       true
>>>   count-per-key -> checkpo 0             6ms        0ms      0ms      3ms         11ms      5944B       true
>>>   count-per-key -> checkpo 1             9ms        0ms      0ms      0ms         11ms     28671B       true
REST 接口统计的耗时、大小和 "Completed checkpoint" 日志的口径不完全一样(比如第 6 次非对齐 Checkpoint,日志里是 20ms、608882 B,REST 里是 11ms、608866 B),两处数字各自引用,不要混用。
原因
先看对齐模式慢在哪。子任务 1 的 start_delay(从 Checkpoint 触发到这个子任务收到第一个 Barrier)是 3276ms,而真正做快照的 sync、async 只有 0~1ms。也就是说,快照本身并不慢,时间全花在 Barrier 排队上:Barrier 和数据走同一条通道,下游处理不过来,通道里堆满了数据,Barrier 只能排在积压的数据后面,在路上等了 3 秒。
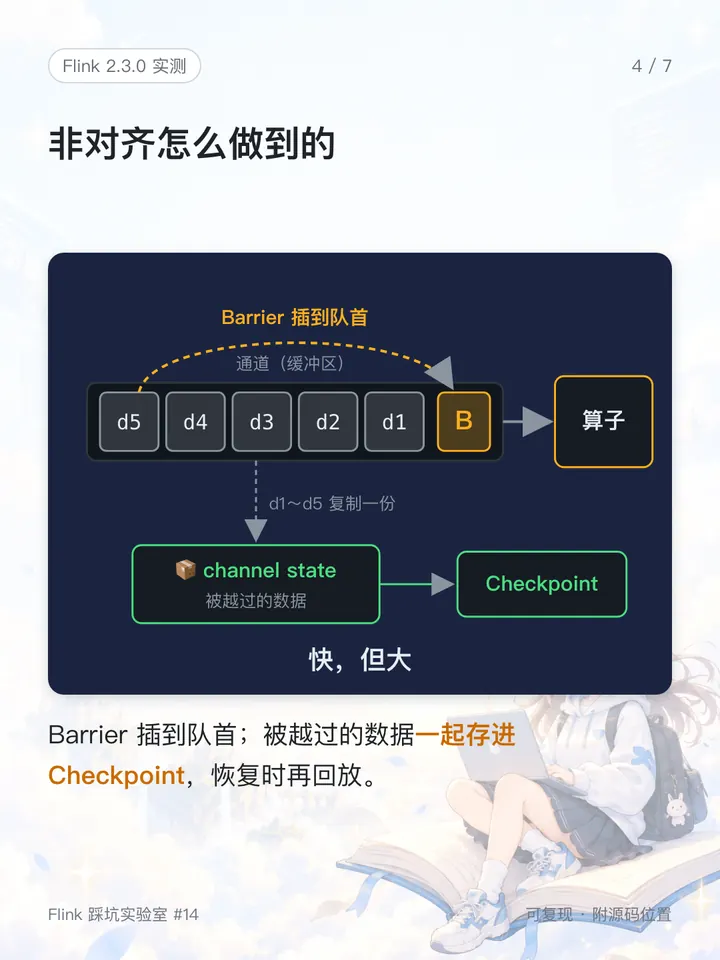
非对齐 Checkpoint 的做法是让 Barrier 插到队首,越过积压的数据(PipelinedSubpartition.java:219、:241)。被越过的数据还没有处理,于是把这些在途数据(in-flight data)一起存进 Checkpoint,恢复时再回放。所以非对齐 Checkpoint 快,但大:变快的是 Barrier 不用排队了,而不是快照变快了。
多出来的数据大部分在 Source 上。分项表里的 persisted 列就是被越过、一起存下来的数据:两个 Source 分别是 262KB、306KB,下游计数算子只有 6KB、29KB,主要是 Source 输出缓冲区里被越过的数据。
怎么解决
非对齐 Checkpoint 默认关闭(execution.checkpointing.unaligned.enabled 默认 false,CheckpointingOptions.java:539)。比起直接打开,更稳妥的折中是同时设置对齐超时:先按对齐的方式做,超过这个时间才切换成非对齐(execution.checkpointing.aligned-checkpoint-timeout,CheckpointingOptions.java:565,默认 0)。
execution.checkpointing.unaligned.enabled: true
execution.checkpointing.aligned-checkpoint-timeout: 1s
本例设成 1 秒后,每次约 1 秒,大小约 330~410KB,介于两者之间。
使用前要清楚它的限制和代价:
- 只支持 EXACTLY_ONCE 模式;Savepoint 永远是对齐的;部分连接方式会被强制对齐(
InputProcessorUtil.java:119-124、CheckpointOptions.java:78、SubtaskCheckpointCoordinatorImpl.java:324-329)。 - Checkpoint 会变大(本例约 100 倍);恢复时要先回放通道里的数据,所以恢复会变慢。这是源码层面的结论,具体慢多少没有实测。
- 它不解决背压本身:背压还在,只是不再拖慢 Checkpoint,窗口结果照样会被推迟(见踩坑实验室 #05)。
- 本文只测了这一个作业。状态很大、在途数据很多时,Checkpoint 体积和恢复时间都要单独评估,不是所有场景都该开。
记住这几点
- 背压下对齐 Checkpoint 慢,是因为 Barrier 排在积压的数据后面,快照本身只要 1 毫秒左右。
- 非对齐 Checkpoint 让 Barrier 插队,代价是把被越过的在途数据一起存下来:快了,但大,恢复时还要回放。
- 非对齐默认关闭,可以配合
aligned-checkpoint-timeout折中;它解决的是 Checkpoint 被拖慢,不是背压。