
S1 第 5 期:3 行数据写进去,文件里只有 2 行?
Apache Paimon 源码学习
作者 X老师(DaemonforY),Paimon 2.0 / master 源码,按 CC BY-NC-SA 4.0 发布。配套实验和代码在 GitHub。
TL;DR:Paimon 主键表的写入先进内存里的写缓冲,不会立刻生成文件;提交前刷盘时,缓冲里的数据按“主键 + 写入顺序号”排好序,同一主键的多条记录交给合并引擎合成一条再写进 L0 文件。所以一次写 3 行、其中两行主键相同,文件里就只有 2 条。这种合并只发生在同一个缓冲内——分两次提交,旧版本就会留在磁盘上,要靠读取时归并或 compaction 去掉。
实验准备
一张最简单的主键表,1 个桶:
CREATE TABLE wb_one (
  order_id BIGINT,
  status   STRING,
  PRIMARY KEY (order_id) NOT ENFORCED
) WITH ('bucket' = '1');

INSERT INTO wb_one VALUES (1, 'A'), (2, 'B'), (1, 'C');
订单 1 在同一条 INSERT 里出现了两次:先 A,后 C。
完整 SQL 在仓库
labs/sql/lab04/compare-write-buffer.sql,一条命令复现:cd labs && ./run.sh sql/lab04/compare-write-buffer.sql
现象:写了 3 行,文件里只有 2 条
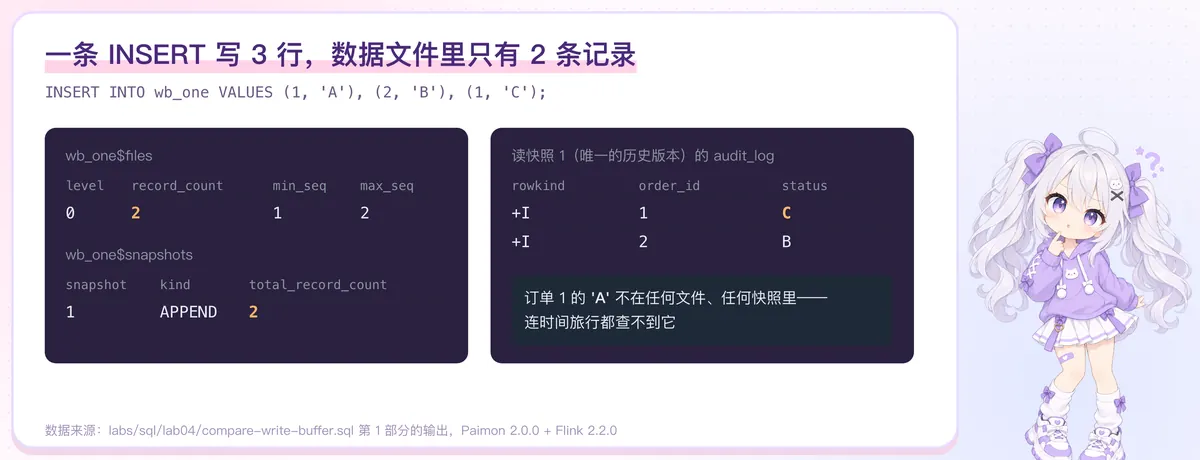
(节选自 labs/logs/ep5-flink2.2/compare.log,省略了中间的 INFO 日志和异常堆栈):
Flink SQL> SELECT snapshot_id, commit_kind, total_record_count, delta_record_count FROM `wb_one$snapshots`;
+----------------------+--------------------------------+----------------------+----------------------+
|          snapshot_id |                    commit_kind |   total_record_count |   delta_record_count |
+----------------------+--------------------------------+----------------------+----------------------+
|                    1 |                         APPEND |                    2 |                    2 |
+----------------------+--------------------------------+----------------------+----------------------+
1 row in set

Flink SQL> SELECT level, record_count, min_sequence_number, max_sequence_number FROM `wb_one$files`;
+-------------+----------------------+----------------------+----------------------+
|       level |         record_count |  min_sequence_number |  max_sequence_number |
+-------------+----------------------+----------------------+----------------------+
|           0 |                    2 |                    1 |                    2 |
+-------------+----------------------+----------------------+----------------------+
1 row in set- 只有 1 个数据文件,里面 2 条记录;
- sequence 范围是 1 ~ 2——seq 0 那条去哪了?
再用 audit_log 读一下快照 1(这张表唯一的历史版本):
SELECT * FROM `wb_one$audit_log` /*+ OPTIONS('scan.snapshot-id' = '1') */;+--------------------------------+----------------------+--------------------------------+
| rowkind | order_id | status |
+--------------------------------+----------------------+--------------------------------+
| +I | 1 | C |
| +I | 2 | B |
+--------------------------------+----------------------+--------------------------------+
2 rows in set订单 1 的 'A' 不在任何文件、任何快照里,时间旅行也查不到它。它从来没有落过盘。
原因:写缓冲在刷盘时按主键合并
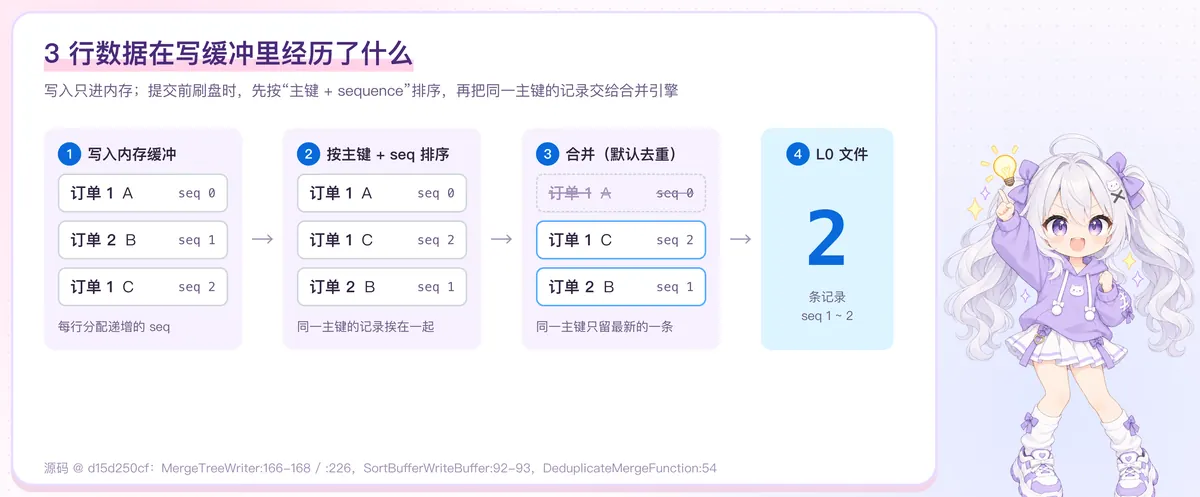
主键表每个桶有一个 MergeTreeWriter,写入分两步:
第 1 步:写入只进内存。 MergeTreeWriter.write(第 166~168 行)给每条记录分配一个递增的 sequence number,然后 writeBuffer.put(...) 放进内存排序缓冲。此时磁盘上一个数据文件都没有。
| 写入顺序 | 主键 | 值 | seq |
|---|---|---|---|
| 1 | 订单 1 | A | 0 |
| 2 | 订单 2 | B | 1 |
| 3 | 订单 1 | C | 2 |
第 2 步:提交前刷盘。 批作业在输入结束时、流作业在每次 checkpoint 前,都会调用 prepareCommit → flushWriteBuffer(第 254~255 行)。刷盘时(第 226 行 writeBuffer.forEach):
- 缓冲按主键升序、再按 seq 升序排序(
SortBufferWriteBuffer第 92~93 行把 sequence 字段追加到排序字段末尾),同一主键的记录挨在一起:(1,A,0)、(1,C,2)、(2,B,1); - 同一主键的一组记录交给表的合并引擎。默认的
DeduplicateMergeFunction每来一条就覆盖上一条(第 54 行latestKv = kv),留下的就是 seq 最大的那条; - 合并结果写进一个 L0 文件:
(1,C,2)、(2,B,1)——正好是$files里的 2 条、seq 1~2。
想亲眼看这个过程,可以按实验 4 的断点清单在
DeduplicateMergeFunction.java:59 return latestKv;打断点:订单 1 命中时latestKv的值是 C、seq 是 2。
对照:同样 3 行,分两次写
INSERT INTO wb_two VALUES (1, 'A'), (2, 'B');
INSERT INTO wb_two VALUES (1, 'C');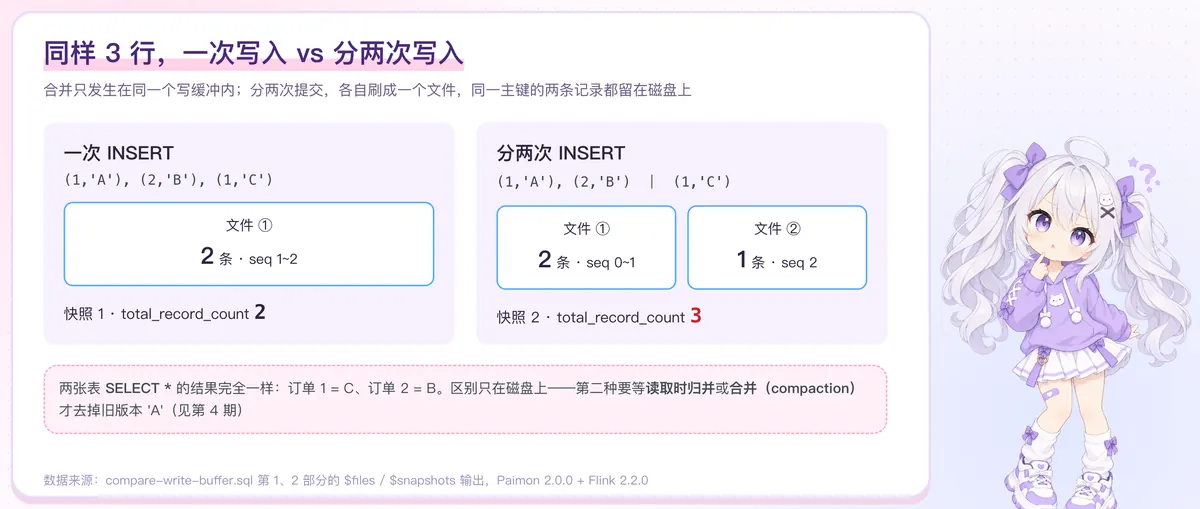
(节选自 labs/logs/ep5-flink2.2/compare.log,省略了中间的 INFO 日志和异常堆栈):
Flink SQL> SELECT snapshot_id, commit_kind, total_record_count, delta_record_count FROM `wb_two$snapshots`;
+----------------------+--------------------------------+----------------------+----------------------+
|          snapshot_id |                    commit_kind |   total_record_count |   delta_record_count |
+----------------------+--------------------------------+----------------------+----------------------+
|                    1 |                         APPEND |                    2 |                    2 |
|                    2 |                         APPEND |                    3 |                    1 |
+----------------------+--------------------------------+----------------------+----------------------+
2 rows in set

Flink SQL> SELECT level, record_count, min_sequence_number, max_sequence_number FROM `wb_two$files`;
+-------------+----------------------+----------------------+----------------------+
|       level |         record_count |  min_sequence_number |  max_sequence_number |
+-------------+----------------------+----------------------+----------------------+
|           0 |                    1 |                    2 |                    2 |
|           0 |                    2 |                    0 |                    1 |
+-------------+----------------------+----------------------+----------------------+
2 rows in set
这次是 2 个文件、3 条记录:第一次提交刷出 seq 0~1,第二次提交只有 seq 2。两个缓冲各自刷盘,订单 1 的 A 和 C 不在同一个缓冲里,谁也合并不了谁。
但 SELECT * FROM wb_two 的结果和 wb_one 一模一样:订单 1 = C,订单 2 = B。区别只在磁盘上:旧版本 A 还在,要等读取时归并(每次查询都做一遍)或 compaction(重写一次,以后都不用再做)去掉——这正是第 4 期讲的内容。
所以结论要说准确:写入时合并只发生在同一个写缓冲内。一次提交里同一主键写了很多次(比如一个 checkpoint 周期里同一个用户更新了 100 次状态),落盘时只会剩 1 条;跨提交的多个版本,写缓冲管不了。
“合并”不等于“丢掉一行”
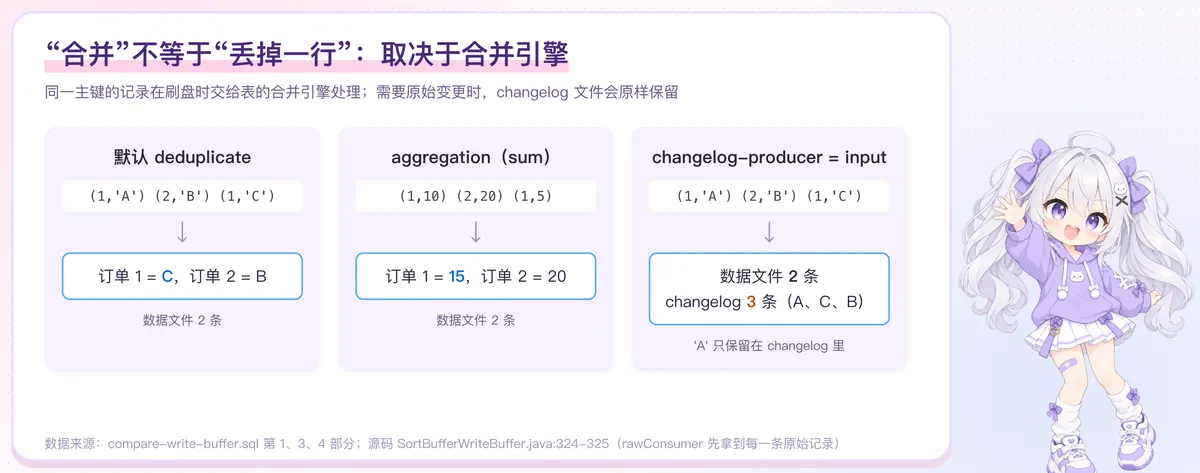
刷盘时调用的是表配置的合并引擎,不一定是“留最新”。换成聚合引擎试试:
CREATE TABLE wb_agg (
  order_id BIGINT,
  amount   INT,
  PRIMARY KEY (order_id) NOT ENFORCED
) WITH (
  'bucket' = '1',
  'merge-engine' = 'aggregation',
  'fields.amount.aggregate-function' = 'sum'
);

INSERT INTO wb_agg VALUES (1, 10), (2, 20), (1, 5);
数据文件同样只有 2 条记录,查询结果是订单 1 = 15、订单 2 = 20——两行没有“丢一行”,而是在刷盘时加在了一起。
那如果下游确实需要每一条原始变更呢?给表加上 'changelog-producer' = 'input':
(节选自 labs/logs/ep5-flink2.2/compare.log,省略了中间的 INFO 日志和异常堆栈):
Flink SQL> SELECT level, record_count FROM `wb_input$files`;
+-------------+----------------------+
|       level |         record_count |
+-------------+----------------------+
|           0 |                    2 |
+-------------+----------------------+
1 row in set

Flink SQL> SELECT * FROM `wb_input$audit_log` /*+ OPTIONS('incremental-between' = '0,1', 'incremental-between-scan-mode' = 'changelog') */;
+--------------------------------+----------------------+--------------------------------+
|                        rowkind |             order_id |                         status |
+--------------------------------+----------------------+--------------------------------+
|                             +I |                    1 |                              A |
|                             +I |                    1 |                              C |
|                             +I |                    2 |                              B |
+--------------------------------+----------------------+--------------------------------+
3 rows in set

$ echo '=== wb_input 的文件 ===' && find ${warehouse_dir}/default.db/wb_input -name '*.parquet' | sed 's|.*/wb_input/||' | sort
=== wb_input 的文件 ===
bucket-0/changelog-b529b708-6fbe-40f4-90d4-3d51926ec55d-0.parquet
bucket-0/data-b529b708-6fbe-40f4-90d4-3d51926ec55d-1.parquet
(文件名中的 UUID 每次运行都不同。)
表目录下多了一个 changelog-*.parquet:数据文件还是 2 条,changelog 文件原样保留 3 条。源码里,刷盘遍历缓冲时每读出一条原始记录,都会先交给 rawConsumer(SortBufferWriteBuffer 第 324~325 行)写进 changelog,然后才进入合并(MergeTreeWriter 第 218~221 行只有 changelog-producer = input 时才创建这个 changelog writer)。
写缓冲装不下怎么办?
上面的数据只有 3 行,缓冲当然装得下。如果一次提交写入的数据比缓冲大呢?做个极端实验:50000 行,只有 10 个不同的主键,写缓冲压到最小的 256 kb,并关闭自动 compaction(write-only)以免干扰。
-- 两张表只差一个参数
'write-buffer-size' = '256 kb', 'page-size' = '64 kb', 'write-only' = 'true'
-- wb_nospill 额外加上:
'write-buffer-spillable' = 'false'

INSERT INTO wb_spill   SELECT id % 10, id FROM gen;   -- gen:id 从 1 到 50000
INSERT INTO wb_nospill SELECT id % 10, id FROM gen;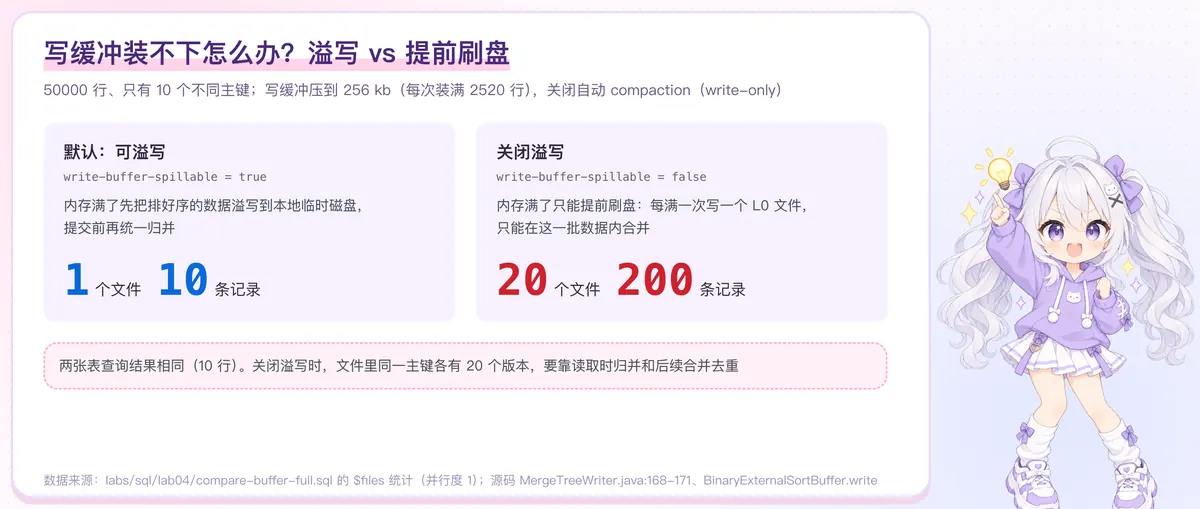
(节选自 labs/logs/ep5-flink2.2/buffer-full.log,两条查询分别输出,省略了中间的 INFO 日志和异常堆栈):
Flink SQL> SELECT 'spill' AS t, COUNT(*) AS files, SUM(record_count) AS records FROM `wb_spill$files`;
+--------------------------------+----------------------+----------------------+
|                              t |                files |              records |
+--------------------------------+----------------------+----------------------+
|                          spill |                    1 |                   10 |
+--------------------------------+----------------------+----------------------+
1 row in set

Flink SQL> SELECT 'nospill' AS t, COUNT(*) AS files, SUM(record_count) AS records FROM `wb_nospill$files`;
+--------------------------------+----------------------+----------------------+
|                              t |                files |              records |
+--------------------------------+----------------------+----------------------+
|                        nospill |                   20 |                  200 |
+--------------------------------+----------------------+----------------------+
1 row in set- 默认(可溢写):内存满了,
BinaryExternalSortBuffer把排好序的数据溢写到本地临时磁盘,提交前再把内存和磁盘上的有序数据统一归并。结果还是 1 个文件、10 条记录,5 万行在写入时就合并完了。 - 关闭溢写:
writeBuffer.put返回 false,MergeTreeWriter只能提前刷盘(第 168~171 行),每满一次写一个 L0 文件。从每个文件的 seq 范围(2510~2519、5030~5039……)能看出缓冲每装满 2520 行就刷一次,一共 20 个文件,每个 10 条——每个文件只能在自己这批数据里合并。
两张表的查询结果完全相同(10 行,k=1 的值是 49991,即最后写入的那条),差别还是在磁盘上:关闭溢写时,每个主键都在 20 个文件里各有一个版本。
溢写默认开启,磁盘用量上限
write-buffer-spill.max-disk-size默认不限。生产里如果看到一次提交就产生大量 L0 小文件,可以先检查这两个参数和write-buffer-size。
同一主键的旧版本,在三个时刻被“合并掉”
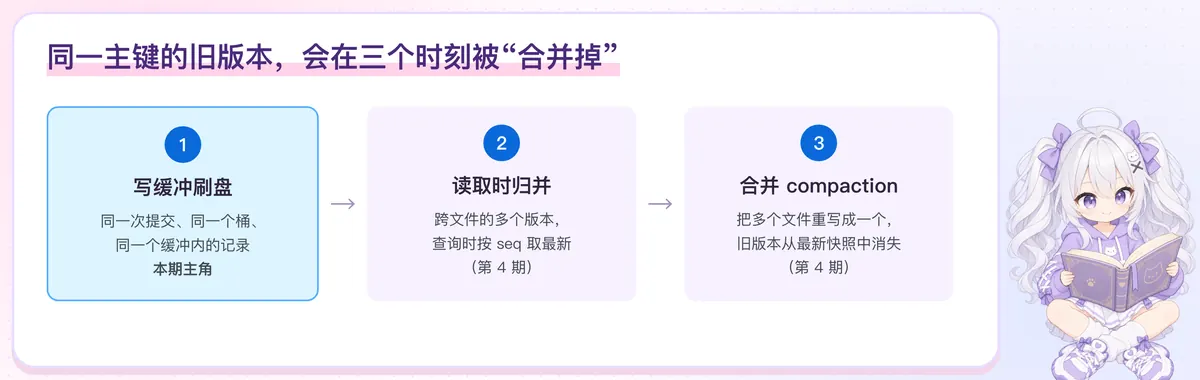
| 时刻 | 合并的范围 | 本系列 |
|---|---|---|
| 写缓冲刷盘 | 同一次提交、同一个桶、同一个缓冲内的记录 | 本期 |
| 读取时归并 | 查询涉及的所有文件,每次查询都做 | 第 4 期 |
| compaction | 把多个文件重写成一个,旧版本从最新快照中消失 | 第 4 期 |
生产启示
- checkpoint 间隔影响写入时的合并效果:流作业每次 checkpoint 都会刷盘提交。间隔越长,同一主键在一个缓冲里被合并的机会越多,落盘的记录越少;代价是数据可见延迟变长。
- 想要每条原始变更,用
changelog-producer = input:数据文件照常合并,原始记录写进 changelog 文件给流读下游用。 - 不要关闭写缓冲溢写,除非你确认内存足够:关闭后缓冲一满就提前刷盘,小文件变多,合并压力变大。
下期预告:Paimon 时间旅行——查一小时前的数据,到底读的是哪些文件?
自测题:流作业里,同一个订单在两次 checkpoint 之间更新了 3 次,又在下一个 checkpoint 周期里更新了 2 次。如果中间没有发生 compaction,磁盘上这个订单有几条记录?(答案:2 条。每个 checkpoint 刷盘一次,各自合并成 1 条;跨 checkpoint 的两条要等读取时归并或 compaction。前提是缓冲没有提前刷盘。)