
S1 第 6 期:Paimon 时间旅行——查 1 小时前的数据,存了几份?
Apache Paimon 源码学习
作者 X老师(DaemonforY),Paimon 2.0 / master 源码,按 CC BY-NC-SA 4.0 发布。配套实验和代码在 GitHub。
TL;DR:Paimon 每次提交生成一个快照,快照只是一个几百字节的 JSON,经 manifest list → manifest 最终指向一组数据文件。新快照复用旧快照的数据文件,只加入本次新写的,所以保存多个历史版本不需要复制数据。按时间旅行时,Paimon 找“提交时间 ≤ 指定时刻”的最新快照;能回到多久以前,取决于那个快照有没有被过期——默认保留最近 10 个,超过 1 小时的旧快照会被清理。
实验准备
一张主键表,三次提交,每次间隔 3 秒:
CREATE TABLE tt_time (
  order_id BIGINT,
  status   STRING,
  PRIMARY KEY (order_id) NOT ENFORCED
) WITH ('bucket' = '1');

INSERT INTO tt_time VALUES (1, 'CREATED'), (2, 'CREATED'), (3, 'CREATED');  -- 快照 1
INSERT INTO tt_time VALUES (1, 'PAID');                                     -- 快照 2
INSERT INTO tt_time VALUES (4, 'CREATED');                                  -- 快照 3
完整 SQL 在仓库
labs/sql/lab02/time-travel-by-time.sql,一条命令复现:cd labs && ./run.sh sql/lab02/time-travel-by-time.sql
$snapshots 的输出:
+----------------------+--------------------------------+----------------------+----------------------+-------------------------+
|          snapshot_id |                    commit_kind |   total_record_count |   delta_record_count |             commit_time |
+----------------------+--------------------------------+----------------------+----------------------+-------------------------+
|                    1 |                         APPEND |                    3 |                    3 | 2026-10-04 20:56:18.800 |
|                    2 |                         APPEND |                    4 |                    1 | 2026-10-04 20:56:22.551 |
|                    3 |                         APPEND |                    5 |                    1 | 2026-10-04 20:56:26.218 |
+----------------------+--------------------------------+----------------------+----------------------+-------------------------+
每个版本都能查
按快照号读历史版本:
SELECT * FROM tt_time /*+ OPTIONS('scan.snapshot-id' = '1') */;   -- 订单 1 = CREATED
SELECT * FROM tt_time /*+ OPTIONS('scan.snapshot-id' = '2') */;   -- 订单 1 = PAID
快照 1 里订单 1 还是 CREATED,快照 2 里已经是 PAID。三个版本都完好地保存着。
问题来了:三个版本,Paimon 存了三份数据吗?
磁盘上只有 3 个数据文件
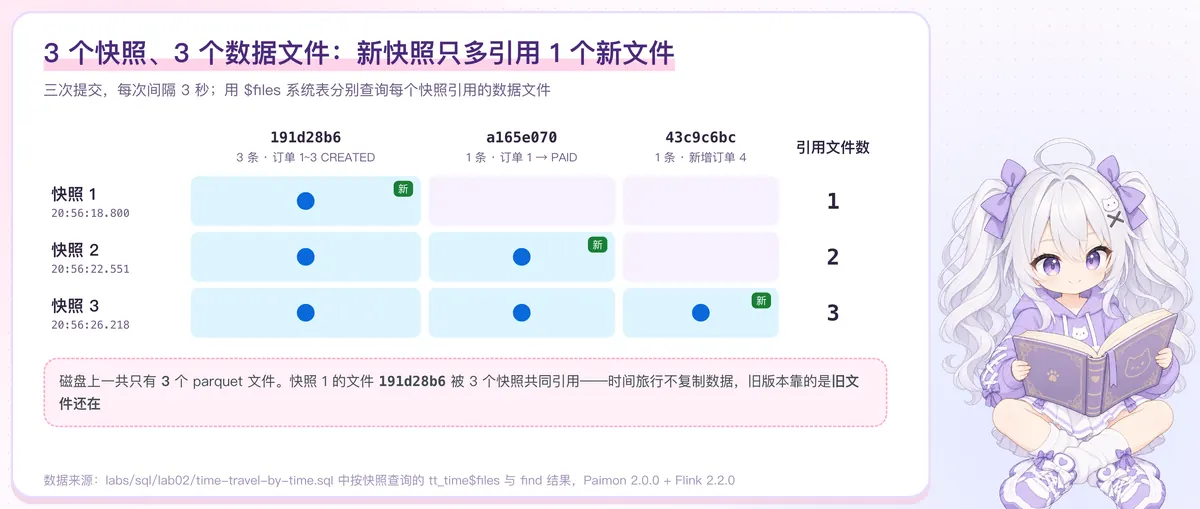
$files 系统表也支持时间旅行,分别查每个快照引用的数据文件(按查询结果整理,文件名取前 8 位):
快照 1:191d28b6(3 条)
快照 2:a165e070(1 条)、191d28b6(3 条)
快照 3:a165e070(1 条)、191d28b6(3 条)、43c9c6bc(1 条)
再看磁盘(文件名后半段 UUID 省略):
bucket-0/data-191d28b6-….parquet
bucket-0/data-43c9c6bc-….parquet
bucket-0/data-a165e070-….parquet
一共只有 3 个数据文件。 快照 1 写的 191d28b6 被三个快照共同引用;每个新快照只多引用一个本次新写的文件。
这正是第 4、5 期讲过的“文件不可变”的回报:旧文件写下之后不会被修改,新快照可以放心地直接复用它。所谓“历史版本”,就是旧文件还在、旧清单还在。
快照里到底存了什么
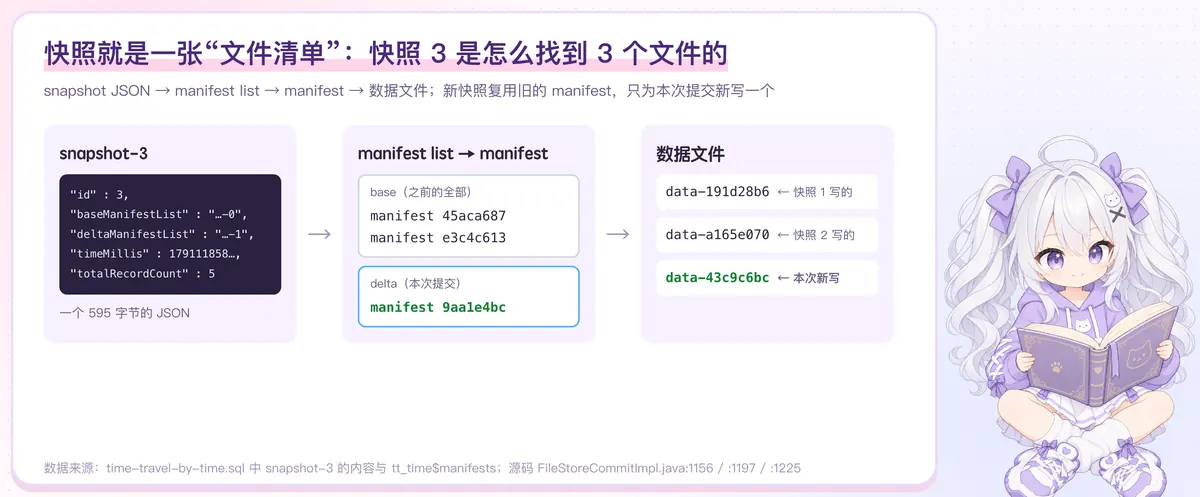
打开 snapshot/snapshot-3,它只是一个 595 字节的 JSON(节选):
{
  "id" : 3,
  "baseManifestList" : "manifest-list-1f8a63e6-…-0",
  "deltaManifestList" : "manifest-list-1f8a63e6-…-1",
  "commitKind" : "APPEND",
  "timeMillis" : 1791118586218,
  "totalRecordCount" : 5,
  "deltaRecordCount" : 1
}
数据本身不在快照里。快照记的是两个 manifest list 的文件名:
- deltaManifestList:本次提交的变化——这里只有一个新 manifest,里面登记了新文件
43c9c6bc; - baseManifestList:之前所有的文件——提交时
FileStoreCommitImpl先读出上一个快照的全部 manifest(第 1156 行),写成新的 base manifest list(第 1197 行),再为本次的新文件写 delta(第 1225 行)。
用 $manifests 系统表看每个快照的 manifest(按查询结果整理,文件名取前 8 位):
快照 1:45aca687
快照 2:45aca687、e3c4c613
快照 3:45aca687、e3c4c613、9aa1e4bc不只是数据文件,manifest 文件也被复用了。旧 manifest 一直累加下去也不行,所以 manifest 数量多了以后(manifest.merge-min-count 默认 30),提交时会把小 manifest 合并成新的——但合并的只是清单,数据文件照样共享。
所以读快照 N 的过程就是:读 snapshot-N 这个 JSON → 读它的 manifest list → 读 manifest → 拿到数据文件列表 → 读文件。读哪个版本,只是换一张清单。
按时间旅行:找“提交时间 ≤ T”的最新快照
快照号不好记,实际更常用的是“查某个时刻的数据”。实验里我们从快照文件读出真实的提交时间,在快照 2(20:56:22.551)和快照 3(20:56:26.218)之间取一个时刻 20:56:24.384:
-- 方式 1:毫秒时间戳
SELECT * FROM tt_time /*+ OPTIONS('scan.timestamp-millis' = '1791118584384') */;

-- 方式 2:标准 SQL
SELECT * FROM tt_time FOR SYSTEM_TIME AS OF TIMESTAMP '2026-10-04 20:56:24.384';
两种写法的结果都是快照 2(订单 1 = PAID,没有订单 4)。
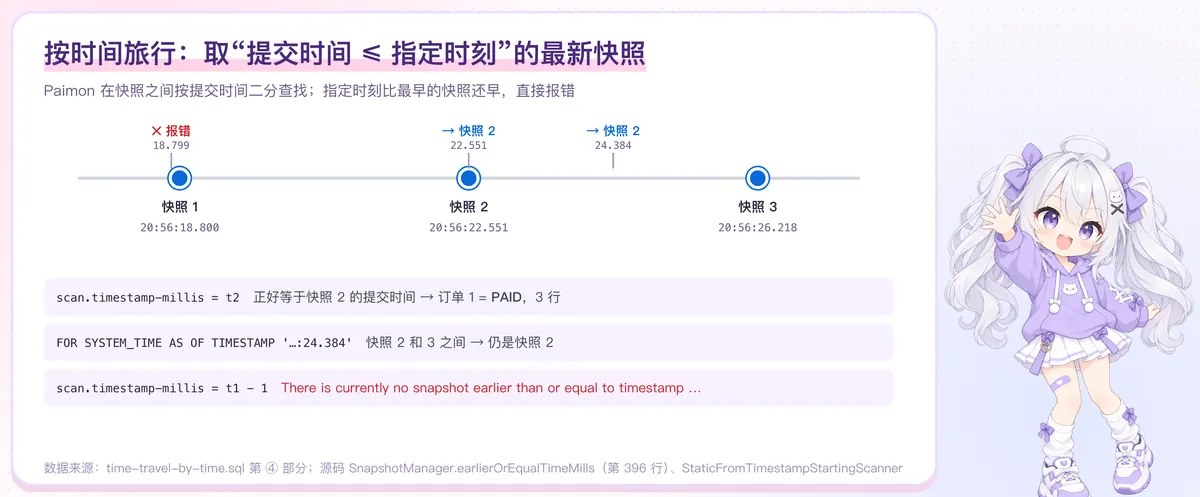
规则在 SnapshotManager.earlierOrEqualTimeMills(第 396 行):在最早和最新的快照之间按提交时间二分查找,返回“提交时间 ≤ 指定时刻”的最后一个快照。Flink 的 FOR SYSTEM_TIME AS OF 最终也是转成 scan.timestamp-millis(FlinkCatalog 第 384 行)。
几个边界情况:
| 指定时刻 | 结果 |
|---|---|
| 正好等于快照 2 的提交时间 | 快照 2 |
| 快照 2 和快照 3 之间 | 快照 2 |
| 比快照 1 还早 1 毫秒 | 报错:There is currently no snapshot earlier than or equal to timestamp [1791118578799], the earliest snapshot's timestamp is [1791118578800] |
注意最后一种:不会悄悄返回空表,而是直接报错,并告诉你现存最早的快照是什么时候。
FOR SYSTEM_TIME AS OF里的时间字符串按 Flink 会话时区(table.local-time-zone,默认取系统时区)解释。跨时区排查数据时,用毫秒时间戳更不容易出错。
能回到多久以前?
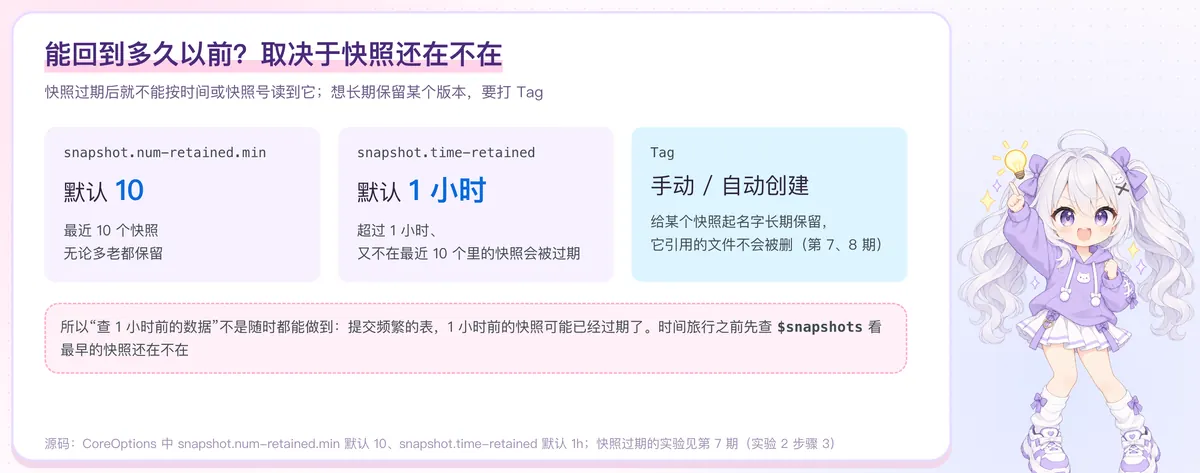
既然时间旅行靠的是“旧快照还在”,那能回到多久以前,就取决于快照保留了多久。默认:
snapshot.num-retained.min = 10:最近 10 个快照无论多老都保留;snapshot.time-retained = 1 h:超过 1 小时、又不在最近 10 个里的快照,会在快照过期时被清理。
所以标题里的“查 1 小时前的数据”并不总能做到:一个每分钟 checkpoint 一次的流作业,1 小时前的快照很可能已经被清理掉了,这时按时间查会命中上面那个“no snapshot earlier than…”的错误。
想长期保留某个版本,比如“每天零点的数据”或“上线前的版本”,就要给快照打 Tag:Tag 引用的文件不会随快照过期被删除。过期到底删了什么、Tag 为什么能保住文件,是下一期的内容。
生产启示
- 时间旅行几乎不占额外空间:多个版本共享数据文件,只多了几百字节的快照 JSON 和少量 manifest。真正占空间的是“被更新、被删除后仍被旧快照引用的旧文件”。
- 先查
$snapshots再时间旅行:看最早的快照还在不在,避免拿到报错才发现历史已经被清理。 - 需要长期回溯就用 Tag,不要把
snapshot.time-retained调得很大:保留的快照越多,旧文件越删不掉,存储越大。
下期预告:快照删了,文件为什么还在?——快照过期的三道保险和文件的删除规则。
自测题:如果在快照 3 之后执行一次全量 compaction,生成快照 4。此时再查快照 1,读到的还是 191d28b6 这个文件吗?(答案:是。compaction 只会写新文件、生成新快照,快照 1 的清单不变,旧文件也还在;只有快照 1 过期后,不再被任何快照或 Tag 引用的旧文件才会被删除。)