
S2 第 10 讲:Flink 流读与 consumer-id
Apache Paimon 源码学习
作者 X老师(DaemonforY),Paimon 2.0 / master 源码,按 CC BY-NC-SA 4.0 发布。配套实验和代码在 GitHub。
TL;DR:第一季第八讲(上)拆过 FLIP-27:JobManager 上的 Enumerator 发现并分配 split,TaskManager 上的 Reader 读 split。Paimon 的默认流读就是一个标准的 FLIP-27 Source:Enumerator 的位点只有一个数字
nextSnapshotId,第一次读最新快照的全量,之后一个快照一个快照往后追;changelog-producer = none 的表只读 APPEND 快照,COMPACT 快照直接跳过;同一个 bucket 的 split 永远交给同一个 Reader,所以同一个 key 的变更有序。Flink 的 checkpoint 只记住 Flink 自己读到哪;表并不知道,照样过期快照。consumer-id把“读到哪了”写进表里:过期时绕开它,重启时没有 Flink 状态也能接着读。配了 consumer-id,Source 会换成单并发的 MonitorSource。
实验
labs 新增的 SourceLab:后台流读一张主键表 src_t(2 个 bucket、changelog-producer = none、source 并行度 2、continuous.discovery-interval = 1 s),启动时表是空的;前台每隔 5 秒依次写入、更新、手动合并、删除,打印每条变更被读到的时间。另一个场景对比同一条流读 SQL 配不配 consumer-id 生成的算子。consumer-id 的过期保护与续读,沿用实验 3(lab03-b)在 Flink 2.2.0 上的结果。
一、三个角色,在 Paimon 里是谁
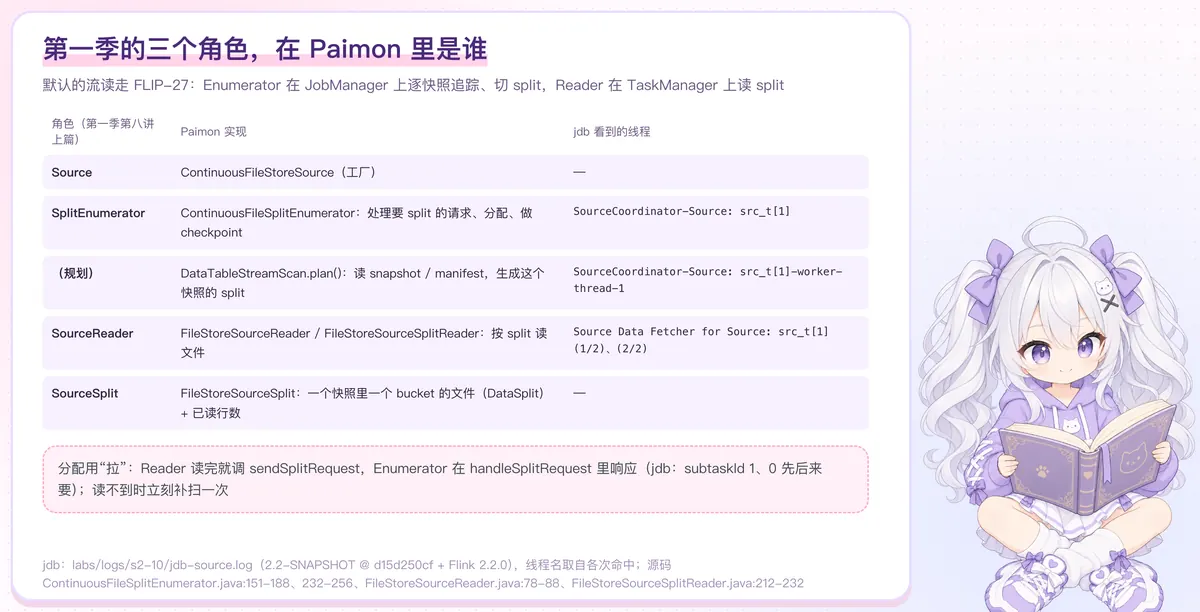
| 第一季的角色 | Paimon 的实现 | jdb 看到的线程 |
|---|---|---|
| Source | ContinuousFileStoreSource(工厂) | — |
| SplitEnumerator | ContinuousFileSplitEnumerator:处理要 split 的请求、分配、做 checkpoint | SourceCoordinator-Source: src_t[1] |
| (规划) | DataTableStreamScan.plan():读 snapshot / manifest,生成这个快照的 split | SourceCoordinator-Source: src_t[1]-worker-thread-1 |
| SourceReader | FileStoreSourceReader / FileStoreSourceSplitReader | Source Data Fetcher for Source: src_t[1] (1/2)、(2/2) |
| SourceSplit | FileStoreSourceSplit:一个快照里一个 bucket 的文件 + 已读行数 | — |
第一季讲过,Enumerator 的所有方法都在 SourceCoordinator 的那一个线程里执行。jdb 印证了这一点,同时多看到一个细节:读 manifest 生成 split 的 scan.plan() 不在这个线程里,而是通过 context.callAsync(this::scanNextSnapshot, this::processDiscoveredSplits, …)(ContinuousFileSplitEnumerator.java 第 151~155 行)放到 worker 线程执行,结果再回到 SourceCoordinator 线程处理。读文件系统可能很慢,不能堵住处理事件的那个线程。scanNextSnapshot 因此加了 synchronized(第 232~235 行的注释)。
分配用的是第一季说的“拉”:Reader 启动或读完一个 split 就调 sendSplitRequest()(FileStoreSourceReader.java 第 78、88 行),Enumerator 在 handleSplitRequest(第 177~188 行)里记下这个 Reader、尝试分配;如果这次没分到,就立刻补扫一次,不等下一个 discovery-interval。jdb 里 subtask 1、0 先后来要 split(第 1~2 次命中),这时表里还没有快照,什么也分不到。
二、先读全量,再逐个快照追
SourceLab 的输出(节选自 source-2.0.0-flink2.2.log,+X.Xs 是从启动流读算起的秒数):
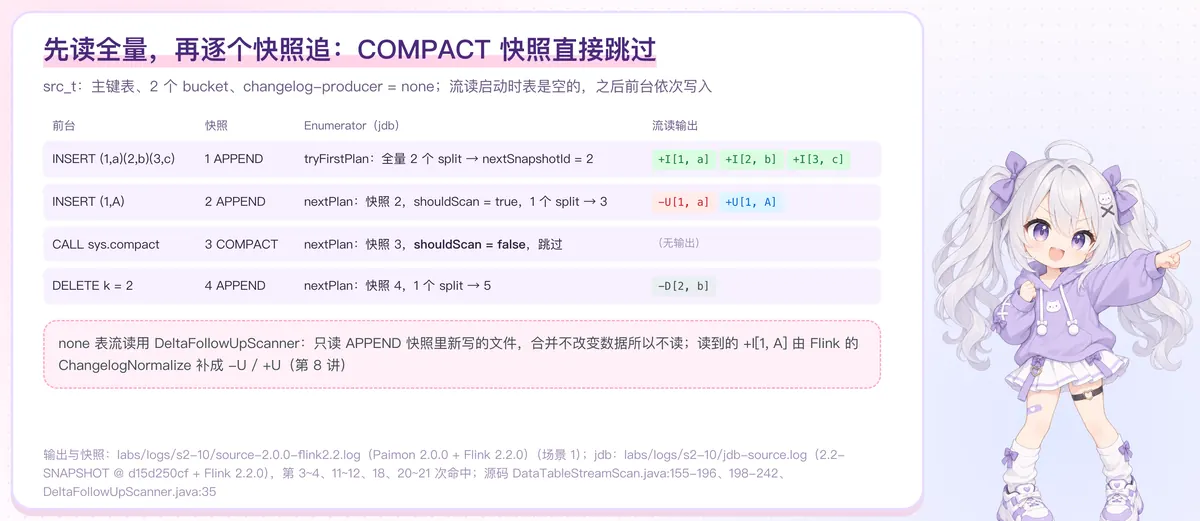
[SourceLab +  7.2s] 写入:INSERT INTO src_t VALUES (1, 'a'), (2, 'b'), (3, 'c')
[SourceLab +  9.3s] 写入完成
[SourceLab + 12.2s] 读到 +I[3, c]
[SourceLab + 12.2s] 读到 +I[1, a]
[SourceLab + 12.2s] 读到 +I[2, b]
[SourceLab + 14.3s] 写入:INSERT INTO src_t VALUES (1, 'A')
[SourceLab + 15.0s] 写入完成
[SourceLab + 16.3s] 读到 -U[1, a]
[SourceLab + 16.3s] 读到 +U[1, A]
[SourceLab + 20.0s] 写入:CALL sys.compact(`table` => 'default.src_t')
[SourceLab + 20.7s] 写入完成
[SourceLab + 25.7s] 写入:DELETE FROM src_t WHERE k = 2
[SourceLab + 26.5s] 写入完成
[SourceLab + 28.2s] 读到 -D[2, b]
四次写入对应 4 个快照:1 APPEND、2 APPEND、3 COMPACT、4 APPEND。合并那一步,流读什么都没输出。
DataTableStreamScan.plan() 分两段:位点 nextSnapshotId 为空时走 tryFirstPlan(第 155~196 行),否则走 nextPlan(第 198~242 行)。jdb 在 Enumerator 里看到的(jdb-source.log,整理成每行一次命中):
#3   tryFirstPlan        全量 split 数 = 2      nextSnapshotId(此前)= null
#4   processDiscovered   split 数 = 2           nextSnapshotId = 2
#11  nextPlan            快照 2  APPEND   shouldScanSnapshot = true
#12  processDiscovered   split 数 = 1           nextSnapshotId = 3
#18  nextPlan            快照 3  COMPACT  shouldScanSnapshot = false
#20  nextPlan            快照 4  APPEND   shouldScanSnapshot = true
#21 processDiscovered split 数 = 1 nextSnapshotId = 5- 第一次:表里出现快照 1,
tryFirstPlan按默认的scan.mode(latest-full)读快照 1 的全量,两个 bucket 两个 split,然后把位点设成 2(第 176~177 行)。全量读给的是“结果”,不是“过程”:如果流读启动前已经写过好几轮,读到的就是合并后的最终值。 - 之后:
nextPlan拿nextSnapshotId去取快照,取到就问followUpScanner.shouldScanSnapshot(第 229 行)。changelog-producer = none 的表用DeltaFollowUpScanner,只读 APPEND 快照(第 35 行)——合并不改变数据,只是重新组织文件,读了反而重复。所以快照 3 被跳过,位点从 3 直接走到 5。 - lookup / input / full-compaction 的表换成
ChangelogFollowUpScanner,只读带 changelog 的快照(第 8 讲:changelog 挂在 COMPACT 快照上)。
这就是流读的全部位点:Enumerator 做 checkpoint 时存的是 PendingSplitsCheckpoint(还没分出去的 split, nextSnapshotId)(ContinuousFileSplitEnumerator.java 第 207~210 行);Reader 存它手上的 split 和已经发出的行数。快照文件不可变、编号单调递增,这三样就够精确恢复。
读到的 -U[1, a] +U[1, A]:none 表的快照 2 里只有一条新写入的 (1, A),-U[1, a] 是 Flink 规划器加的 ChangelogNormalize 用状态补出来的(第 8 讲)。
从写入完成到读到,这次大约 1.3~3 秒;其中包含 discovery-interval(1 秒)和 Flink 收集结果的时间,没有单独拆分测量。
三、同一个 bucket,永远交给同一个 Reader
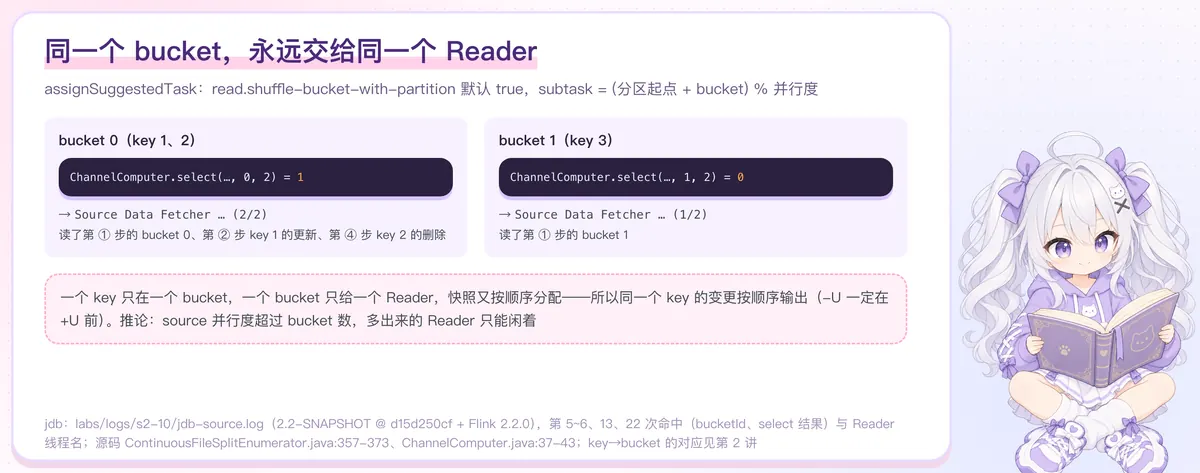
Enumerator 生成 split 后,用 assignSuggestedTask(第 357~373 行)给每个 split 选 subtask。read.shuffle-bucket-with-partition 默认 true(FlinkConnectorOptions.java 第 213~218 行),走第 370 行:
return ChannelComputer.select(split.partition(), bucketId, parallelism);
// ChannelComputer.java:37-38:(startChannel(partition, numChannels) + bucket) % numChannels
jdb 在第 370 行打印了 bucketId 和计算结果,再对照读这个 split 的 Reader 线程:
| select 结果 | 读它的 Reader | 读了哪些 split | |
|---|---|---|---|
| bucket 0(key 1、2) | 1 | … src_t[1] (2/2) | ① 的 bucket 0、② key 1 的更新、④ key 2 的删除 |
| bucket 1(key 3) | 0 | … src_t[1] (1/2) | ① 的 bucket 1 |
(第 5~6、13、22 次命中;key 1、2 在 bucket 0、key 3 在 bucket 1,见第 2 讲 abs(hashCode % 2) 的实测。)
一个 key 只在一个 bucket,一个 bucket 只交给一个 Reader,快照又按顺序分配——同一个 key 的变更因此按顺序输出,-U 一定在 +U 前面,下游的 ChangelogNormalize、聚合才算得对。推论:source 并行度超过 bucket 数,多出来的 Reader 永远分不到 split(教程 09 章:sourceParallelismUpperBound = bucketNum)。
四、consumer-id:把“读到哪了”写进表里
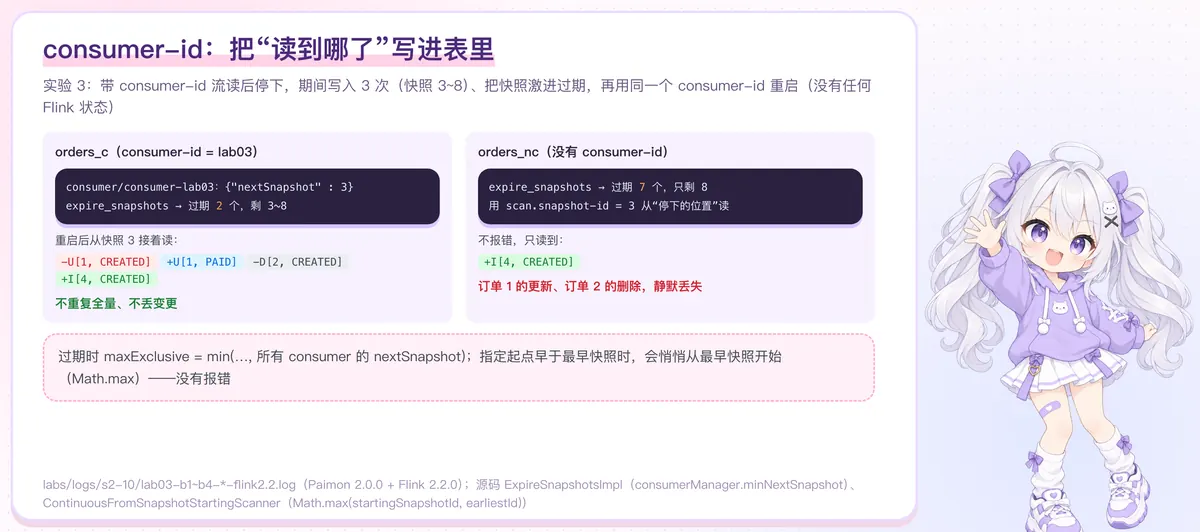
Flink 的 checkpoint 记住了 nextSnapshotId,可表不知道。表照常过期快照,流作业停久了,它要读的快照可能已经没了。实验 3 在 Flink 2.2.0 上的过程(lab03-b*-flink2.2.log,两张 lookup 表 orders_c / orders_nc):
带
consumer-id = 'lab03'流读orders_c,全量读到订单 1、2、3 后停止;表里多了一个 consumer 文件:| consumer_id | next_snapshot_id | | lab03 | 3 | "nextSnapshot" : 3流读停着,两张表各写入 3 次(订单 1 → PAID、删订单 2、加订单 4,lookup 表每次产生 APPEND + COMPACT 两个快照,于是快照 3~8),然后激进过期(
retain_min => 1, snapshot.time-retained=1ms):CALL sys.expire_snapshots(`table` => 'default.orders_c', …) → range is [1, 3) → 2 CALL sys.expire_snapshots(`table` => 'default.orders_nc', …) → range is [1, 8) → 7orders_c只过期了 2 个,快照 3~8 都还在——被 consumer 挡住了;orders_nc过期了 7 个,只剩快照 8。挡住它的是ExpireSnapshotsImpl.java第 154 行:maxExclusive = min(maxExclusive, consumerManager.minNextSnapshot())。用同一个 consumer-id 重新启动流读,没有任何 Flink 状态:
-U[1, CREATED]
+U[1, PAID]
-D[2, CREATED]
+I[4, CREATED]
直接从快照 3 接着读(
AbstractDataTableScan.java第 473~478 行:流读且有 consumer 记录,就从它的 nextSnapshot 开始),不重复全量,也不丢变更。对照:
orders_nc用scan.snapshot-id = 3从“停下的位置”读——不报错,只读到+I[4, CREATED]。订单 1 的更新、订单 2 的删除,静默丢失。原因在ContinuousFromSnapshotStartingScanner.java第 52~53 行:指定的起点早于最早快照时,Math.max(startingSnapshotId, earliestId),悄悄从最早快照开始。这就是踩坑实验室 #14。
注意区分:从 Flink checkpoint 恢复时,如果 nextSnapshotId 对应的快照已经过期,会抛 OutOfRangeException,明确失败(教程 09 章 NextSnapshotFetcher.rangeCheck);手动指定起点才会静默跳过。本讲没有单独复现前者。
五、配了 consumer-id,Source 换了一种实现
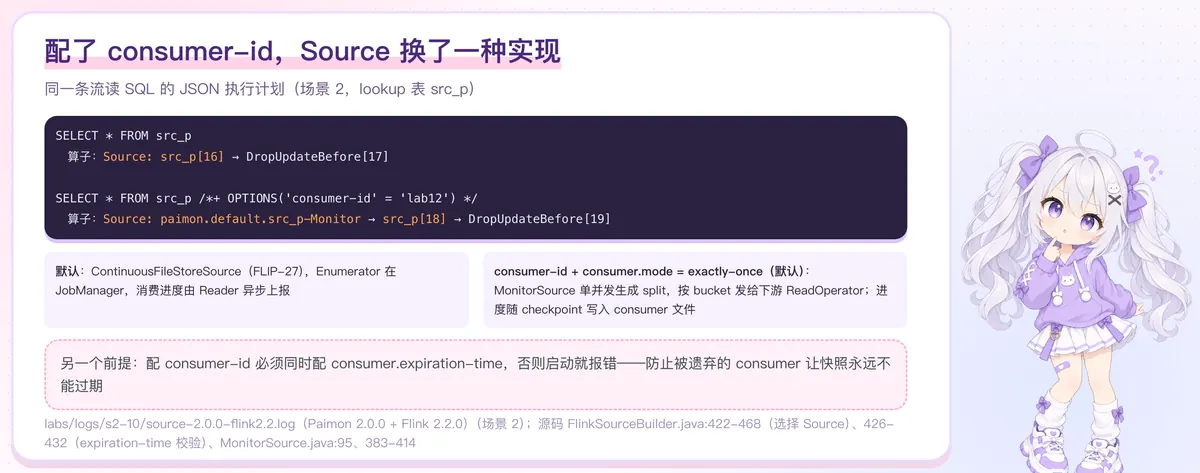
SourceLab 的第二个场景,同一条流读 SQL 的 JSON 执行计划(节选):
SELECT * FROM src_p
  算子:Source: src_p[16]  →  DropUpdateBefore[17]
SELECT * FROM src_p /*+ OPTIONS('consumer-id' = 'lab12') */
算子:Source: paimon.default.src_p-Monitor → src_p[18] → DropUpdateBefore[19]FlinkSourceBuilder.build()(第 422~468 行)里:
- 配了
consumer-id且consumer.mode是exactly-once(默认),走buildDedicatedSplitGenSource→MonitorSource:一个单并发的 Source 负责扫描快照、生成 split,按 bucket 发给下游的ReadOperator读(MonitorSource.java第 383~414 行)。consumer 进度随 checkpoint 写入 consumer 文件,和 checkpoint 严格对齐。 - 否则走
ContinuousFileStoreSource,也就是前面拆的 FLIP-27 结构;它也能写 consumer,但进度由 Reader 异步上报(ReaderConsumeProgressEvent),教程 09 章称之为 at-least-once。
还有一个前提(踩坑实验室 #15):配了 consumer-id 却没配 consumer.expiration-time,启动就报错(第 426~432 行):“You need to configure 'consumer.expiration-time' (ALTER TABLE) and restart your write job…”。原因写在报错里:防止被遗弃的 consumer 让快照永远不能过期,把文件系统撑满。本讲的 src_p 在建表时就配了 consumer.expiration-time = '1 d'。
小结
- 默认流读是标准 FLIP-27:Enumerator 在 JobManager 上逐快照规划(规划本身在 worker 线程),Reader 拉 split 读。
- 位点就是
nextSnapshotId:第一次读全量,之后一个快照一个快照追;none 表只读 APPEND,跳过 COMPACT。 - 同一个 bucket 永远给同一个 Reader,保证同一个 key 的变更有序;并行度别超过 bucket 数。
- consumer-id 把位点写进表:挡住过期、无状态续读;配了它会换成 MonitorSource,并且必须配
consumer.expiration-time。 - 没有 consumer-id 时,用
scan.snapshot-id指定一个已过期的起点,不报错、静默丢变更。
下一讲:Spark 的 MERGE INTO 在 Paimon 里有三条执行路径——同一条 SQL,为什么有时重写整个文件、有时只写几行?
自测题:src_t 改成 changelog-producer = lookup,同样的四步写入,流读会读哪些快照?COMPACT 那一步会不会有输出?(答案:换成 ChangelogFollowUpScanner,只读带 changelog 的快照;lookup 表每次写入都产生 APPEND + 带 changelog 的 COMPACT 快照(第 8 讲),流读读的正是这些 COMPACT 快照。手动 CALL sys.compact 的那次是否产生 changelog,取决于有没有 L0 文件参与(第 8 讲 rewriteLookupChangelog);这里每次写入后 L0 都已被推上去,按源码推导不产生 changelog、不输出。未单独运行。)