
S2 第 4 讲:合并怎么执行——能不重写就不重写
Apache Paimon 源码学习
作者 X老师(DaemonforY),Paimon 2.0 / master 源码,按 CC BY-NC-SA 4.0 发布。配套实验和代码在 GitHub。
TL;DR:第 3 讲的
UniversalCompaction只决定“合并哪些 run、输出到哪层”,真正干活的是MergeTreeCompactTask。它先把输入文件按 key 范围切成互不相交的 section,再逐个处理:section 里有多个 run(key 重叠)→ 必须重写;只有一个 run 时逐个看文件——小于阈值的跟着重写,大文件直接升级(只把元数据里的 level 改大,数据文件一个字节都不动,文件名也不变)。阈值 =target-file-size × compaction.small-file-ratio(默认 0.7)。实验里两张表只差这个阈值:一张每次合并都把所有文件重写一遍,另一张 3 次合并耗时 0 ms、没有变化的文件始终保持原名。
实验设计
两张表写入完全相同的 5 次提交,只差小文件阈值(labs/sql/lab04/compact-task.sql):
| 提交 | 数据 | key 范围 |
|---|---|---|
| E | 10 行 | 300001~300010(孤立的小文件) |
| A | 12000 行 | 1~12000 |
| B | 12000 行 | 100001~112000(与谁都不重叠) |
| C | 12000 行 | 1~12000(更新 A,与 A 重叠) |
| D | 12000 行 | 200001~212000(与谁都不重叠) |
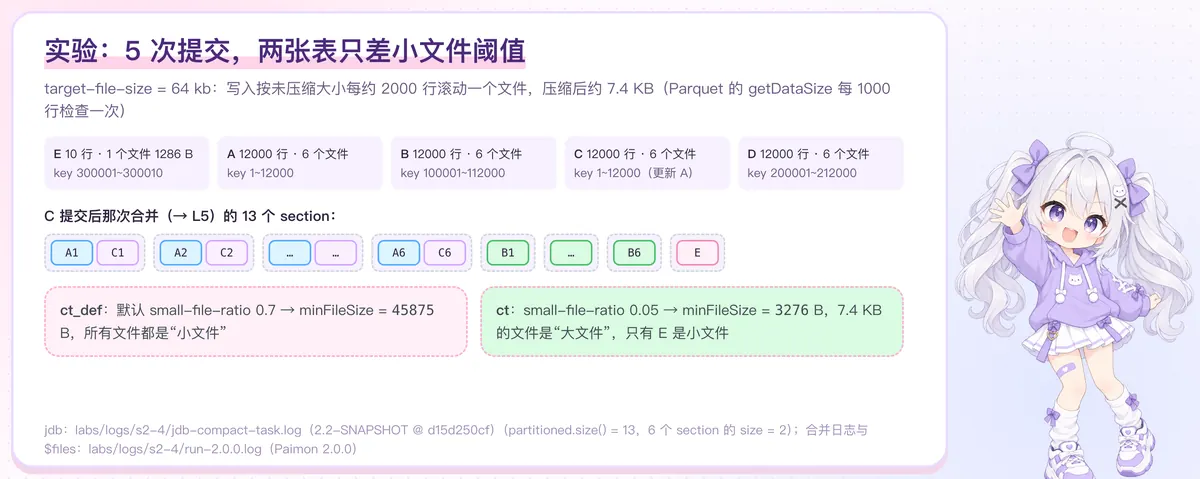
两张表都设 target-file-size = 64 kb:写入时每约 2000 行滚动一个文件,每次大提交写出 6 个约 7.4 KB 的文件。
为什么 64 KB 的目标,写出来只有 7.4 KB?滚动判断看的是 Parquet writer 的
getDataSize()(未压缩的数据量),每 1000 行检查一次(RollingFileWriter.CHECK_ROLLING_RECORD_CNT、ParquetBulkWriter.reachTargetSize),落盘后压缩到 7.4 KB 左右。
区别只有一个参数:
ct_def:默认compaction.small-file-ratio = 0.7→ 阈值 64 KiB × 0.7 = 45875 B,所有文件都是“小文件”;ct:compaction.small-file-ratio = 0.05→ 阈值 3276 B,7.4 KB 的文件是“大文件”,只有 E(1286 B)是小文件。
生产上默认
target-file-size是 128 MB(主键表),阈值约 89.6 MB。本实验把尺度缩小到 KB 级,只是为了方便观察,规则完全相同。
结果:同样的合并,代价完全不同
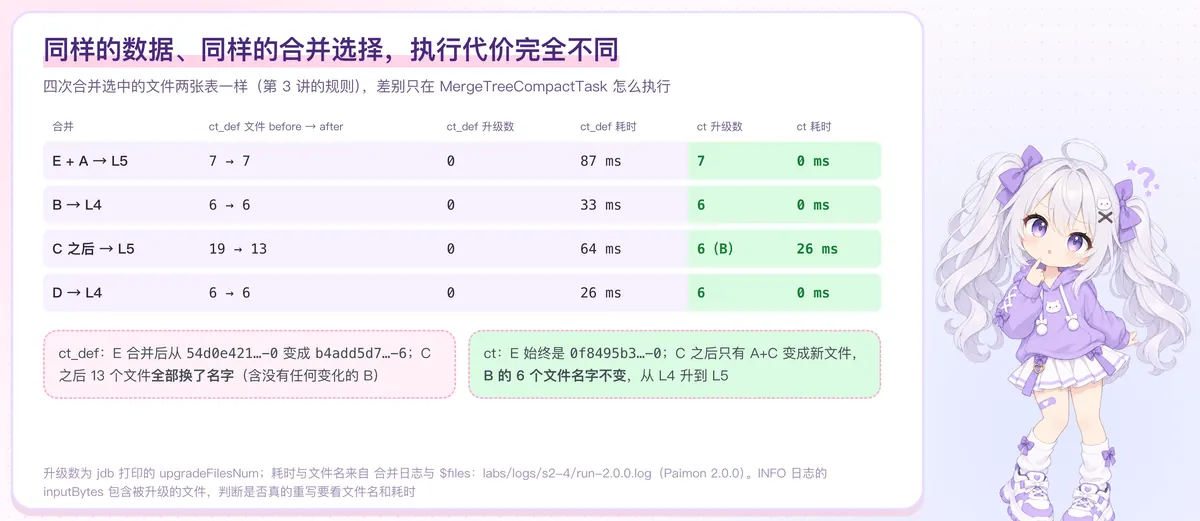
两张表的 4 次合并选中的文件一模一样(第 3 讲的规则只看 run 的大小和数量)。但执行结果:
| 合并 | ct_def 升级文件数 / 耗时 | ct 升级文件数 / 耗时 |
|---|---|---|
| E + A → L5 | 0 / 87 ms | 7 / 0 ms |
| B → L4 | 0 / 33 ms | 6 / 0 ms |
| C 之后 → L5 | 0 / 64 ms | 6(B)/ 26 ms |
| D → L4 | 0 / 26 ms | 6 / 0 ms |
升级文件数是 jdb 打印的
upgradeFilesNum,耗时来自 INFO 日志Paimon compact task finished: ... durationMs。ct_def 第一次合并的 87 ms 里有 JVM 预热成分,耗时只作参考;更可靠的证据是文件名,见下。
看文件名就知道有没有重写。 重写会生成新文件(新的 UUID 前缀),升级保留原文件名:
ct_def:E 最初是 54d0e421…-0,第一次合并后变成 b4add5d7…-6(和 A 的新文件同一个前缀)
        C 之后那次合并,13 个文件全部变成 0c18acb6…(包括 key 根本没变化的 B)

ct:    E 从头到尾都是 0f8495b3…-0
        C 之后那次合并,只有 A+C 变成新文件 fdb9ee25…;B 的 6 个文件仍是 58cbc25a…,从 L4 升到 L5
还有一个容易误读的地方:INFO 日志里 ct 这次合并写的是 inputFiles=18, inputBytes=135353, outputFiles=12, outputBytes=89656——outputBytes 把升级的文件也算进去了。判断数据有没有被重写,要看文件名和耗时,不能只看日志的字节数。(MergeTreeCompactTask 的 DEBUG 日志里有 upgrade file num,可以直接看。)
一、先切 section:IntervalPartition
MergeTreeCompactTask 构造时(第 73 行)先做一件事:
this.partitioned = new IntervalPartition(unit.files(), keyComparator).partition();IntervalPartition.partition() 把文件按 minKey 排序,维护当前 section 的右边界 bound;下一个文件的 minKey > bound 就开一个新 section。section 之间 key 范围互不相交,可以独立处理。section 内部再把文件打包成尽量少的 sorted run。
jdb 打印 C 之后那次合并:
outputLevel = 5     partitioned.size() = 13     dropDelete = true
section.size() = 2   ← 连续 6 次(A1+C1 … A6+C6,key 重叠)
13 个 section = 6 个 A+C 重叠 section + 6 个 B 文件 + 1 个 E 文件。
二、doCompact:逐个 section 决定升级还是重写
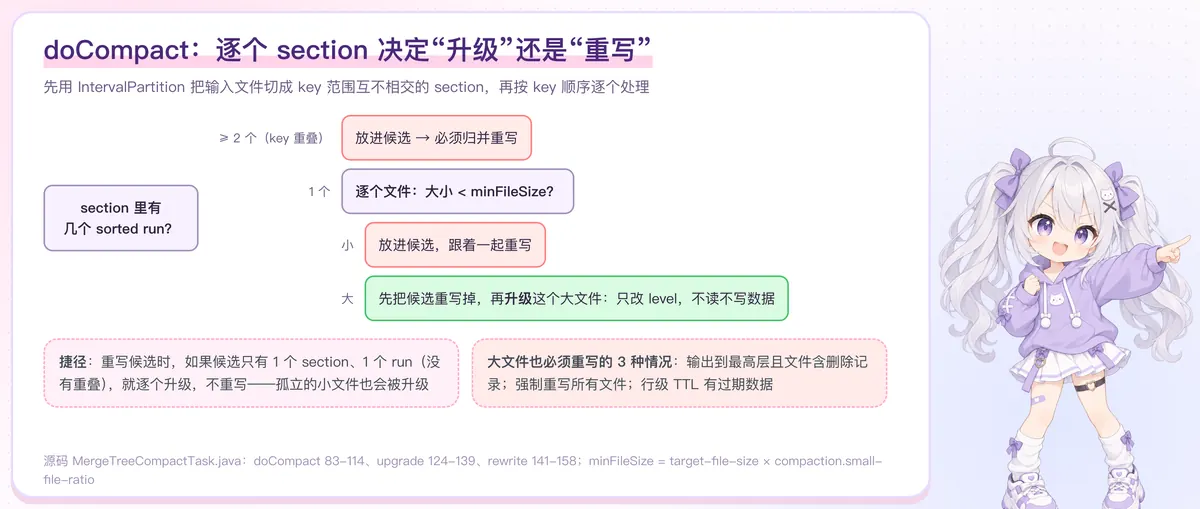
doCompact()(第 83~114 行)是本讲的核心:
for (List<SortedRun> section : partitioned) {
    if (section.size() > 1) {
        candidate.add(section);                                   // ① key 重叠 → 进候选,必须归并
    } else {
        for (DataFileMeta file : section.get(0).files()) {
            if (file.fileSize() < minFileSize) {
                candidate.add(singletonList(SortedRun.fromSingle(file)));   // ② 小文件 → 跟着重写
            } else {
                rewrite(candidate, result);                       // ③ 大文件:先把攒的候选重写掉
                upgrade(file, result);                            //    再升级这个大文件
            }
        }
    }
}
rewrite(candidate, result);                                       // ④ 收尾
minFileSize 来自 CoreOptions.compactionFileSize():target-file-size × compaction.small-file-ratio。jdb 打印出来,ct_def 是 45875,ct 是 3276。
为什么遇到大文件要先把候选重写掉? section 是按 key 顺序处理的。如果把大文件前后的小文件攒到一起合并,输出文件的 key 范围会跨过这个大文件,和它重叠,破坏“同一层文件 key 不重叠”。所以源码注释写着:不能跳过中间的文件。
三、jdb 实录:ct 表 C 之后那次合并
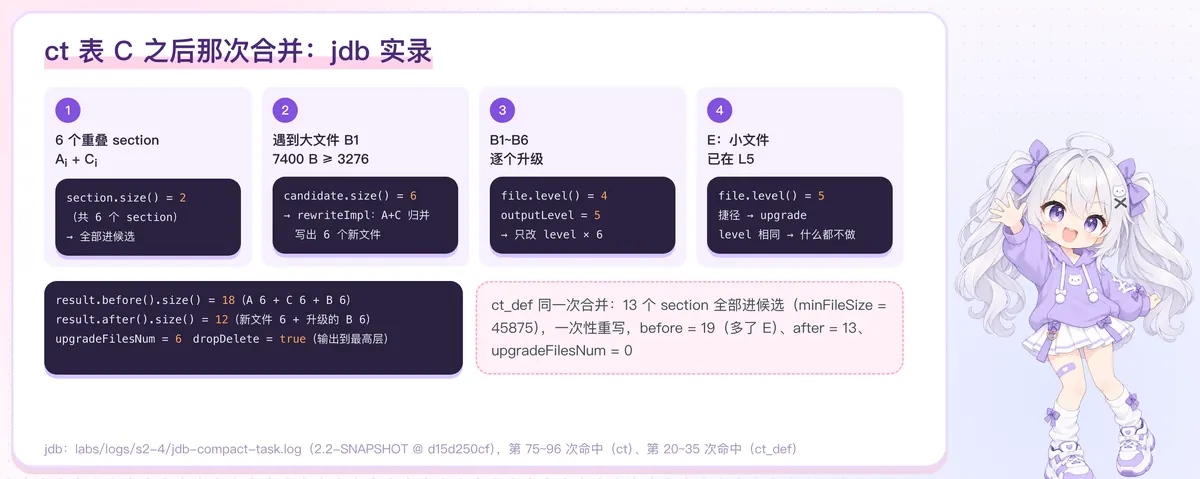
① 6 个重叠 section:section.size() = 2(6 次)→ 全部进候选
② 第一个大文件 B1(7400 B ≥ 3276):candidate.size() = 6
   → rewriteImpl:把 6 个 A+C section 归并,写出 6 个新文件
③ B1~B6:file.level() = 4,outputLevel = 5 → 逐个升级,只改 level
④ E(1286 B,小文件):进候选;收尾时候选只有 1 个 section、1 个 run → 走捷径 upgrade
   E 已经在 L5,level 相同 → 什么都不做
结果:before = 18(A 6 + C 6 + B 6),after = 12(新文件 6 + 升级后的 B 6),upgradeFilesNum = 6
对比 ct_def 同一次合并:所有文件都小于 45875,13 个 section 全部进候选,最后一次性重写——before 19(多了 E)、after 13、upgradeFilesNum 0。
捷径(rewrite() 第 145~156 行):要重写的候选只有 1 个 section、1 个 run 时,说明没有重叠,直接对其中每个文件调用 upgrade。所以“孤立的小文件”并不会被重写——ct 第一次合并时 E 就是这样从 L0 升到 L5 的。
大文件也必须重写的 3 种情况(upgrade() 第 124~132 行):
- 输出到最高层,且文件里可能有删除记录(
deleteRowCount大于 0 或未知)——要借重写把删除标记清掉; forceRewriteAllFiles(例如改了文件格式、压缩方式后强制重写);- 行级 TTL 判断文件里有过期数据。
四、真正的重写:归并读 + 滚动写
rewriteImpl 调用 MergeTreeCompactRewriter.rewriteCompaction()(第 78~105 行):
writer = writerFactory.createRollingMergeTreeFileWriter(outputLevel, FileSource.COMPACT);
reader = readerForMergeTree(sections, new ReducerMergeFunctionWrapper(mfFactory.create()));
if (dropDelete) reader = new DropDeleteReader(reader);
writer.write(new RecordReaderIterator<>(reader));- 读:section 之间顺序拼接;section 内多个 run 用败者树多路归并;同 key 交给合并函数(第 2 讲:只有多条时才真正调用);
- 写:滚动写,达到目标大小就切新文件——所以 A+C 的 12000 行又写成了 6 个文件;
- 异常时
writer.abort()删掉写了一半的文件。
C 之后这次合并 dropDelete = true(输出到最高层 L5),快照的 delta_record_count = -12000:A 的 12000 条旧版本被 C 覆盖、在重写中消失。
五、结果怎么生效
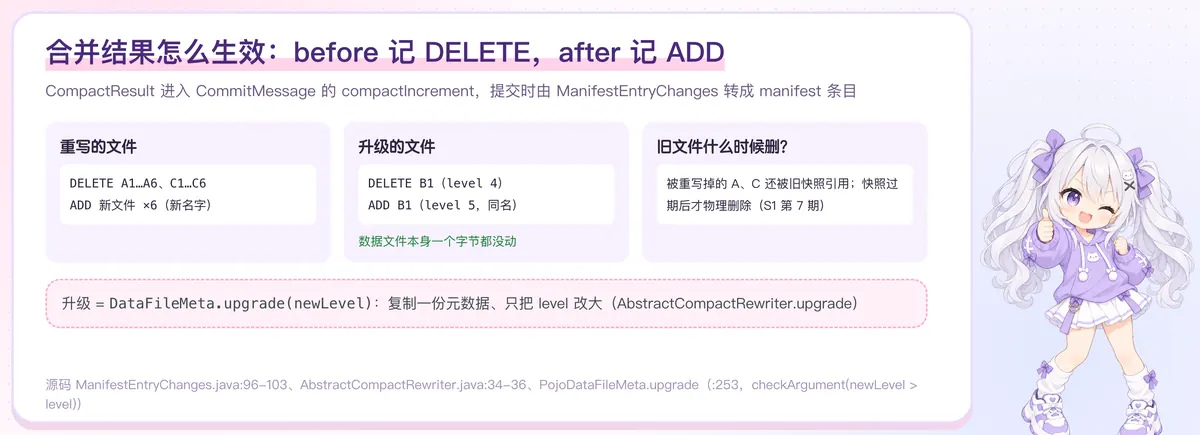
合并结果 CompactResult(before, after) 进入 CommitMessage 的 compactIncrement,提交时 ManifestEntryChanges(第 96~103 行)把 compactBefore 转成 DELETE 条目、compactAfter 转成 ADD 条目:
- 重写的文件:DELETE 旧文件、ADD 新文件;
- 升级的文件:DELETE 旧 level 的 B1、ADD 新 level 的 B1——同一个文件名,两条 manifest 记录。
AbstractCompactRewriter.upgrade只是new CompactResult(file, file.upgrade(outputLevel)),DataFileMeta.upgrade复制一份元数据、把 level 改大(还会检查newLevel > level)。
被重写掉的 A、C 旧文件不会马上删除——旧快照还引用它们,要等快照过期(S1 第 7 期)。
生产启示
- 默认阈值下,target-file-size 决定了“大文件”:默认 128 MB 目标、0.7 比例,大于约 89.6 MB 的文件才会被升级。写入量小、文件普遍很小的表,合并基本都是重写;这是合理的——小文件本来就该合并成大文件。
- 升级是 Paimon 降低写放大的关键:已经足够大、又没有重叠的文件,合并只改元数据。数据量大的表,大部分文件会走升级路径。
- 不要只看
outputBytes估算合并 IO:它包含升级的文件。想知道真实重写量,看 DEBUG 日志的upgrade file num,或比较合并前后的文件名。 - 实验里调小
compaction.small-file-ratio只是为了演示;生产上调这个参数会让更多小文件保留下来,需结合文件数和读性能评估。
下一讲:合并、写入都要提交快照。多个作业同时提交同一张表时,Paimon 怎么检测冲突、怎么重试?
自测题:ct 表第一次合并(E + A → L5)为什么 7 个文件全部被升级、一个都没重写?(答案:E 和 A 的 key 范围不重叠,A 的 6 个文件之间也不重叠,所以 7 个 section 都只有 1 个文件;A 的文件 ≥ 3276 B 直接升级;E 是小文件进候选,收尾时候选只有 1 个 section、1 个 run,走捷径也升级。jdb 第 46~60 次命中:upgradeFilesNum = 7。)