
踩坑实验室 #16:设了 TWO_PHASE,两阶段聚合却没生效
Apache Flink 源码学习
作者 X老师(DaemonforY),Flink 2.3.0 源码,按 CC BY-NC-SA 4.0 发布。
基于 Flink 2.3.0 本机实测(核对日期 2026-10-03)。对应课程:第五讲(上)《一条 SQL 怎么变成 Transformation》第五节。配套示例:
flink-notes/demos/src/main/java/study/sql/SqlDemo.java(explain、advice模式)
现象
两阶段聚合(Local + Global)可以缓解热点 key:先在上游做局部聚合,再 shuffle 到下游做全局聚合。想开启它,很多人会直接把 table.optimizer.agg-phase-strategy 设成 TWO_PHASE。结果执行计划和默认配置一模一样,没有出现局部聚合,日志里也没有任何警告。
复现
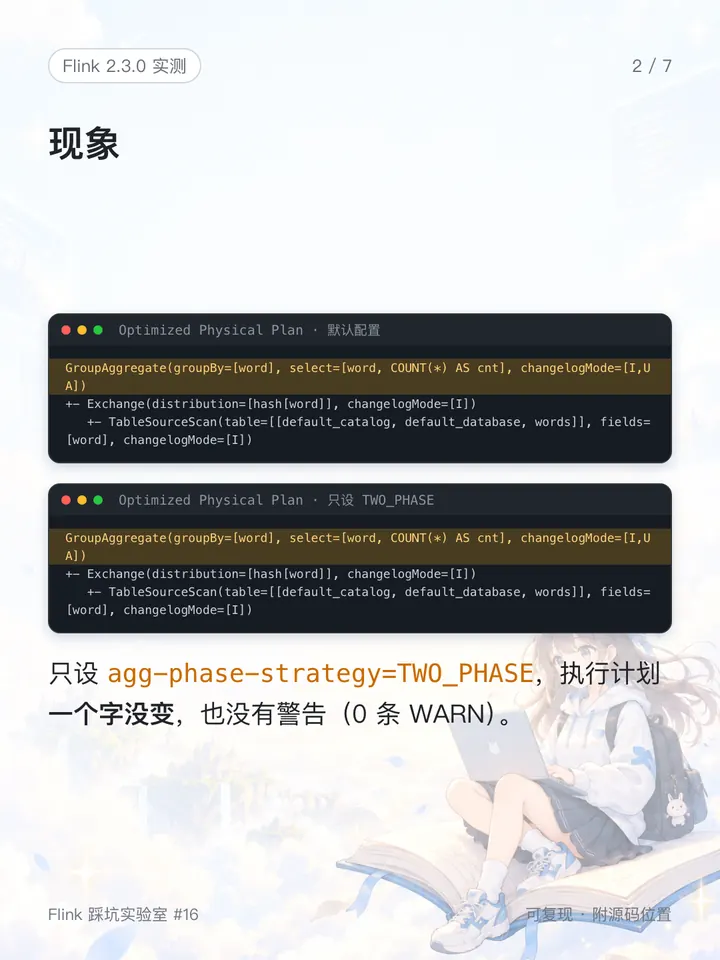
示例 SqlDemo:datagen 表 words(word STRING),查询 SELECT word, COUNT(*) AS cnt FROM words GROUP BY word,并行度 2。用 explain 模式看 Optimized Physical Plan:
# 默认配置
GroupAggregate(groupBy=[word], select=[word, COUNT(*) AS cnt], changelogMode=[I,UA])
+- Exchange(distribution=[hash[word]], changelogMode=[I])
   +- TableSourceScan(table=[[default_catalog, default_database, words]], fields=[word], changelogMode=[I])

# 只设 table.optimizer.agg-phase-strategy = TWO_PHASE
GroupAggregate(groupBy=[word], select=[word, COUNT(*) AS cnt], changelogMode=[I,UA])
+- Exchange(distribution=[hash[word]], changelogMode=[I])
   +- TableSourceScan(table=[[default_catalog, default_database, words]], fields=[word], changelogMode=[I])

# 开启 MiniBatch(allow-latency=1s、size=1000),agg-phase-strategy 保持默认 AUTO
GlobalGroupAggregate(groupBy=[word], select=[word, COUNT(count1$0) AS cnt], changelogMode=[I,UA])
+- Exchange(distribution=[hash[word]], changelogMode=[I])
   +- LocalGroupAggregate(groupBy=[word], select=[word, COUNT(*) AS count1$0], changelogMode=[I])
      +- MiniBatchAssigner(interval=[1000ms], mode=[ProcTime], changelogMode=[I])
         +- TableSourceScan(table=[[default_catalog, default_database, words]], fields=[word], changelogMode=[I])
前两份计划逐行相同。这个结果跑了两次(第五讲上篇写作时一次、本次一次),两次计划完全一样;整个运行过程 0 条 WARN(示例的 log4j 根级别是 WARN,stdout 和 stderr 合并采集)。
再把几种配置组合放在一起:
| 配置 | 结果 |
|---|---|
| 默认 | 单阶段 GroupAggregate |
只设 TWO_PHASE | 与默认逐行相同,没有警告 |
只设 table.exec.mini-batch.enabled=true | IllegalArgumentException: MiniBatch Latency must be greater than 0 ms. |
enabled + allow-latency=1s,不设 size | IllegalArgumentException: Key: 'table.exec.mini-batch.size' , default: -1 (fallback keys: []) must be > 0. |
三项都设,agg-phase-strategy 保持 AUTO | 出现 LocalGroupAggregate 和 GlobalGroupAggregate |
原因
流模式下,两阶段聚合由 TwoStageOptimizedAggregateRule 负责,它要求同时满足:MiniBatch 已开启、agg-phase-strategy 不是 ONE_PHASE、聚合函数都支持合并、输入还没按分组 key 分布(TwoStageOptimizedAggregateRule.java:86-116)。第一个条件不满足,规则根本不会生效,TWO_PHASE 设了等于没设。
这个前提在配置项自身的说明里没有提(OptimizerConfigOptions.java:46-55),写在调优文档里(docs/content/docs/dev/table/tuning.md:112),而且运行时没有任何提示。
MiniBatch 配一半则不会静默:allow-latency 默认是 0,size 默认是 -1(ExecutionConfigOptions.java:678、:691),校验逻辑在 StreamCommonSubGraphBasedOptimizer.scala:62-66 和 MinibatchUtil.java:71-76,所以会直接抛出上表里的两个异常。真正静默的,只有"设了 TWO_PHASE、没开 MiniBatch"这一种。
怎么解决
第一步,让 Flink 告诉你缺什么。用 PLAN_ADVICE 解释同一条 SQL(分析逻辑在 GroupAggregationAnalyzer.java:98-129),advice 模式的输出:
== Optimized Physical Plan With Advice ==
GroupAggregate(advice=[1], groupBy=[word], select=[word, COUNT(*) AS cnt])
+- Exchange(distribution=[hash[word]])
   +- TableSourceScan(table=[[default_catalog, default_database, words]], fields=[word])

advice[1]: [ADVICE] You might want to enable local-global two-phase optimization by configuring ('table.exec.mini-batch.enabled' to 'true', 'table.exec.mini-batch.allow-latency' to a positive long value, 'table.exec.mini-batch.size' to a positive long value).
本文实测用的是 Table API 的 explainSql(..., ExplainDetail.PLAN_ADVICE)。按官方文档的语法(docs/content/docs/sql/reference/utility/explain.md:520),SQL 里可以写 EXPLAIN PLAN_ADVICE <查询>,这种写法本文没有实测。
第二步,把 MiniBatch 的三项一起配上(数值仅为示例),agg-phase-strategy 保持默认的 AUTO 即可:
table.exec.mini-batch.enabled = true
table.exec.mini-batch.allow-latency = 1 s
table.exec.mini-batch.size = 1000
需要注意:
- MiniBatch 会让结果晚一个攒批时间出来(本例是 1 秒),
allow-latency要按延迟要求设置; - 开了 MiniBatch 也不一定就是两阶段,还要满足聚合函数支持合并等条件,本文只验证了
COUNT(*); - 两阶段聚合主要解决热点 key,本文没有做性能对比,不能得出"一定更快"的结论;
- 批模式的两阶段聚合是另一套规则,本文没有验证。
记住这几点
- 流模式下,
TWO_PHASE要配合 MiniBatch 才会生效,单独设置没有任何提示。 - MiniBatch 的
enabled、allow-latency、size三项要一起配,只配一半会直接报错。 - 拿不准优化有没有生效时,用
PLAN_ADVICE看执行计划和建议。