
Flink 2.x 源码精读(五·上):一条 SQL 是怎么变成 Transformation 的
Apache Flink 源码学习
作者 X老师(DaemonforY),Flink 2.3.0 源码,按 CC BY-NC-SA 4.0 发布。
本系列基于 Apache Flink 2.3.0,文中
文件:行号都在release-2.3.0上核对过,运行结果来自本机实测(Apple M5 Pro,JDK 17)。 路径缩写:API=flink-table/flink-table-api-java/src/main/java/org/apache/flink/table/api,PLN=flink-table/flink-table-planner/src/main,TRT=flink-table/flink-table-runtime/src/main/java/org/apache/flink/table/runtime前置阅读:第一讲上篇(Transformation → StreamGraph)
先看一个实验。
一张 datagen 表 words(word STRING),一条最简单的聚合:
SELECT word, COUNT(*) AS cnt FROM words GROUP BY word我想让它用两阶段聚合(先在上游做一次局部聚合,再 shuffle 到下游做全局聚合,用来缓解热点 key)。文档里有一个配置项正好是干这个的:
conf.setString("table.optimizer.agg-phase-strategy", "TWO_PHASE");用 explainSql 看执行计划。下面是本机实际输出的 Optimized Physical Plan,上面是默认配置,下面是设置了 TWO_PHASE 之后:
-- 默认配置
GroupAggregate(groupBy=[word], select=[word, COUNT(*) AS cnt], changelogMode=[I,UA])
+- Exchange(distribution=[hash[word]], changelogMode=[I])
   +- TableSourceScan(table=[[default_catalog, default_database, words]], fields=[word], changelogMode=[I])

-- table.optimizer.agg-phase-strategy = TWO_PHASE
GroupAggregate(groupBy=[word], select=[word, COUNT(*) AS cnt], changelogMode=[I,UA])
+- Exchange(distribution=[hash[word]], changelogMode=[I])
   +- TableSourceScan(table=[[default_catalog, default_database, words]], fields=[word], changelogMode=[I])
一字不差。 日志里也没有任何警告。
再看这个配置项的说明(API/config/OptimizerConfigOptions.java:46-55),对 TWO_PHASE 的描述是"强制使用两阶段聚合",只提了一个例外:聚合函数不支持拆成两阶段时,仍然用一阶段。COUNT(*) 显然是支持的。
那它为什么没生效?
答案在优化器的一条规则里:流模式下,两阶段聚合要求先开启 MiniBatch。 这一点在官方文档的调优页面(docs/content/docs/dev/table/tuning.md:112)写了,但配置项本身的说明里没有。
这一篇,我们就顺着"这条规则在哪、什么时候执行",把一条 SQL 变成 Transformation 的全过程走一遍:
- SQL 文本是怎么变成一棵树的?中间经过哪几种树?
- 优化器分哪几个阶段?哪些是基于规则的,哪些是基于代价的?
- 两阶段聚合的规则什么时候执行?要满足哪几个条件?
- ExecNode 是什么?为什么要多这一层?
- 生成的代码长什么样?在哪里编译?
一、全景图:四种树,五个步骤
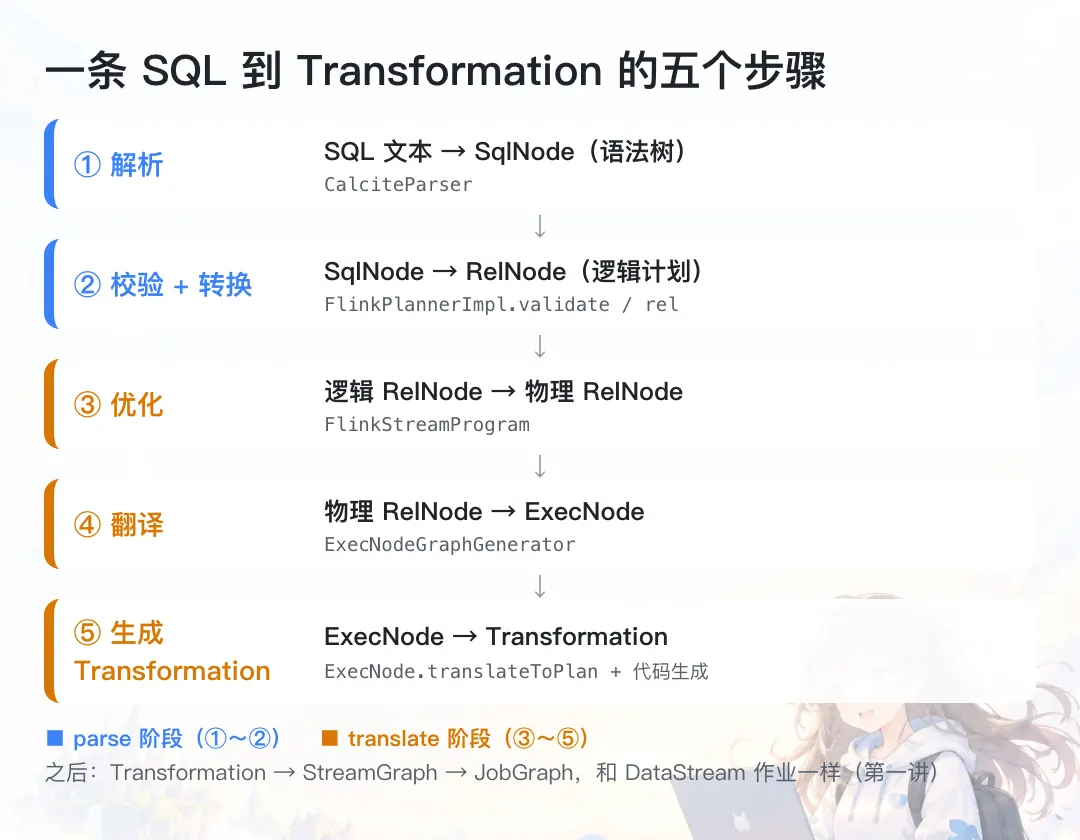
一条 SQL 从文本到 Transformation,大致经过这几步:
| 步骤 | 输入 → 输出 | 主要代码 |
|---|---|---|
| ① 解析 | SQL 文本 → SqlNode(语法树) | CalciteParser |
| ② 校验 + 转换 | SqlNode → RelNode(逻辑计划) | FlinkPlannerImpl.validate / rel |
| ③ 优化 | 逻辑 RelNode → 物理 RelNode | FlinkStreamProgram |
| ④ 翻译 | 物理 RelNode → ExecNode | ExecNodeGraphGenerator |
| ⑤ 生成 Transformation | ExecNode → Transformation | ExecNode.translateToPlan + 代码生成 |
之后的事情就和 DataStream 作业一样了:Transformation → StreamGraph → JobGraph,这是第一讲的内容。
explainSql 打印的三段,正好对应其中三种树:
== Abstract Syntax Tree ==:② 转换出来的逻辑计划(名字叫 AST,打印的其实是LogicalAggregate这种RelNode)== Optimized Physical Plan ==:③ 优化后的物理计划== Optimized Execution Plan ==:④ 翻译后的 ExecNode
①~② 发生在 parse 阶段,③~⑤ 发生在 translate 阶段,下面分开看。
二、解析、校验、转换
2.1 入口
sqlQuery 和 executeSql 都在 API/internal/TableEnvironmentImpl.java(:920、:940),它们都调用 getParser().parse(...)。
parse 的实现在 PLN/java/org/apache/flink/table/planner/delegation/ParserImpl.java:91-108:
// ParserImpl.java:95-107(节选)
Optional<Operation> command = EXTENDED_PARSER.parse(statement);
if (command.isPresent()) {
    return Collections.singletonList(command.get());
}
SqlNodeList sqlNodeList = parser.parseSqlList(statement);
...
return Collections.singletonList(
        SqlNodeToOperationConversion.convert(planner, catalogManager, parsed.get(0))
                .orElseThrow(...));
两点值得注意:
- 先走
EXTENDED_PARSER:SET、RESET、CLEAR、HELP、QUIT这几个命令(PLN/java/org/apache/flink/table/planner/parse/下的 5 个*ParseStrategy),用正则直接匹配,不进 Calcite。 - 一次只接受一条语句(
parsed.size() == 1)。
2.2 解析:文本 → SqlNode
CalciteParser.parseSqlList(PLN/java/org/apache/flink/table/planner/parse/CalciteParser.java:73)调用 Calcite 的解析器。这个解析器是 Flink 用 JavaCC 生成的,在 Calcite 默认语法的基础上加了 Flink 的扩展语法(CREATE TABLE ... WITH (...)、WATERMARK FOR 等)。
这一步只看语法:表存不存在、字段类型对不对,都不管。
2.3 校验:查 Catalog,推导类型
SqlNodeToOperationConversion.convert(PLN/java/org/apache/flink/table/planner/operations/SqlNodeToOperationConversion.java:172-177)第一行就是校验:
final SqlNode validated = flinkPlanner.validate(sqlNode);FlinkPlannerImpl.validate(PLN/scala/org/apache/flink/table/planner/calcite/FlinkPlannerImpl.scala:117)里,校验器会去 Catalog 里查表和函数,推导每个表达式的类型。"表不存在"、"字段不存在"、"类型不匹配"这类报错,都是在这一步抛出的。
2.4 转换:SqlNode → RelNode
校验之后,查询语句交给 SqlQueryConverter(PLN/java/org/apache/flink/table/planner/operations/converters/SqlQueryConverter.java:46-50):
RelRoot relational = context.toRelRoot(node);
return new PlannerQueryOperation(
        relational.project(), () -> context.toQuotedSqlString(node));
toRelRoot 最终调用 FlinkPlannerImpl.rel(FlinkPlannerImpl.scala:209),由 Calcite 的 SqlToRelConverter 把语法树转成关系代数树,也就是 explain 里 Abstract Syntax Tree 那一段:
LogicalAggregate(group=[{0}], cnt=[COUNT()])
+- LogicalTableScan(table=[[default_catalog, default_database, words]])
到这里,SQL 变成了一个 Operation,里面包着一棵逻辑 RelNode 树。还没有任何优化。
三、PlannerBase.translate:四行代码
真正的翻译在 PLN/scala/org/apache/flink/table/planner/delegation/PlannerBase.scala:175-188,核心就四行:
val relNodes = modifyOperations.asScala.map(translateToRel)                     // :182
val optimizedRelNodes = optimize(relNodes)                                      // :183
val execGraph = translateToExecNodeGraph(optimizedRelNodes, isCompiled = false) // :184
val transformations = translateToPlan(execGraph) // :185translateToRel(PlannerBase.scala:248):把每个ModifyOperation转成以 Sink 节点为根的RelNode(INSERT 有 Sink,collect()、print()也有)optimize:优化,第四节translateToExecNodeGraph:物理计划 → ExecNode,第五节translateToPlan:ExecNode → Transformation,第六节
顺便一提:compilePlan(PlannerBase.scala:216 起)走的是同样的前三步,只是第三步传 isCompiled = true,然后把 ExecNode 图序列化成 JSON,而不是直接翻译成 Transformation。这就是 COMPILE PLAN 功能的实现。第五节会解释为什么序列化的是 ExecNode,而不是 RelNode。
四、优化器:13 个阶段
4.1 先切成块
流模式的优化器是 StreamCommonSubGraphBasedOptimizer(StreamPlanner.scala:74)。它先用 RelNodeBlockPlanBuilder.buildRelNodeBlockPlan(PLN/scala/org/apache/flink/table/planner/plan/optimize/StreamCommonSubGraphBasedOptimizer.scala:114)把多个 Sink 共享的子图切成块(block),每块单独优化。目的是让一个 StatementSet 里多个 INSERT 共享的部分只优化一次、只生成一份(实际能不能复用,还受 table.optimizer.reuse-sub-plan-enabled、table.optimizer.reuse-source-enabled 两个配置影响,本篇没有展开)。
本篇的例子只有一条查询,只有一块。
4.2 13 个阶段
每一块都按 FlinkStreamProgram(PLN/scala/org/apache/flink/table/planner/plan/optimize/program/FlinkStreamProgram.scala)定义的顺序执行。阶段名定义在 :32-44,一共 13 个:
| # | 阶段 | 方式 | 做什么(简述) |
|---|---|---|---|
| 1 | subquery_rewrite | HEP | 子查询改写成 Join |
| 2 | temporal_join_rewrite | HEP | 时态表 Join 改写 |
| 3 | decorrelate | 专用程序 | 去关联 |
| 4 | default_rewrite | HEP | 默认的改写规则 |
| 5 | predicate_pushdown | HEP | 谓词下推(包括推到 Source) |
| 6 | join_reorder | HEP | Join 重排,默认不执行(:210,table.optimizer.join-reorder-enabled 默认 false) |
| 7 | multi_join | HEP | 把多个二元 Join 合并成 MultiJoin |
| 8 | project_rewrite | HEP | 投影改写 |
| 9 | logical | Volcano | 逻辑优化,转换到 FlinkLogical* 节点 |
| 10 | logical_rewrite | HEP | 逻辑改写 |
| 11 | time_indicator | 专用程序 | 处理时间属性字段 |
| 12 | physical | Volcano | 选物理实现,转换到 StreamPhysical* 节点 |
| 13 | physical_rewrite | HEP + 专用程序 | Changelog 推导、MiniBatch、两阶段聚合…… |
"做什么"一列是按阶段名和规则集名称做的简述,没有逐条展开每个规则集。
两种方式的区别:
- HEP(
HepPlanner):基于规则。按顺序拿规则去匹配,匹配上就改写,不比较代价。 - Volcano(
VolcanoPlanner):基于代价。把等价的计划都保留下来,最后选代价最低的。
只有第 9、12 两个阶段用 Volcano(:262-268、:294-300),其余都是 HEP 或专用程序。
4.3 两阶段聚合在最后一个阶段
第 13 个阶段 physical_rewrite(FlinkStreamProgram.scala:303-359)由一组程序按顺序组成:
mark changelog normalize reusing same sourcewatermark transposeChangelog mode inference(:327)Initialization for mini-batch interval inferencemini-batch interval rulesinitialization for duplicate changes inferenceduplicate changes rulesphysical rewrite(:350-356)
最后一步用的规则集是 FlinkStreamRuleSets.PHYSICAL_REWRITE(PLN/scala/org/apache/flink/table/planner/plan/rules/FlinkStreamRuleSets.scala:547-556):
val PHYSICAL_REWRITE: RuleSet = RuleSets.ofList(
  TwoStageOptimizedAggregateRule.INSTANCE,
  IncrementalAggregateRule.INSTANCE,
  TwoStageOptimizedWindowAggregateRule.INSTANCE,
  DeltaJoinRewriteRule.INSTANCE
)
两阶段聚合规则 TwoStageOptimizedAggregateRule 排在第一个。
这个顺序很关键:它排在 Changelog 推导之后。也就是说,判断能不能拆成两阶段的时候,优化器已经知道每个节点的输入是只有 INSERT,还是带着撤回消息。下篇会看到,这直接影响聚合函数要不要生成 retract 方法。
五、两阶段聚合要满足哪几个条件
规则的 matches 方法在 PLN/java/org/apache/flink/table/planner/plan/rules/physical/stream/TwoStageOptimizedAggregateRule.java:86-94:
boolean isMiniBatchEnabled =
        tableConfig.get(ExecutionConfigOptions.TABLE_EXEC_MINIBATCH_ENABLED);
boolean isTwoPhaseEnabled =
        getAggPhaseStrategy(tableConfig) != AggregatePhaseStrategy.ONE_PHASE;

return isMiniBatchEnabled && isTwoPhaseEnabled && matchesTwoStage(call.rel(0), call.rel(2));
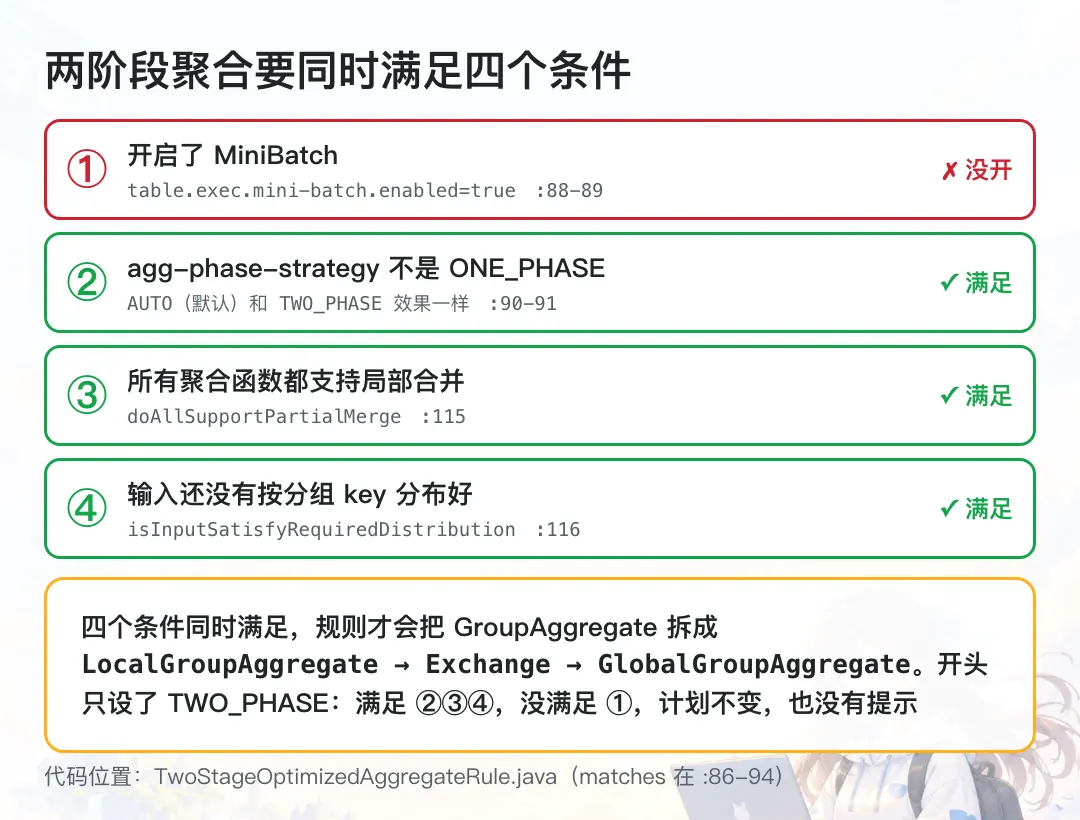
matchesTwoStage 在 :96-116。合起来,要拆成两阶段,需要同时满足:
| # | 条件 | 代码位置 |
|---|---|---|
| ① | 开启了 MiniBatch(table.exec.mini-batch.enabled=true) | :88-89 |
| ② | agg-phase-strategy 不是 ONE_PHASE | :90-91 |
| ③ | 所有聚合函数都支持局部合并(partial merge) | :115,doAllSupportPartialMerge |
| ④ | 输入还没有按分组 key 分布好(否则不需要 shuffle,也就没必要先局部聚合) | :116,isInputSatisfyRequiredDistribution |
另外,规则的匹配模式是"聚合 → Exchange → 输入"(:204-215),中间必须有一个 Exchange。
回到开头:我们满足了 ②③④,但没满足 ①。matches 返回 false,规则不执行,计划保持原样,没有任何提示。
再看条件 ②:判断的是"不等于 ONE_PHASE"。所以在流模式下,AUTO(默认值)和 TWO_PHASE 在这条规则里的效果是一样的。配置项说明里写的 AUTO "depends on cost"(取决于代价),至少在这条规则里没有看到代价的比较:这条规则在 HEP 阶段执行,只要条件满足就会改写。
以上只针对流模式的这条规则。批模式的两阶段聚合是另一套规则,本篇没有看。
实测:四种配置
SqlDemo explain 一共跑了四种配置(都是并行度 2)。物理计划如下,本机实际输出,完整日志在 assets/logs/sql-explain.log:
① 默认配置 和 ② 只设 TWO_PHASE:开头已经看过,完全一样。
③ 开 MiniBatch,但设成 ONE_PHASE:
GroupAggregate(groupBy=[word], select=[word, COUNT(*) AS cnt], changelogMode=[I,UA])
+- Exchange(distribution=[hash[word]], changelogMode=[I])
   +- MiniBatchAssigner(interval=[1000ms], mode=[ProcTime], changelogMode=[I])
      +- TableSourceScan(table=[[default_catalog, default_database, words]], fields=[word], changelogMode=[I])
多了一个 MiniBatchAssigner,这是 physical_rewrite 第 5 步 mini-batch interval rules 加上的。聚合还是一个。
④ 开 MiniBatch,agg-phase-strategy 保持默认 AUTO:
GlobalGroupAggregate(groupBy=[word], select=[word, COUNT(count1$0) AS cnt], changelogMode=[I,UA])
+- Exchange(distribution=[hash[word]], changelogMode=[I])
   +- LocalGroupAggregate(groupBy=[word], select=[word, COUNT(*) AS count1$0], changelogMode=[I])
      +- MiniBatchAssigner(interval=[1000ms], mode=[ProcTime], changelogMode=[I])
         +- TableSourceScan(table=[[default_catalog, default_database, words]], fields=[word], changelogMode=[I])
这才是两阶段:
LocalGroupAggregate在 Exchange 之前,先在本地按 word 数一遍,输出中间结果count1$0;GlobalGroupAggregate在 Exchange 之后,把各个上游的中间结果加起来:COUNT(count1$0),这里的COUNT是对局部计数做合并,不是再数一遍行数。
为什么一定要 MiniBatch?局部聚合要先"攒"一批数据才有意义。 如果来一条处理一条,局部聚合每次只能聚合 1 条,等于原样往下游发,还多了一层开销。MiniBatch 提供了"攒一批"的边界(这里是 1 秒或 1000 条),文档里的原话是:local-global aggregation depends on mini-batch optimization is enabled(tuning.md:112)。
一个可以改进的地方:
agg-phase-strategy的配置说明里没有提到 MiniBatch 这个前提,设置了TWO_PHASE但没开 MiniBatch 时也没有任何警告。我还没有去社区确认这是否是有意为之,这只是我的观察,不代表社区的结论。补充(2026-10-03):普通的
explain确实没有提示,但加上ExplainDetail.PLAN_ADVICE(SQL 中是EXPLAIN PLAN_ADVICE <查询>)后,Flink 会给出建议:"You might want to enable local-global two-phase optimization by configuring ('table.exec.mini-batch.enabled' to 'true', ...)"(GroupAggregationAnalyzer.java:98-129,本机实测见踩坑实验室 #16,content-plan/33-踩坑实验室16-两阶段聚合没生效.md)。
六、ExecNode:为什么要多一层
优化后的物理计划(StreamPhysical* 节点)已经确定了每一步怎么执行,为什么还要再翻译成 ExecNode?
看 explain 的第三段 Optimized Execution Plan,和物理计划几乎一样,只是去掉了 changelogMode 这类优化期的属性:
GlobalGroupAggregate(groupBy=[word], select=[word, COUNT(count1$0) AS cnt])
+- Exchange(distribution=[hash[word]])
   +- LocalGroupAggregate(groupBy=[word], select=[word, COUNT(*) AS count1$0])
      +- MiniBatchAssigner(interval=[1000ms], mode=[ProcTime])
         +- TableSourceScan(table=[[default_catalog, default_database, words]], fields=[word])
区别在于:RelNode 依赖 Calcite 的优化器上下文,不适合序列化;ExecNode 是可以序列化成 JSON 的,它只保留"生成算子需要的信息"。
看 StreamExecGroupAggregate 类上的注解(PLN/java/org/apache/flink/table/planner/plan/nodes/exec/stream/StreamExecGroupAggregate.java:80-83):
@ExecNodeMetadata(
        name = "stream-exec-group-aggregate",
        version = 1,
        consumedOptions = {"table.exec.mini-batch.enabled", "table.exec.mini-batch.size"},
每个 ExecNode 有名字和版本号,还声明了自己用到哪些配置。这就是 COMPILE PLAN 能工作的基础:把 ExecNode 图存成 JSON,升级 Flink 版本后再加载,不重新走一遍优化器,这样执行计划就不会因为优化规则变化而改变,状态也就能继续兼容。
PlannerBase.translateToExecNodeGraph(PlannerBase.scala:412-429)做的就是:检查所有节点都是物理节点,用 ExecNodeGraphGenerator 生成 ExecNode 图,然后依次执行 getExecNodeGraphProcessors 返回的处理器。流模式下这个列表是空的(StreamPlanner.scala:76 返回 Seq());批模式下有 DeadlockBreakupProcessor 等(BatchPlanner.scala:74 起)。
七、ExecNode → Transformation:代码生成
7.1 translateToPlan
ExecNodeBase.translateToPlan(PLN/java/org/apache/flink/table/planner/plan/nodes/exec/ExecNodeBase.java:180-183)带缓存:transformation == null 时才调用子类的 translateToPlanInternal。所以一个被多个下游共享的节点,只会生成一个 Transformation。
看聚合节点的 translateToPlanInternal(StreamExecGroupAggregate.java:171 起):
- 用
AggsHandlerCodeGenerator生成聚合逻辑:generator.generateAggsHandler("GroupAggsHandler", aggInfoList)(:216) - 用
EqualiserCodeGenerator生成比较结果是否变化的代码:GroupAggValueEqualiser(:226-228) - 根据配置选算子(
:231-268):- 开了 MiniBatch:
KeyedMapBundleOperator(攒一批再处理) - 开了异步状态:
AsyncKeyedProcessOperator - 否则:
KeyedProcessOperator+GroupAggFunction
- 开了 MiniBatch:
- 包成一个
OneInputTransformation(:272)
第 3 步说明:MiniBatch 不只是加了一个 MiniBatchAssigner 节点,聚合算子本身也换了实现。
最后一步生成的是普通的 KeyedProcessOperator,和你在 DataStream 里写的 keyBy().process() 是同一个算子。SQL 最终也是 DataStream 算子。
7.2 生成的代码长什么样
AggsHandlerCodeGenerator 生成的是一段 Java 源码字符串。SqlDemo codegen 打开了 CompileUtils 的 DEBUG 日志,可以把它打印出来:
JAVA_TOOL_OPTIONS=-Dcodegen.level=DEBUG ./run.sh study.sql.SqlDemo codegen这次运行的输入是两行常量 ('a'), ('b'),查询还是 Q1,默认配置(一阶段)。日志里一共编译了 4 个类:StreamExecValues$2、GroupAggsHandler$6、KeyProjection$0、GroupAggValueEqualiser$0。下面是 GroupAggsHandler$6 的 accumulate 方法(本机实际输出,删掉了空行,完整日志在 assets/logs/sql-codegen.log):
public final class GroupAggsHandler$6 implements org.apache.flink.table.runtime.generated.AggsHandleFunction {
  long agg0_count1;
  boolean agg0_count1IsNull;
  ...
  @Override
  public void accumulate(org.apache.flink.table.data.RowData accInput) throws Exception {
    boolean isNull$3;
    long result$4;
    isNull$3 = agg0_count1IsNull || false;
    result$4 = -1L;
    if (!isNull$3) {
    result$4 = (long) (agg0_count1 + ((long) 1L));
    }
    agg0_count1 = result$4;;
    agg0_count1IsNull = isNull$3;
  }

  @Override
  public void retract(org.apache.flink.table.data.RowData retractInput) throws Exception {
    throw new java.lang.RuntimeException("This function not require retract method, but the retract method is called.");
  }
几个观察:
COUNT(*)被展开成一个long字段agg0_count1,每来一条就+1L,没有虚函数调用,也没有装箱。这就是代码生成的意义:把通用的逻辑,按具体的查询"展开"成专用代码。retract方法直接抛异常:因为 Q1 的输入只有 INSERT(changelogMode=[I]),不需要撤回。这正是第四节说的:Changelog 推导排在前面,代码生成时已经知道要不要 retract。 下篇我们会看到,嵌套聚合时外层用的是COUNT_RETRACT。
7.3 在哪里编译
日志里每个类前面都有一行,比如:
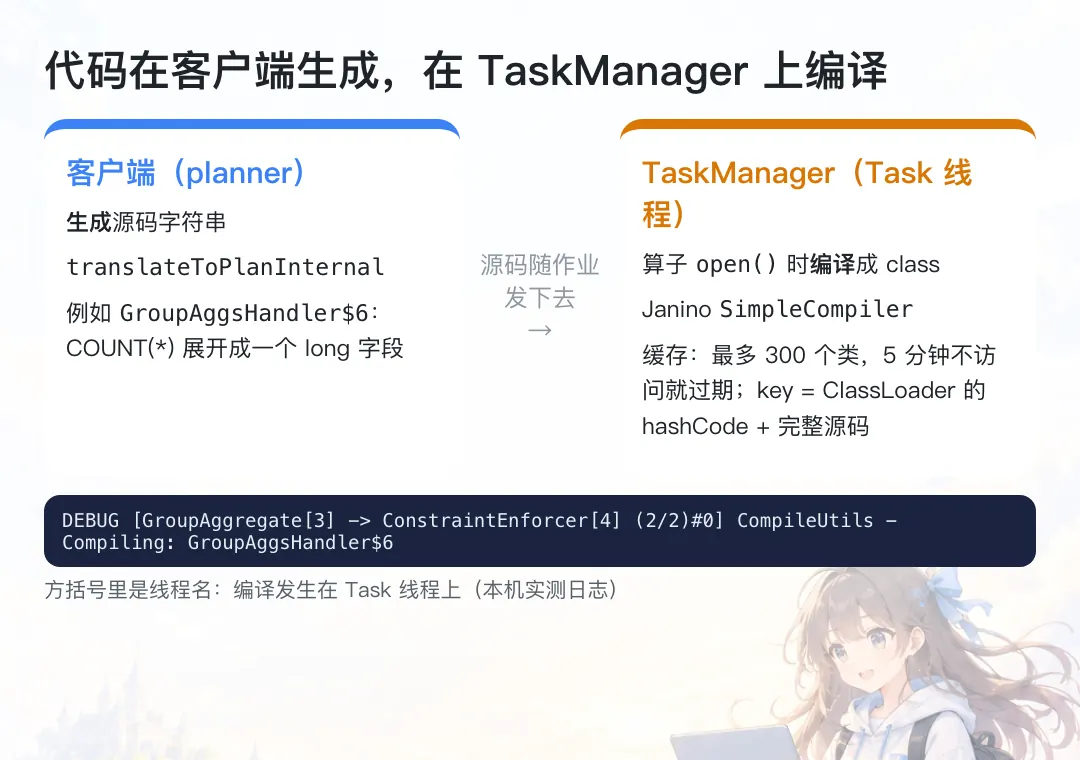
17:17:16,864 DEBUG [GroupAggregate[3] -> ConstraintEnforcer[4] (2/2)#0] CompileUtils - Compiling: GroupAggsHandler$6方括号里是线程名:GroupAggregate[3] -> ConstraintEnforcer[4] (2/2)#0,这是 Task 线程。也就是说:
- 生成源码字符串,发生在客户端的 planner 里(
translateToPlanInternal); - 编译成 class,发生在 TaskManager 上,算子
open()的时候。
对应的代码:GroupAggFunctionBase.open 里调用 genAggsHandler.newInstance(...)(TRT/operators/aggregate/GroupAggFunctionBase.java:82),GeneratedClass.compile 再调用 CompileUtils.compile(TRT/generated/GeneratedClass.java:92-101)。
CompileUtils(TRT/generated/CompileUtils.java)用的是 Janino(:101 的 SimpleCompiler),一个轻量的 Java 编译器,比 javac 快得多。编译结果放在缓存里(:52-57:最多 300 个类,5 分钟没访问就过期)。缓存的 key 是 ClassLoader 的 hashCode + 完整源码(:91,源码里包含类名)。所以同一个 TaskManager 上、用同一个 ClassLoader 的多个并行实例,相同的代码只会编译一次。
从这次的日志里也能看到:两个并行实例(
1/2、2/2)中,GroupAggsHandler$6只在2/2打印了一次Compiling,GroupAggValueEqualiser$0只在1/2打印了一次。这和缓存的行为是一致的,但我只跑了这一次,没有专门设计实验去验证缓存命中。
八、自己动手
示例代码在 flink-notes/demos:
./run.sh study.sql.SqlDemo explainJAVA_TOOL_OPTIONS=-Dcodegen.level=DEBUG ./run.sh study.sql.SqlDemo codegen推荐的断点(按执行顺序):
| 断点 | 看什么 |
|---|---|
ParserImpl.java:102 | parseSqlList 之后的 SqlNode |
SqlNodeToOperationConversion.java:175 | 校验后的 SqlNode(字段名已经补全) |
PlannerBase.scala:183 | 优化前后的 RelNode,对比 relNodes 和 optimizedRelNodes |
TwoStageOptimizedAggregateRule.java:93(return 那一行) | 四种配置下 isMiniBatchEnabled、isTwoPhaseEnabled 的值 |
StreamExecGroupAggregate.java:231 | 选的是哪个算子 |
CompileUtils.java:100 | 生成的源码字符串 |
想看每个优化阶段之后的计划:把 org.apache.flink.table.planner.plan.optimize.program.FlinkChainedProgram 的日志级别调到 DEBUG。每个阶段执行完,它会打印 optimize <阶段名> cost <耗时> ms. 和当前的计划(FlinkChainedProgram.scala:62-66)。我没有在本篇的实验里打开它,具体输出请以你本机为准。
九、课后练习
- 验证条件 ③:把 Q1 里的
COUNT(*)换成一个不支持merge的自定义聚合函数(只实现accumulate),开 MiniBatch,看计划还会不会拆成两阶段。 - 验证条件 ④:如果输入已经按
word分布好了(比如前面已经有一个按word的GROUP BY),还会拆成两阶段吗? - ONE_PHASE + MiniBatch:实验 ③ 里只有一个聚合,它用的是哪个算子?在
StreamExecGroupAggregate.java:231打断点验证。 - 思考:两阶段聚合能缓解热点 key,但它对
COUNT(DISTINCT ...)有用吗?(提示:看table.optimizer.distinct-agg.split.enabled)
写在最后
这一讲的核心可以用一句话概括:SQL 先变成关系代数树,经过 13 个阶段的优化,变成 ExecNode,最后生成代码,落到和 DataStream 一样的算子上。
开头的问题也有了答案:两阶段聚合是 physical_rewrite 阶段的一条 HEP 规则,它的第一个条件就是 MiniBatch 已开启。没开 MiniBatch,TWO_PHASE 不会生效,也不会有提示。
实际使用时的建议:想用两阶段聚合,同时设置这三项,再用 EXPLAIN 确认计划里出现了 LocalGroupAggregate / GlobalGroupAggregate:
conf.setString("table.exec.mini-batch.enabled", "true");
conf.setString("table.exec.mini-batch.allow-latency", "1 s");
conf.setString("table.exec.mini-batch.size", "1000");
agg-phase-strategy 保持默认 AUTO 即可。数值仅为示例,需要根据你的延迟要求调整。
还留了一个问题没讲:第一个实验里,计划上写着 changelogMode=[I,UA],这是什么意思?如果把 Q1 再套一层聚合:
SELECT cnt, COUNT(*) AS num_words FROM (SELECT word, COUNT(*) AS cnt FROM words GROUP BY word) GROUP BY cnt本机 explain 的结果里,内层聚合变成了 changelogMode=[I,UB,UA],外层用的是 COUNT_RETRACT(*),输出变成了 [I,UA,D]:
GroupAggregate(groupBy=[cnt], select=[cnt, COUNT_RETRACT(*) AS num_words], changelogMode=[I,UA,D])
+- Exchange(distribution=[hash[cnt]], changelogMode=[I,UB,UA])
   +- Calc(select=[cnt], changelogMode=[I,UB,UA])
      +- GroupAggregate(groupBy=[word], select=[word, COUNT(*) AS cnt], changelogMode=[I,UB,UA])
         +- Exchange(distribution=[hash[word]], changelogMode=[I])
            +- TableSourceScan(table=[[default_catalog, default_database, words]], fields=[word], changelogMode=[I])
同样是内层的 GROUP BY word,为什么套了一层之后要多输出 UB(撤回旧值)?这就是下篇的内容:Changelog 与撤回。
留一个问题:你在生产环境里用过两阶段聚合吗?有没有遇到过"配了却没生效"的情况?
下一讲:Flink 2.x 源码精读(五·下):Changelog,同一个 GROUP BY 为什么有时输出两条