
S2 第 6 讲:读路径——为什么有的查询要归并、有的不用
Apache Paimon 源码学习
作者 X老师(DaemonforY),Paimon 2.0 / master 源码,按 CC BY-NC-SA 4.0 发布。配套实验和代码在 GitHub。
TL;DR:主键表有两条读路径——直接读(
RawFileSplitRead,像 append 表一样顺序读文件)和合并读(MergeFileSplitRead,按 key 归并多个文件、同 key 取最新、最后去掉删除记录)。走哪条在规划阶段就由 split 上的rawConvertible决定:整个 bucket 都不在 L0、没有删除记录、且在同一层(或开启删除向量 / first-row 引擎)时整体直接读;否则切 section、装箱,只有一个文件且无删除记录的 split 才能直接读。合并读的代价不只是归并:重叠的 section 只能下推主键过滤;COUNT(*) 也没法只看元数据。
实验:5 张表、5 种文件状态
labs/sql/lab08/read-path.sql 建了 5 张 bucket = 1 的主键表,每张造出一种典型的文件状态($files 实测):
| 表 | 怎么写的 | 文件 |
|---|---|---|
r_one | 写 1 次(key 1~100) | 1 个 L0 文件 |
r_disjoint | 写 2 次,key 不重叠(1~100、101~200) | 2 个 L0 文件 |
r_overlap | 写 2 次,key 重叠(1~100、51~150) | 2 个 L0 文件 |
r_compact | 同 r_overlap,再全量合并 | 1 个 L5 文件(150 行) |
r_delete | 写入、全量合并,再 DELETE WHERE k = 5 | L5(100 行)+ L0(1 行,deleteRowCount = 1) |
每张表都用 SELECT v, COUNT(*) … GROUP BY v 查一次(为什么不用 COUNT(*),后面说),结果都正确:r_overlap 是 a 50 行、b 100 行,r_delete 是 99 行。
然后用 jdb 在规划(MergeTreeSplitGenerator)和两个 reader 上下断点:
cd labs && PAIMON_VERSION=2.2-SNAPSHOT ./jdb-stacks.sh sql/lab08/read-path.sql jdb/s2-6-read-path.txt 300一、两条读路径
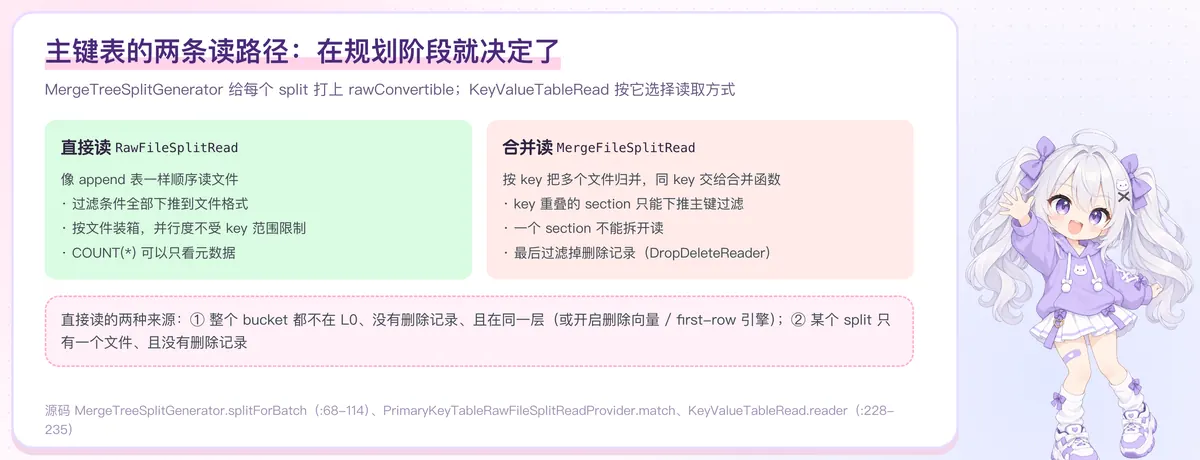
KeyValueTableRead.reader(第 228~235 行)依次问每个 SplitReadProvider “这个 split 归你吗”:
PrimaryKeyTableRawFileSplitReadProvider:!forceKeepDelete && !isStreaming && split.rawConvertible(),再加上所有文件都有deleteRowCount统计——直接读;MergeFileSplitReadProvider:兜底——合并读。
直接读 RawFileSplitRead | 合并读 MergeFileSplitRead | |
|---|---|---|
| 怎么读 | 顺序读文件,和 append 表一样 | 按 key 多路归并,同 key 交给合并函数 |
| 过滤 | 全部过滤条件下推到文件读取 | 重叠 section 只下推主键过滤 |
| 并行 | 按文件装箱 | 一个 section 不能拆 |
| 删除记录 | 不需要处理(文件里没有) | 最后用 DropDeleteReader 过滤 |
二、5 张表的实录
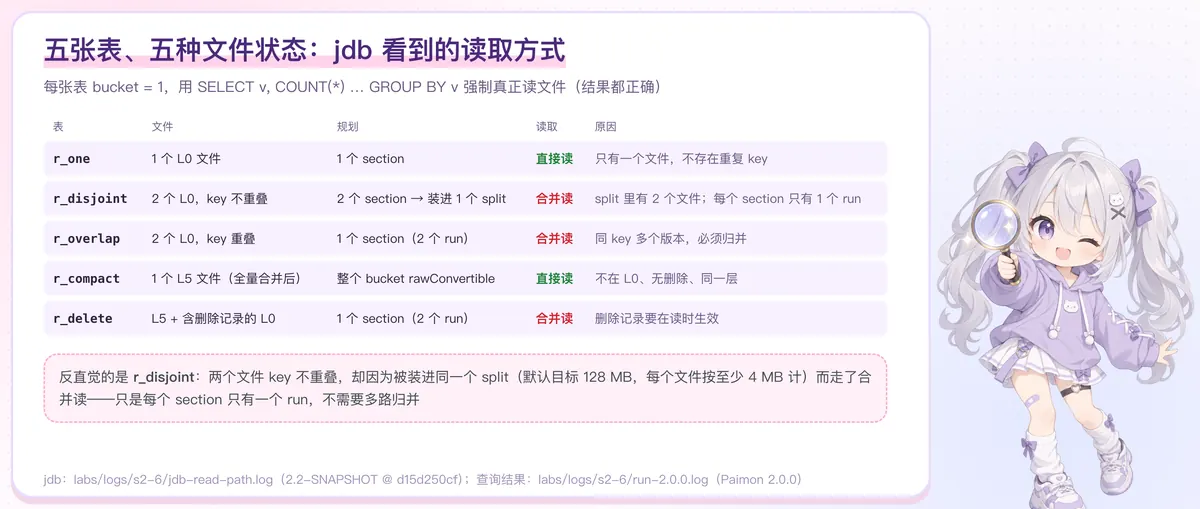
jdb 打印的读取方式:
r_one       RawFileSplitRead:169   split.dataFiles().size() = 1  rawConvertible = true
r_disjoint  MergeFileSplitRead:253 split.dataFiles().size() = 2  rawConvertible = false
              section.size() = 1  ×2
r_overlap   MergeFileSplitRead:253 split.dataFiles().size() = 2  rawConvertible = false
              section.size() = 2
r_compact   RawFileSplitRead:169   split.dataFiles().size() = 1  rawConvertible = true
r_delete    MergeFileSplitRead:253 split.dataFiles().size() = 2  rawConvertible = false
section.size() = 2前三个结论符合直觉:单文件直接读、重叠必须合并、全量合并后直接读。r_delete 也好理解:L0 里那条删除记录的 key 5 落在 L5 文件的 key 范围里,两者构成一个 2 个 run 的 section,删除要在读时生效。
r_disjoint 是反直觉的那个:两个文件 key 完全不重叠,却走了合并读。
三、为什么不重叠也要合并读:splitForBatch 的两步
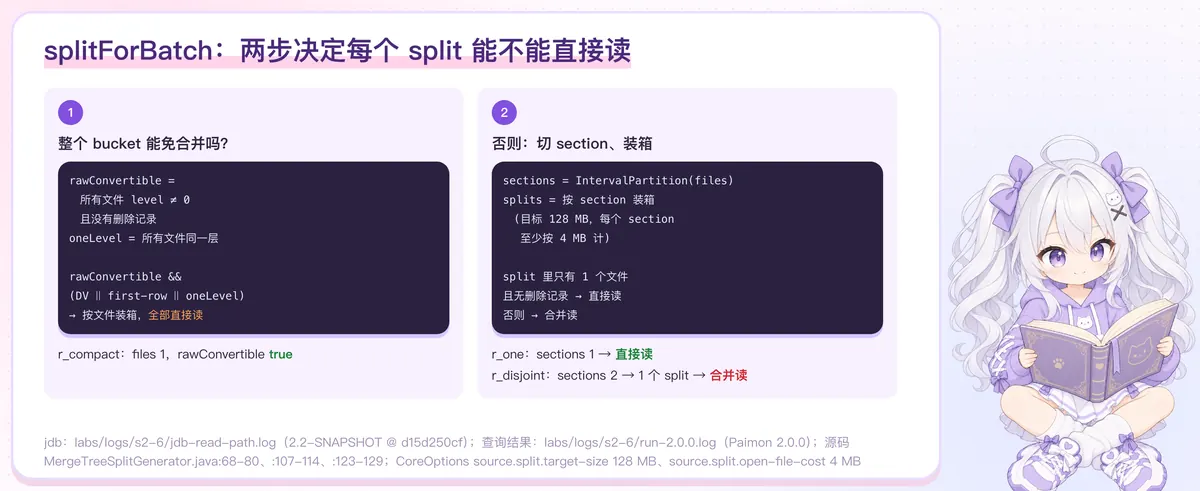
MergeTreeSplitGenerator.splitForBatch(第 68~114 行)分两步:
第一步:整个 bucket 能不能免合并?
boolean rawConvertible = files.stream().allMatch(file -> file.level() != 0 && withoutDeleteRow(file));
boolean oneLevel = files 全在同一层;
if (rawConvertible && (deletionVectorsEnabled || mergeEngine == FIRST_ROW || oneLevel)) {
    return 按文件大小装箱,每组都是 rawConvertible;
}jdb:r_compact 是 files.size() = 1, rawConvertible = true,直接返回。其余四张表都有 L0 文件,rawConvertible = false。
第二步:切 section,按 section 装箱。
List<List<DataFileMeta>> sections = new IntervalPartition(files, keyComparator).partition()...;
return packSplits(sections).stream()
        .map(f -> f.size() == 1 && withoutDeleteRow(f.get(0))
                ? SplitGroup.rawConvertibleGroup(f)      // 这个 split 只有一个文件 → 直接读
: SplitGroup.nonRawConvertibleGroup(f)) // 否则 → 合并读jdb:r_one 是 sections.size() = 1,装出来的 split 只有一个文件——直接读。r_disjoint 是 sections.size() = 2,但 packSplits 按 source.split.target-size(默认 128 MB)装箱,每个 section 至少按 source.split.open-file-cost(默认 4 MB)计——两个小 section 被装进了同一个 split,split 里有 2 个文件,于是打上 nonRawConvertible。
所以 r_disjoint 走的是 MergeFileSplitRead,但它的两个 section 各只有 1 个 run(jdb:section.size() = 1 两次)——每个 section 用的是“非重叠” reader,不需要多路归并,只是绕了一圈 KeyValue 的读取流程。
判断的单位是 split,不是“文件之间有没有重叠”。
四、合并读的隐藏代价:value 过滤不能下推
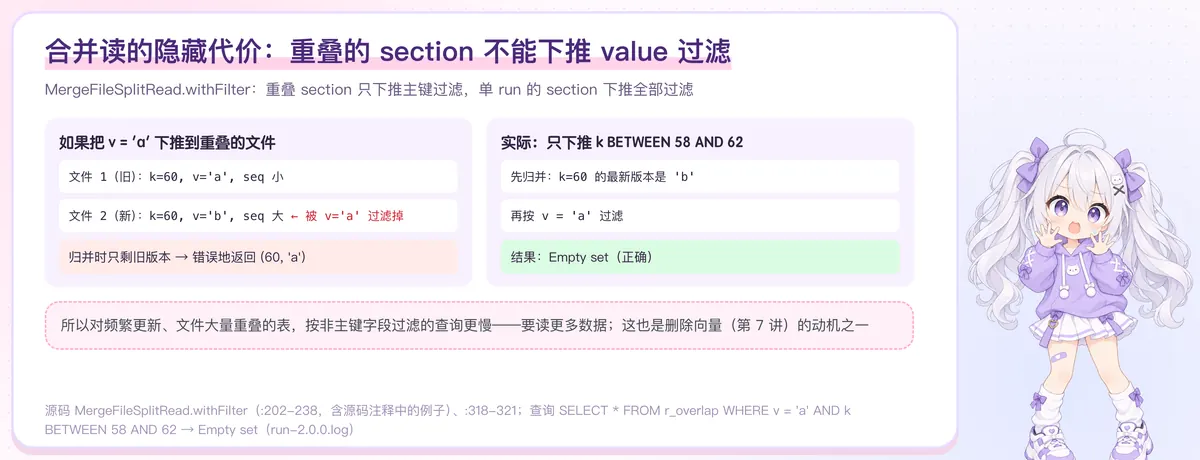
MergeFileSplitRead.withFilter(第 202~238 行)把过滤条件分成两组:
filtersForAll = 全部条件;
filtersForKeys = 只涉及主键的条件;
// 重叠的 section 用 filtersForKeys,单 run 的 section 用 filtersForAll(第 318~321 行)
源码注释给了原因。两个重叠的 run:
run1: (seq=1, k1, 100), (seq=2, k2, 200)
run2: (seq=3, k1, 10),  (seq=4, k2, 20)
如果把 value >= 100 下推下去,run2 整个被过滤,归并后 k1、k2 只剩旧版本 100、200——错的。
实验里对应的查询:
SELECT * FROM r_overlap WHERE v = 'a' AND k BETWEEN 58 AND 62;
-- Empty set
k 58~62 在第二次写入中被更新成了 'b'。只有先归并拿到最新版本、再按 v = 'a' 过滤,结果才是正确的空集。代价是:对频繁更新、文件大量重叠的表,按非主键字段过滤的查询要读更多数据。这正是第 7 讲删除向量要解决的问题之一。
五、直接读的额外红利:COUNT(*) 只看元数据
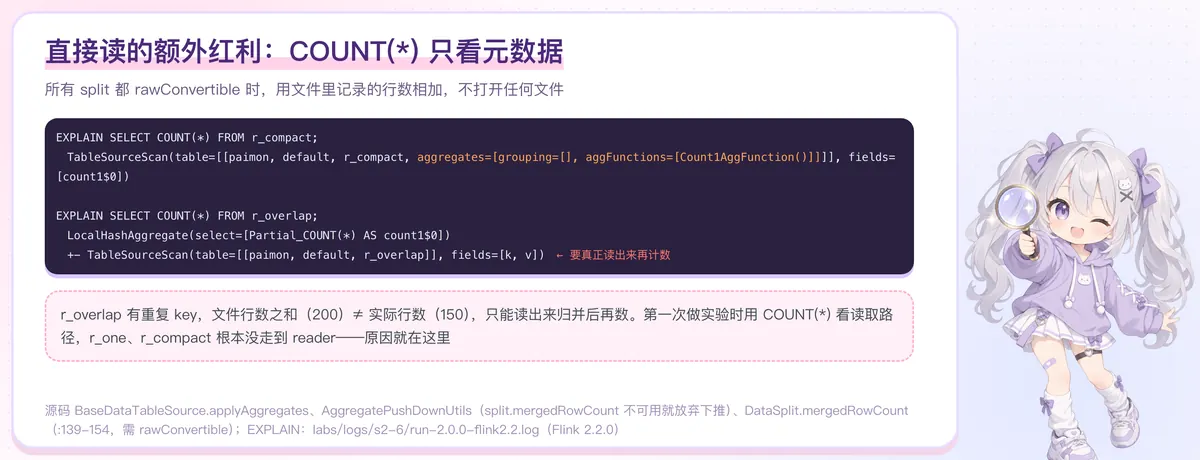
第一次做这个实验时,我用的是 SELECT COUNT(*) FROM r_one,结果 jdb 在 r_one、r_compact 上一次 reader 都没有命中。原因:Paimon 的 Flink source 实现了聚合下推(BaseDataTableSource.applyAggregates),所有 split 都能直接读时,COUNT(*) 直接用文件元数据里的行数相加(DataSplit.mergedRowCount,第 139~154 行,前提是 rawConvertible),根本不打开文件。
EXPLAIN SELECT COUNT(*) FROM r_compact;
  HashAggregate(isMerge=[true], select=[Final_COUNT(count1$0) AS EXPR$0])
  +- Exchange(distribution=[single])
     +- TableSourceScan(table=[[paimon, default, r_compact,
          aggregates=[grouping=[], aggFunctions=[Count1AggFunction()]]]], fields=[count1$0])

EXPLAIN SELECT COUNT(*) FROM r_overlap;
  HashAggregate(isMerge=[true], select=[Final_COUNT(count1$0) AS EXPR$0])
  +- Exchange(distribution=[single])
     +- LocalHashAggregate(select=[Partial_COUNT(*) AS count1$0])
        +- TableSourceScan(table=[[paimon, default, r_overlap]], fields=[k, v])
(节选自 Optimized Execution Plan;为排版把 r_compact 的 TableSourceScan 折成两行。)
r_compact 的计数已经在 TableSourceScan 里算好,Flink 只做最后一步汇总;r_overlap 则要把 k, v 真正读出来,由 Flink 的 LocalHashAggregate 逐行计数。同一条 SQL 在 Flink 1.20.1 上的计划写作 project=[k]、只读 k 一列,下推与否的结论相同。
r_overlap 两个文件行数之和是 200,实际只有 150 行(50 个 key 有两个版本),元数据算不出来,只能读出来归并再数。这也是为什么后面的读取实验改成了 GROUP BY v(按非分区字段分组不会被下推)。
小结:一张表判断读路径
| 文件状态 | 读路径 | 本讲的表 |
|---|---|---|
| 整个 bucket:无 L0、无删除、同一层 | 直接读(可按文件并行,COUNT(*) 下推) | r_compact |
| 开启删除向量 / first-row 引擎,且无 L0 | 直接读 | 第 7 讲 |
| split 里只有一个文件、无删除 | 直接读 | r_one |
| split 里多个文件(哪怕不重叠) | 合并读 | r_disjoint |
| key 重叠 / 有删除记录 | 合并读,重叠 section 只下推主键过滤 | r_overlap、r_delete |
生产启示
- 合并(compaction)不只是为了减少文件数:全量合并后文件在同一层,读取可以整体走直接读、过滤全下推、COUNT(*) 秒出。
- 频繁更新的表,按非主键字段过滤会变慢:重叠越多,下推越少。考虑删除向量模式(第 7 讲)或定期全量合并。
- 用 EXPLAIN 看 COUNT(*) 是否下推:出现
aggregates=[...]才是只看元数据。
下一讲:删除向量怎么把“读时去重”变成“写时标记”,让有更新的表也能直接读?
自测题:把 r_disjoint 的 source.split.target-size 调小,让两个 section 装进两个 split(例如 'source.split.target-size' = '4 mb',配合默认 4 MB 的 open-file-cost),读取会走哪条路?(答案:每个 split 只有一个文件、且无删除记录,两个 split 都直接读。按源码推导,未单独运行。)