
踩坑实验室 #19:Flink 不用加锁,但这两件事千万别做
Apache Flink 源码学习
作者 X老师(DaemonforY),Flink 2.3.0 源码,按 CC BY-NC-SA 4.0 发布。
基于 Flink 2.3.0 本机实测(核对日期 2026-10-04)。对应课程:第一讲(下)第五节「Mailbox:为什么不需要加锁」。配套示例:
flink-notes/demos/src/main/java/study/exec/MailboxBlockDemo.java
现象
一个 Task 里,processElement、定时器 onTimer、Checkpoint 快照、Checkpoint 完成通知,都在同一个 Task 线程里排队执行(Mailbox 模型),所以算子代码不需要加锁。这是 Flink 的便利之处,但它反过来也带来了两个坑:
- 在
processElement里同步调用一个慢操作,定时器和 Checkpoint 全部被拖慢; - 在自己开的线程里调用
state.update(),不报错,却写到了别的 key 上。
复现
示例 MailboxBlockDemo:并行度 1,每秒 10 条数据,Checkpoint 每 1 秒一次,HashMap 状态后端。
| 模式 | 做了什么 |
|---|---|
block | 每条数据注册一个"下一个整秒"的处理时间定时器,onTimer 里打印晚了多久;第 30 条数据时,processElement 里 sleep 5 秒 |
thread | 第 5 条数据时,另起一个线程调用 state.update(42),并 join() 等它结束 |
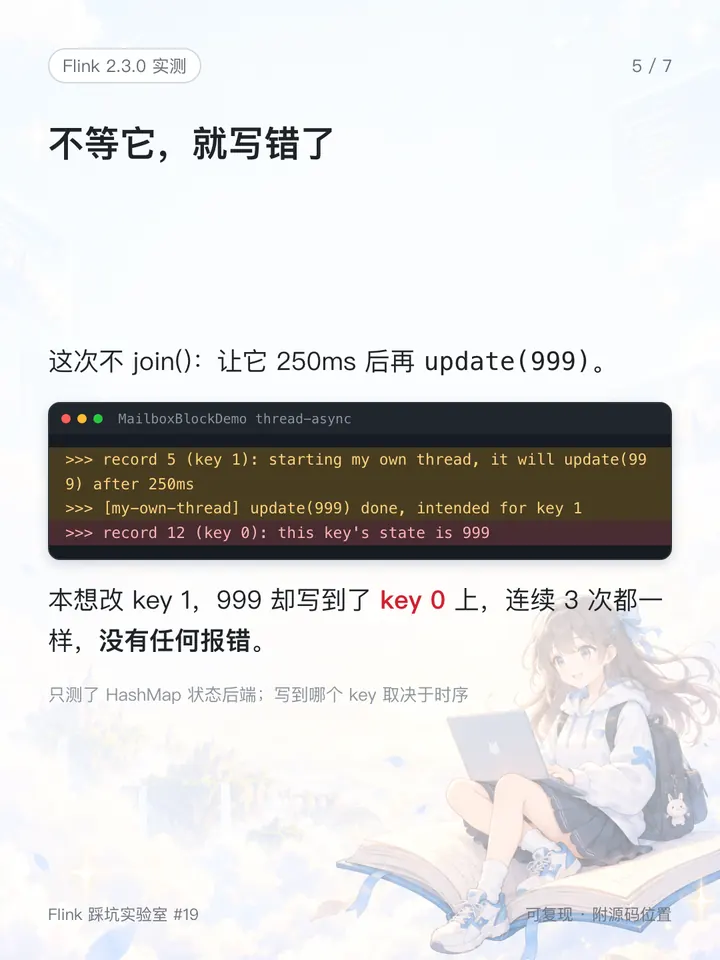
thread-async | 4 个 key 轮流来;处理 key 1 的第 5 条数据时,另起一个线程,sleep 250ms 后 update(999),不等它;之后每条数据检查自己 key 的状态是不是 999 |
block 模式的日志(节选):
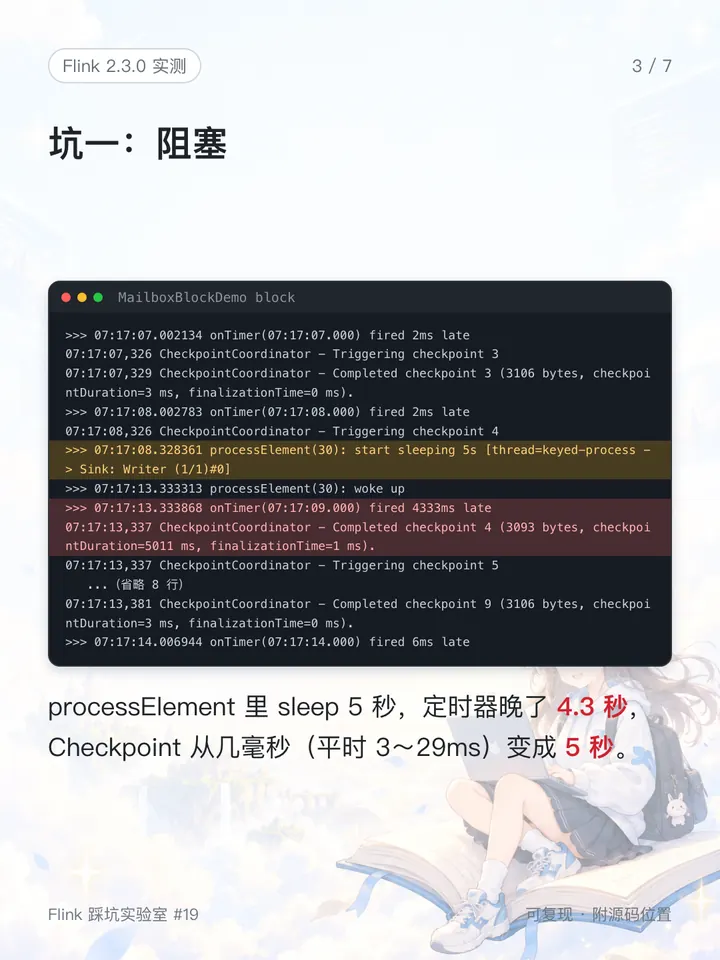
>>> 07:17:07.002134 onTimer(07:17:07.000) fired 2ms late
07:17:07,329 CheckpointCoordinator - Completed checkpoint 3 (3106 bytes, checkpointDuration=3 ms
>>> 07:17:08.002783 onTimer(07:17:08.000) fired 2ms late
07:17:08,326 CheckpointCoordinator - Triggering checkpoint 4 ...
>>> 07:17:08.328361 processElement(30): start sleeping 5s [thread=keyed-process -> Sink: Writer (1/1)#0]
>>> 07:17:13.333313 processElement(30): woke up
>>> 07:17:13.333868 onTimer(07:17:09.000) fired 4333ms late
07:17:13,337 CheckpointCoordinator - Completed checkpoint 4 (3093 bytes, checkpointDuration=5011 ms
07:17:13,337 CheckpointCoordinator - Triggering checkpoint 5 ...
...(checkpoint 5~9 在 07:17:13,337~13,381 之间连续触发并完成)
>>> 07:17:14.006944 onTimer(07:17:14.000) fired 6ms late
thread 和 thread-async 模式:
# thread
>>> [my-own-thread] state.update() from my own thread: no exception, value() now = 42

# thread-async
>>> record 5 (key 1): starting my own thread, it will update(999) after 250ms
>>> [my-own-thread] update(999) done, intended for key 1
>>> record 12 (key 0): this key's state is 999
汇总:
| 指标 | 结果 |
|---|---|
| sleep 期间应触发的定时器 | 晚了 4333ms |
| 同时进行的 Checkpoint 4 | 耗时 5011ms(平时 3~29ms) |
| 阻塞结束后 | Checkpoint 5~9 在 41ms 内连续触发并完成 |
thread-async 中 999 写到的 key | key 0(本想写 key 1),连续 3 次相同 |
block、thread 只跑了一次,thread-async 跑了 3 次。
原因
坑一:阻塞。 所有回调都在同一个线程里排队(MailboxProcessor.java:214 起),一个回调不返回,其他回调都得等。sleep 的 5 秒里,定时器和 Checkpoint 都在 Mailbox 里等着,processElement 一返回它们才轮到,于是定时器晚了 4 秒多,Checkpoint 从几毫秒变成了 5 秒。日志里 10~13 秒的定时器没有出现,是因为 sleep 期间没有处理任何数据,也就没有注册这几个定时器。之后 Checkpoint 5~9 连续完成:Checkpoint 的触发请求有一个队列(CheckpointRequestDecider.java:58、:113-119),这几次是排队的定时触发,这一点是按代码推断的。
坑二:跨线程改状态。 keyed state 的读写用的是状态后端里的"当前 key",它由 Task 线程在处理每条数据前设置,不按线程隔离(HeapValueState.java:82-90 → StateTable.java:168-169 的 keyContext.getCurrentKey())。所以在自己开的线程里调用 state.update() 不会报错,但写到哪个 key 上,取决于那一刻 Task 线程正在处理哪个 key。thread 模式看起来一切正常,是因为 Task 线程在 join() 里等着,当前 key 没变;thread-async 不等之后,自己的线程去写时,Task 线程早已换到了别的 key,999 就写到了 key 0 上,而且没有任何报错。
怎么解决
- 不要在
processElement、onTimer等回调里做同步的慢调用。需要调用外部服务时,可以考虑 Async I/O:它的结果会通过 Mailbox 交回 Task 线程处理(AsyncWaitOperator.java:620-650,flink-streaming-java模块)。本文没有实测 Async I/O,也没有讨论它和 keyed state 的配合,它适合"调用外部服务"这类场景,并不能解决所有问题。 - 不要在自己开的线程里读写 keyed state。不报错恰恰是最危险的地方,问题不会在测试时自己暴露出来。
几点注意:
- 写到 key 0 是本例的结果,换个时序、换个状态后端可能写到别的 key 上;本文只测了 HashMap 状态后端;
- 本例的 Checkpoint 超时是默认值(10 分钟),sleep 5 秒只是让它变慢,并没有超时;
- 单线程指的是每个 Task 一个线程,一个作业有很多 Task 并行运行,不等于整个作业只有一个线程。
记住这几点
- 同一个 Task 的数据处理、定时器、Checkpoint 在一个线程里排队,一个回调阻塞,其他都得等。
- keyed state 的"当前 key"不按线程隔离,跨线程写状态不报错,但会写错 key。
- 回调里别阻塞,别跨线程碰状态;调用外部服务可以看看 Async I/O。