
S2 第 8 讲:Lookup Changelog——-U/+U 是怎么算出来的
Apache Paimon 源码学习
作者 X老师(DaemonforY),Paimon 2.0 / master 源码,按 CC BY-NC-SA 4.0 发布。配套实验和代码在 GitHub。
TL;DR:第一季第五讲(下)讲过,下游按某个值做聚合时,需要
-U告诉它旧值是什么,才能把旧值撤回。Paimon 主键表默认(changelog-producer = none)不存这种变更,流读时 Flink 要加一个ChangelogNormalize算子,用状态记住每个 key 的最新值,自己补出-U。lookup把这件事挪到了写入时:每次提交前,把新写的 L0 文件强制合并到更高层;合并时对每个 key 去高层查(lookup)旧值当 before,合并结果当 after,比较二者写出 changelog 文件。实验里第二次写入 2 行,产出了 4 条 changelog——值没变的那一行也发了一对-U/+U,除非打开changelog-producer.row-deduplicate。
实验:四张表,同样三步
labs/sql/lab10/lookup-changelog.sql 建四张 bucket = 1 的主键表,做同样的写入:
① INSERT (1,'a') (2,'b') (3,'c')
② INSERT (1,'A') (2,'b')        -- key 1 改了值,key 2 写入的值和原来一样
③ DELETE FROM … WHERE k = 3| 表 | 选项 |
|---|---|
cl_none | 默认(changelog-producer = none) |
cl_lookup | changelog-producer = lookup |
cl_dedup | lookup + changelog-producer.row-deduplicate = true(只做 ① ②) |
cl_agg | lookup + merge-engine = aggregation,total 求和(写 (1,10) (2,20),再写 (1,5)) |
每一步之后看 $snapshots、$files,再用 $audit_log 加 incremental-between 读出某两个快照之间的变更(rowkind 一列就是 +I/-U/+U/-D)。
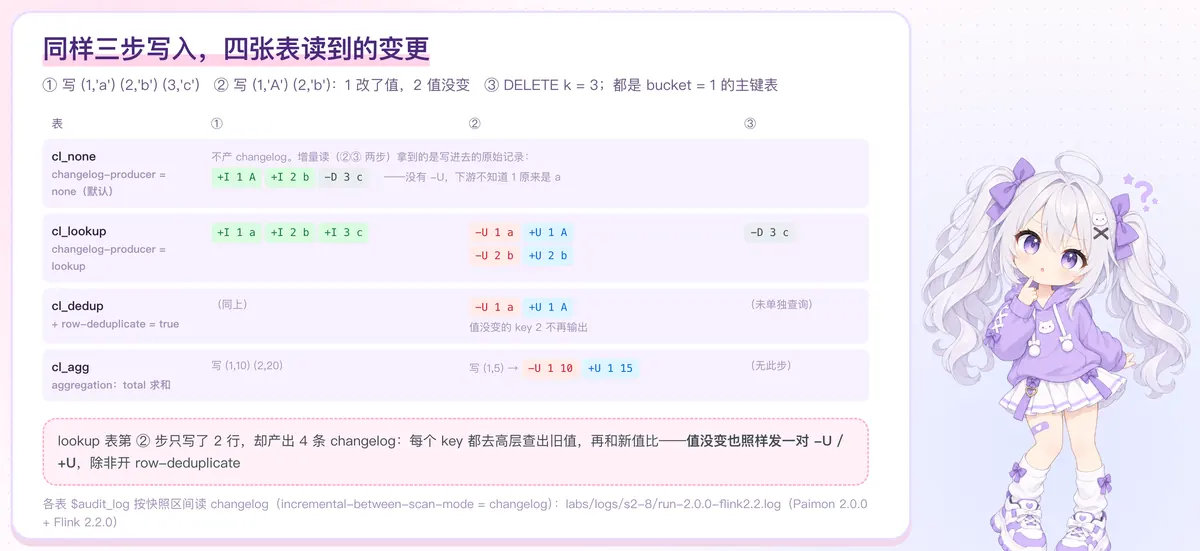
默认表 cl_none 读第 ② ③ 步的增量,拿到的是写进去的原始记录(节选自 run-2.0.0-flink2.2.log):
Flink SQL> SELECT * FROM `cl_none$audit_log` /*+ OPTIONS('incremental-between' = '1,3') */;
|                             +I |           1 |                              A |
|                             +I |           2 |                              b |
|                             -D |           3 |                              c |
3 rows in set
没有 -U:下游不知道 key 1 原来是 a。cl_lookup 第 ② 步只写了 2 行,读出来的是:
Flink SQL> SELECT * FROM `cl_lookup$audit_log` /*+ OPTIONS('incremental-between' = '2,4', 'incremental-between-scan-mode' = 'changelog') */;
|                             -U |           1 |                              a |
|                             +U |           1 |                              A |
|                             -U |           2 |                              b |
|                             +U |           2 |                              b |
4 rows in set
a 从哪来?第 ② 步写进去的数据里根本没有 a。下面分三个问题拆:什么时候算、每个 key 怎么算、算完写到哪。
一、什么时候算:每次提交前,把 L0 强制推上去
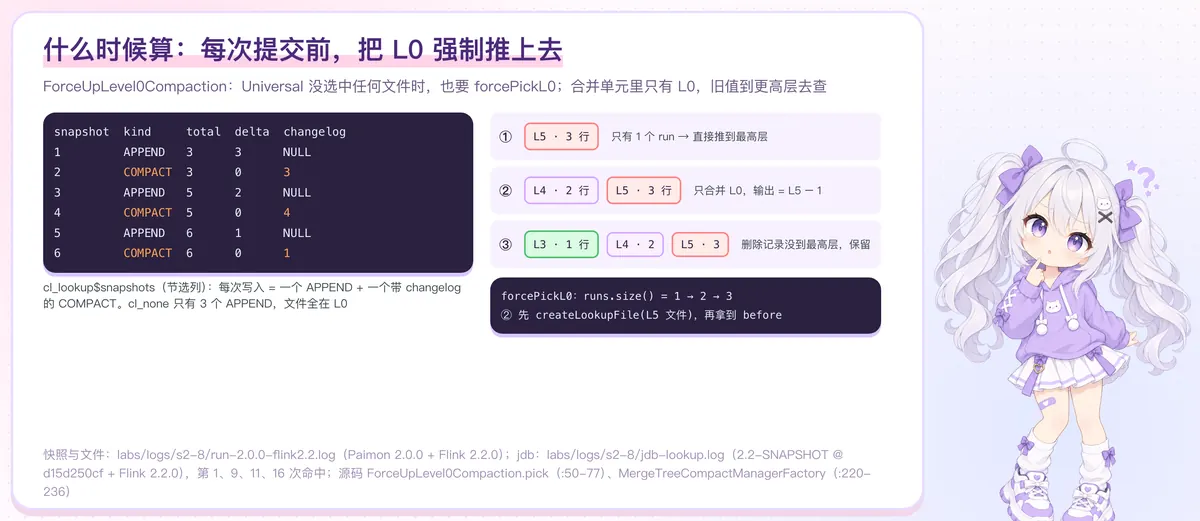
先看 cl_lookup$snapshots(节选自 run-2.0.0-flink2.2.log,最后一次查询):
|          snapshot_id |                    commit_kind |   total_record_count |   delta_record_count | changelog_record_count |
|                    1 |                         APPEND |                    3 |                    3 |                 <NULL> |
|                    2 |                        COMPACT |                    3 |                    0 |                      3 |
|                    3 |                         APPEND |                    5 |                    2 |                 <NULL> |
|                    4 |                        COMPACT |                    5 |                    0 |                      4 |
|                    5 |                         APPEND |                    6 |                    1 |                 <NULL> |
|                    6 |                        COMPACT |                    6 |                    0 |                      1 |
每次写入都变成两个快照:一个 APPEND(新写的 L0 文件),一个 COMPACT,changelog 只挂在 COMPACT 快照上(3、4、1 条)。对照 cl_none:三次写入只有 3 个 APPEND 快照,changelog_record_count 都是 NULL,三个文件都还在 L0——3 个 sorted run 没到 UniversalCompaction 的触发条件(第 3 讲,默认 5 个),根本不合并。
cl_lookup 为什么每次都合并?开启 lookup 后,合并策略换成了 ForceUpLevel0Compaction(MergeTreeCompactManagerFactory.java 第 220~236 行):先按 Universal 的规则挑,挑不出来就 forcePickL0,把 L0 强制合并上去(ForceUpLevel0Compaction.pick,第 50~77 行)。jdb 在三次写入时各命中一次 forcePickL0,当时的 sorted run 数分别是 1、2、3。
三次合并之后的文件(cl_lookup$files):
| 步骤 | 文件 | 说明 |
|---|---|---|
| ① 后 | L5 · 3 行 | 只有一个 run,直接推到最高层 |
| ② 后 | L4 · 2 行、L5 · 3 行 | 只合并了 L0 这一个文件;输出层 = 下一个更老的 run(L5)减 1(第 3 讲) |
| ③ 后 | L3 · 1 行、L4 · 2 行、L5 · 3 行 | L3 里是 key 3 的删除记录:没到最高层,不能丢 |
注意第 ② 步:这次合并的输入只有新写的 L0 文件,L5 并不参与。那 key 1 的旧值 a 只能到 L5 里去查——这就是 “lookup” 的意思。
流作业里还有一个开关
lookup-wait(默认 true,CoreOptions第 2284~2289 行):Flink sink 把“需要 lookup 且 lookup-wait”作为每次prepareCommit的waitCompaction(StoreSinkWrite.java:146、CoreOptions.prepareCommitWaitCompaction第 4616~4622 行),checkpoint 会等这次合并做完,数据文件和 changelog 文件进同一次提交。本讲的实验是批作业,批作业结束时本来就会等合并(PrepareCommitOperator.java:101-103),所以实验本身证明不了 lookup-wait 的作用,这一段是读源码得出的。
二、每个 key 怎么算:before 去高层查,after 是合并结果
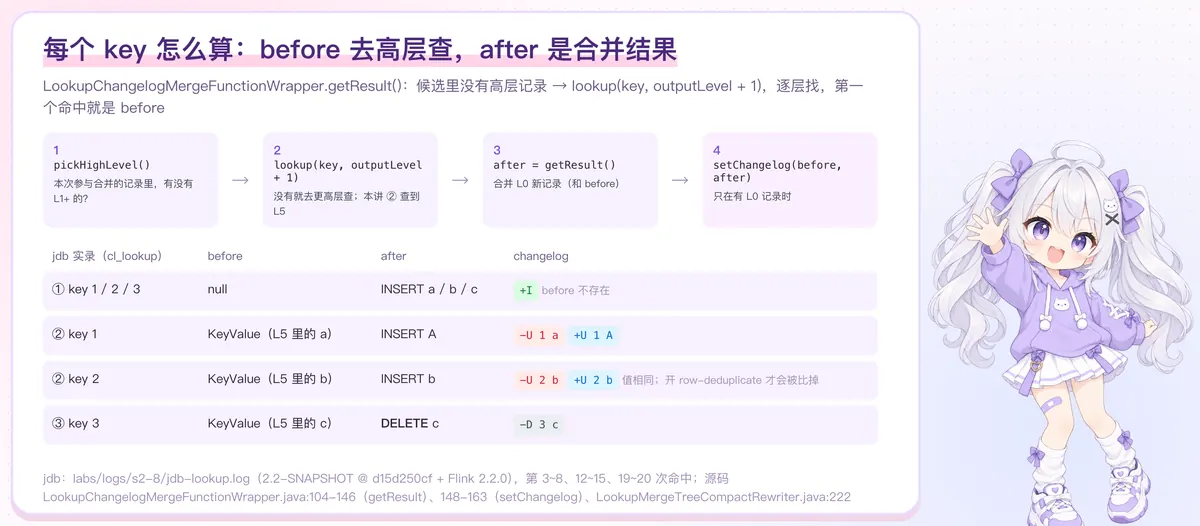
合并时同一个 key 的记录交给 LookupChangelogMergeFunctionWrapper,核心是 getResult()(第 104~146 行),节选:
// 1. 本次参与合并的记录里,挑出 level > 0 中最新的一条
KeyValue highLevel = mergeFunction.pickHighLevel();
boolean containLevel0 = mergeFunction.containLevel0();
// 2. 没有,就去更高层查
if (highLevel == null) {
    T lookupResult = lookup.apply(mergeFunction.key());   // = lookupLevels.lookup(key, outputLevel + 1)
    ...
}
// 3. 合并出新值
KeyValue result = mergeFunction.getResult();
// 4. 有 L0 记录参与时才产 changelog
if (containLevel0 && lookupStrategy.produceChangelog) {
    setChangelog(highLevel, result);
}
lookup 从 outputLevel + 1 开始(LookupMergeTreeCompactRewriter.java:222),逐层往下找,第一个命中就返回(LookupUtils.lookup,第 35~57 行)。为什么不用看更老的层?因为离开 L0 的数据都已经和当时查到的旧值合并过,L1 及以上每个 key 的记录都是完整的最新状态,最上面那条就是 before。
setChangelog(before, after)(第 148~163 行)的规则:
| before | after | changelog |
|---|---|---|
| 没有 / 是删除 | 新增 | +I |
| 有 | 删除 | -D |
| 有 | 新增,值不同 | -U + +U |
| 有 | 新增,值相同 | 默认仍是 -U + +U;开 row-deduplicate 后不输出 |
jdb 在 getResult 的第 137 行(after 算出来之前)和 setChangelog 入口各下一个断点,cl_lookup 三步的打印(节选自 jdb-lookup.log,KeyValue@… 是对象地址,表示 before 存在):
#3   getResult   key = 1   highLevel = null              containLevel0 = true
#4   setChangelog          before = null                 after = INSERT "a"      → +I
#11  LookupLevels.createLookupFile   data-ec659df9…  level = 5
#12  getResult   key = 1   highLevel = KeyValue@52b55058 containLevel0 = true
#13  setChangelog          before = KeyValue@52b55058    after = INSERT "A"      → -U / +U
#14  getResult   key = 2   highLevel = KeyValue@4ee3f48c containLevel0 = true
#15  setChangelog          before = KeyValue@4ee3f48c    after = INSERT "b"      → -U / +U
#19  getResult   key = 3   highLevel = KeyValue@654ca2a1 containLevel0 = true
#20 setChangelog before = KeyValue@654ca2a1 after = DELETE "c" → -D(为便于阅读,整理成每行一次命中,省略线程名;→ 后面是按上表规则对应的 changelog,和 $audit_log 读出的结果一致。)
第 ② 步的第 11 次命中很说明问题:在拿到 key 1 的 before 之前,先为 L5 的数据文件在本地建了一个 lookup 文件(LookupLevels.java:206)。lookup 不是每次去扫 Parquet,而是把高层数据文件转换成本地的 KV 文件(createLookupFile,第 308 行起)再点查,并缓存起来;第 ③ 步(第 18 次命中)又为同一个 L5 文件建了一次——这个实验里每条 INSERT/DELETE 都是一个独立的批作业,缓存跟着作业走。流作业里同一个写入算子会复用它(读源码得出,未单独实验)。
反直觉的一点:key 2 第 ② 步写入的 b 和原来的 b 一模一样,也发了一对 -U b +U b。只有 changelog-producer.row-deduplicate = true(默认 false,CoreOptions 第 1132~1136 行)时,才会创建 valueEqualiser 比较前后值(KeyValueFileStore.java:85-89)。cl_dedup 第 ② 步读出来只剩两条:
Flink SQL> SELECT * FROM `cl_dedup$audit_log` /*+ OPTIONS('incremental-between' = '2,4', 'incremental-between-scan-mode' = 'changelog') */;
|                             -U |           1 |                              a |
|                             +U |           1 |                              A |
2 rows in set
上游经常重复写同样的数据(比如 CDC 全量 + 增量重放)时,这个开关能省下大量无意义的变更。
三、算完写到哪:changelog 文件 + 三种升级策略
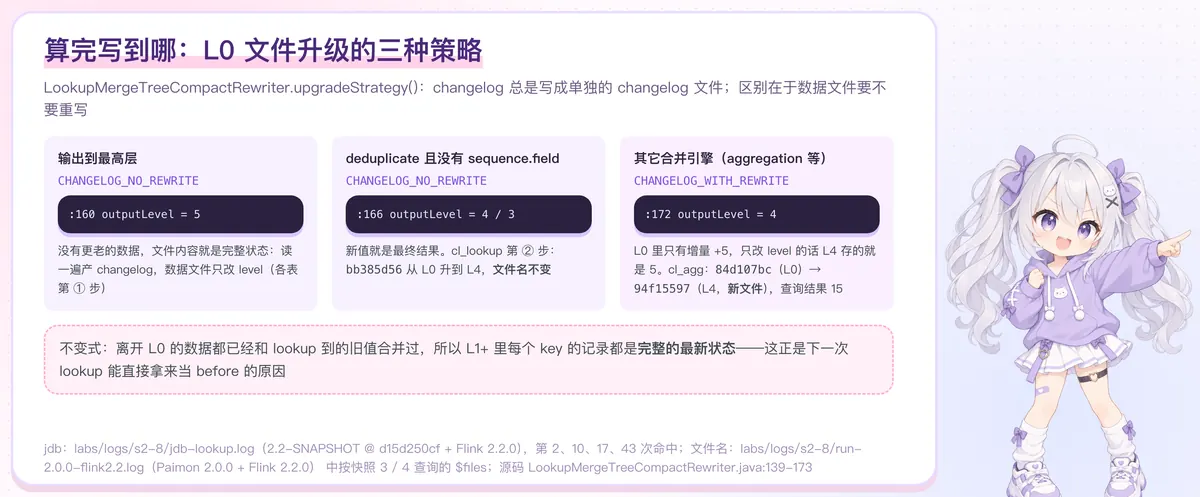
changelog 总是写成单独的 changelog-* 文件(ChangelogMergeTreeRewriter.rewriteOrProduceChangelog,第 125~210 行),cl_lookup 的 bucket 目录下三步后有 3 个 changelog 文件。不同的是数据文件要不要重写。L0 文件“升级”(只有它自己、不和别的文件重叠)时,LookupMergeTreeCompactRewriter.upgradeStrategy()(第 139~173 行)有三种结果,jdb 全部命中过:
| 情况 | 策略 | jdb | 实验证据 |
|---|---|---|---|
| 输出到最高层 | CHANGELOG_NO_REWRITE(第 160 行) | 各表第 ① 步,outputLevel = 5 | 没有更老的数据,文件内容就是完整状态 |
去重引擎、没有 sequence.field | CHANGELOG_NO_REWRITE(第 166 行) | cl_lookup ② ③,outputLevel = 4、3 | 第 ② 步的 L0 文件 bb385d56 升到 L4,文件名不变 |
| 其它引擎(aggregation 等) | CHANGELOG_WITH_REWRITE(第 172 行) | cl_agg ②,outputLevel = 4 | L0 文件 84d107bc → L4 文件 94f15597,换了新文件 |
“NO_REWRITE” 的意思是:读一遍这个文件算出 changelog,但数据文件不重写,只把它的 level 改掉。去重引擎可以这样做,因为新值就是最终结果;聚合引擎不行——cl_agg 第 ② 步的 L0 里只有增量 (1, 5),如果原样升到 L4,L4 存的就是 5,破坏了“L1+ 是完整状态”的不变式。所以它必须把合并后的 (1, 15) 写成新文件,查询结果是 15,changelog 是 -U 1 10 +U 1 15。
(文件名来自 run-2.0.0-flink2.2.log 中按快照 3、快照 4 查询的 $files;jdb 那次运行的文件名不同,见 jdb-lookup.log 第 2、10、17、43 次命中。)
四、和 none / input / full-compaction 怎么选
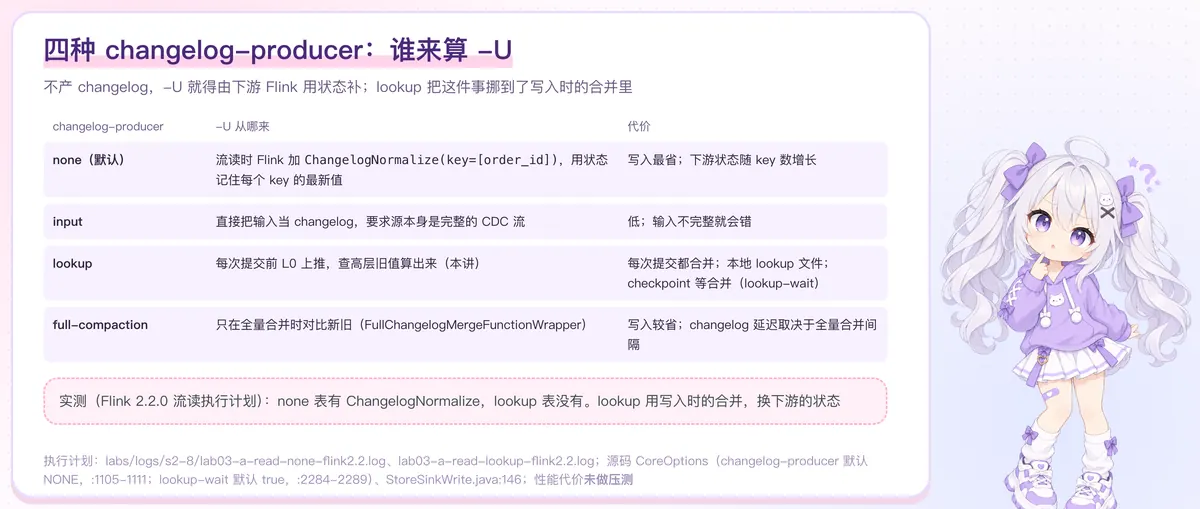
| changelog-producer | -U 从哪来 | 代价 |
|---|---|---|
none(默认,CoreOptions 第 1105~1111 行) | 流读时 Flink 加 ChangelogNormalize,用状态记住每个 key 的最新值 | 写入最省;下游状态随 key 数增长 |
| input | 直接把输入当 changelog,要求源本身是完整的 CDC 流 | 低;输入不完整就会错 |
| lookup | 本讲 | 每次提交都合并;本地 lookup 文件;checkpoint 等合并 |
| full-compaction | 只在全量合并时对比新旧(FullChangelogMergeFunctionWrapper) | 写入较省;changelog 延迟取决于全量合并间隔 |
在 Flink 2.2.0 上流读同样的数据(实验 3,run-all 日志),两种表的执行计划差一个算子:
none 表:  ChangelogNormalize(key=[order_id])
           +- Exchange(distribution=[hash[order_id]])
              +- TableSourceScan(table=[[paimon, default, orders_none]], …)
lookup 表:没有 ChangelogNormalize,直接 TableSourceScan(table=[[paimon, default, orders_lookup]], …)
(节选自 lab03-a-read-none-flink2.2.log / lab03-a-read-lookup-flink2.2.log。)这就是 lookup 的取舍:用写入时的合并和 lookup,换掉下游每个流作业里的 ChangelogNormalize 状态。读的作业越多、key 越多,越划算。还没做性能压测,具体代价要在自己的数据量上测。
小结
- 时机:L0 上推的那一刻。lookup 模式下合并策略是
ForceUpLevel0Compaction,每次提交前都把 L0 推上去,流作业的 checkpoint 会等它(lookup-wait)。 - 算法:before = 高层 lookup 到的旧值(不变式保证它是完整状态),after = 合并结果,按表格出
+I / -U+U / -D。 - 输出:changelog 写成单独文件、挂在 COMPACT 快照上;去重引擎升级只改 level,其它引擎要重写。
- 值没变也发
-U/+U,需要时开row-deduplicate。
下一讲:Flink 写入的两阶段提交——这些 changelog 文件和数据文件,是怎么借 checkpoint 做到 exactly-once 地提交进同一个快照的?(回扣第一季第八讲下篇 Sink V2。)
自测题:cl_lookup 如果第 ④ 步再写一次 (1, 'A'),会读到什么 changelog?这次 lookup 会在哪一层命中?(答案:before 是 L4 里的 (1, A)——lookup 从 outputLevel + 1 开始逐层找,L4 在 L5 之前;值相同,默认仍发 -U 1 A +U 1 A。具体输出层取决于当时的 sorted run,未单独运行,可用同一断点清单验证。)