
S1 第 4 期:删除一行数据,Paimon 为什么反而多了一个文件?
Apache Paimon 源码学习
作者 X老师(DaemonforY),Paimon 2.0 / master 源码,按 CC BY-NC-SA 4.0 发布。配套实验和代码在 GitHub。
TL;DR:在 Paimon 主键表里执行 DELETE,不会修改或删除任何已有文件,而是新写一个只含“删除标记(-D)”的小文件。读取时按主键取最新版本,最新的是删除标记,这一行就不输出;合并时删除标记和旧数据一起被丢弃;旧文件要等快照过期后才从磁盘上删除。
实验准备
主键表 orders,主键 (dt, order_id),每个分区 2 个桶。依次执行:
- 插入订单 1~5
- 把订单 1 改为 PAID,新增订单 6
- 删除订单 3
- 手动全量合并
完整 SQL 在仓库
labs/sql/lab01/,一条命令复现:cd labs && ./run.sh sql/lab01/step1-create-insert.sql
现象:删了一行,文件多了一个
DELETE FROM orders WHERE dt = '2026-09-24' AND order_id = 3;执行前后分别列出表里的数据文件:
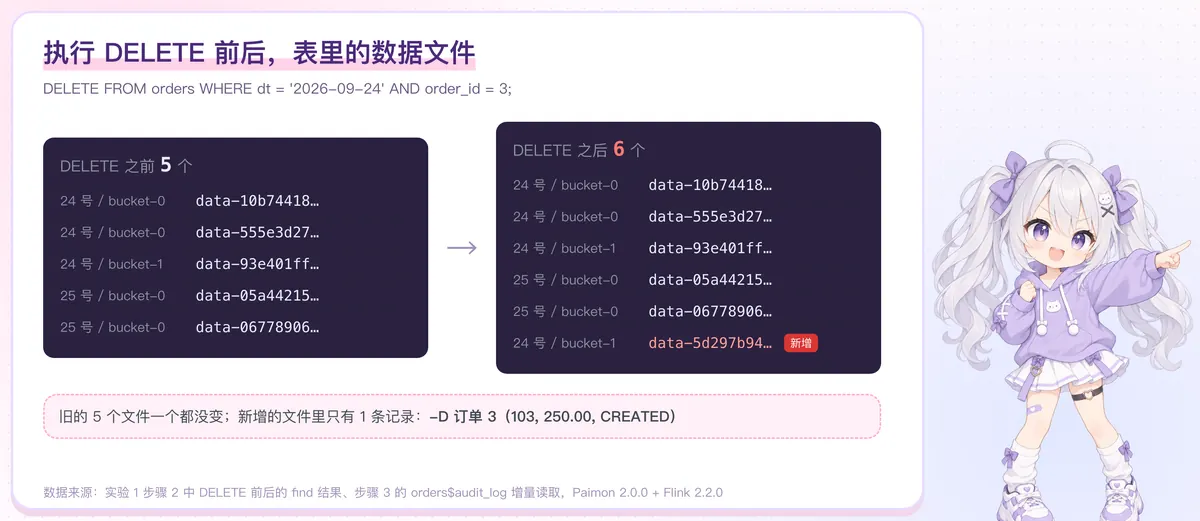
- DELETE 之前 5 个,之后 6 个。
- 原来的 5 个文件一个都没变(文件名完全相同)。
- 新增的
bucket-1/data-5d297b94…里只有 1 条记录。
这条记录是什么?用增量读取看一下这次提交写了什么:
SELECT * FROM `orders$audit_log` /*+ OPTIONS('incremental-between' = '2,3') */;+--------------------------------+----------------------+----------------------+--------------+--------------------------------+--------------------------------+
| rowkind | order_id | user_id | amount | status | dt |
+--------------------------------+----------------------+----------------------+--------------+--------------------------------+--------------------------------+
| -D | 3 | 103 | 250.00 | CREATED | 2026-09-24 |
+--------------------------------+----------------------+----------------------+--------------+--------------------------------+--------------------------------+
1 row in set一条 RowKind 为 -D(删除)的记录,而且带着订单 3 完整的旧值——Flink 执行 DELETE 时会先按条件读出命中的行(日志里能看到 Filtering using predicate: eq(order_id, 3)),再把它们以 -D 写回。
为什么不直接改文件?LSM 只追加
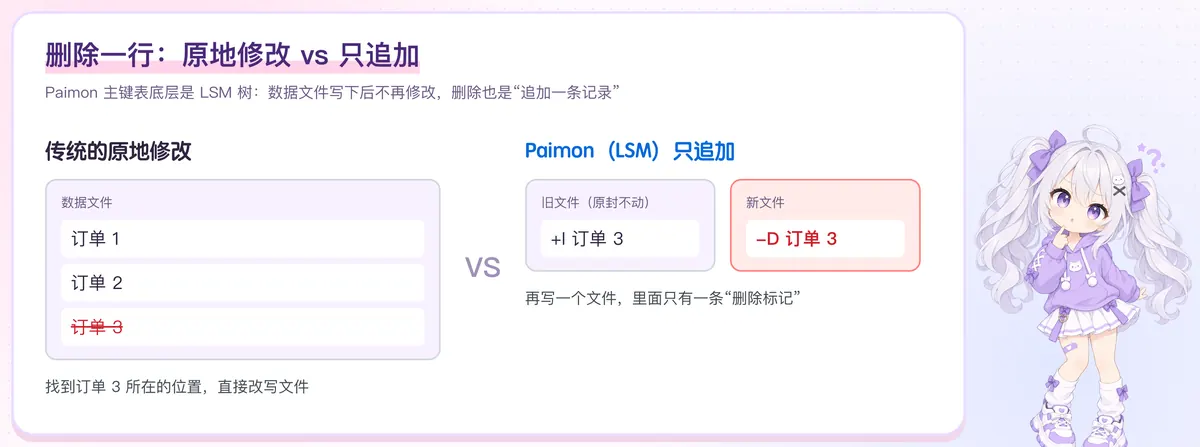
Paimon 主键表底层是 LSM 树(Log-Structured Merge-Tree)。核心原则就一条:数据文件写下之后不再修改。
- 更新 = 追加一条新版本;
- 删除 = 追加一条删除标记。
打个比方:先在草稿本上一条条追加记录,攒多了再誊写到正式账本上。
这样做的好处:
- 写得快:只需要顺序写新文件,不用先找到旧数据再改写;
- 文件不可变:多个作业并发读写不会互相踩,提交只需要原子地加入新文件;
- 能查历史:旧文件还在,读旧快照就能看到删除之前的数据(时间旅行)。
那读的时候怎么办?按主键取最新版本
查快照系统表会发现一个“矛盾”(节选:step3-system-tables.log 中 orders$snapshots 的前 5 列,省略 base/delta_manifest_list 两列):
+----------------------+--------------------------------+----------------------+----------------------+----------------------+
|          snapshot_id |                    commit_kind |    commit_identifier |   total_record_count |   delta_record_count |
+----------------------+--------------------------------+----------------------+----------------------+----------------------+
|                    1 |                         APPEND |  9223372036854775807 |                    5 |                    5 |
|                    2 |                         APPEND |  9223372036854775807 |                    7 |                    2 |
|                    3 |                         APPEND |  9223372036854775807 |                    8 |                    1 |
+----------------------+--------------------------------+----------------------+----------------------+----------------------+
物理上有 8 条记录,但 SELECT * 只返回 5 行。
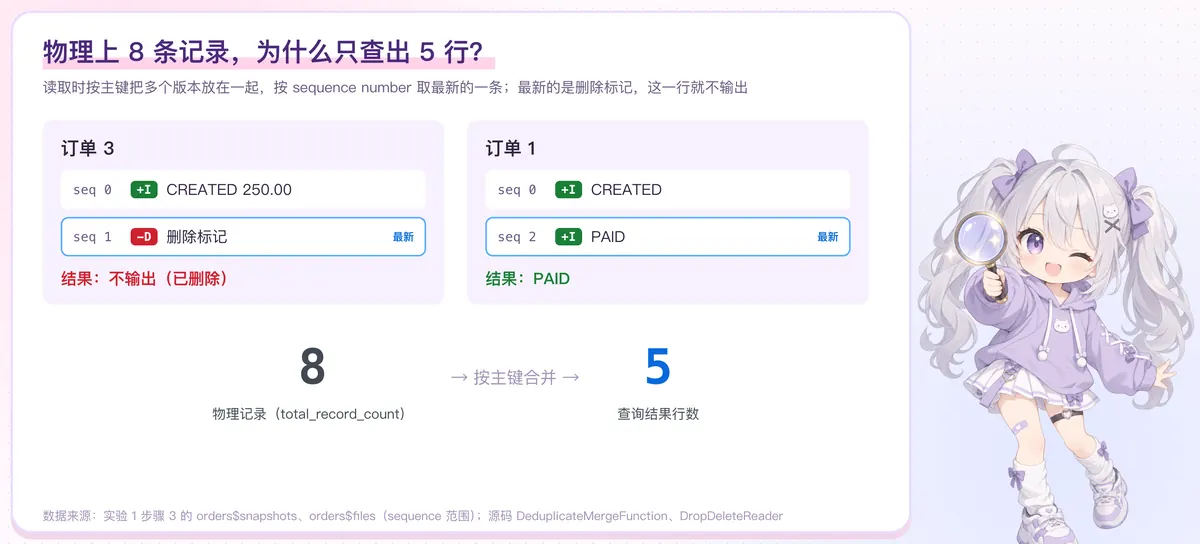
读取时,Paimon 把同一主键的多个版本放在一起,按 sequence number(写入顺序号)取最新的一条:
- 订单 3:seq 0 是插入,seq 1 是删除标记 → 最新的是删除 → 不输出;
- 订单 1:seq 0 是 CREATED,seq 2 是 PAID → 输出 PAID。
源码里,DeduplicateMergeFunction 每来一条就用它覆盖上一条(第 54 行 latestKv = kv),最后留下的就是最新版本;MergeFileSplitRead 在读取结果外面套了一层 DropDeleteReader(第 487 行),把最终结果是删除的行过滤掉。
orders$files 也印证了这一点:订单 3 所在的 bucket-1 有两个文件,sequence 分别是 0 和 1。
删除什么时候真正生效?合并的时候
CALL sys.compact(`table` => 'default.orders');日志里的三个合并任务(节选:step4-compact.log 中 3 行 “Paimon compact task finished”,按日志原顺序):
20:55:27.864 INFO  [CompactTask] Paimon compact task finished: partition=dt=2026-09-24/, bucket=0, taskType=MergeTreeCompactTask, inputFiles=2, inputBytes=3783, outputFiles=1, outputBytes=1919, durationMs=312
20:55:27.872 INFO  [CompactTask] Paimon compact task finished: partition=dt=2026-09-25/, bucket=0, taskType=MergeTreeCompactTask, inputFiles=2, inputBytes=3806, outputFiles=1, outputBytes=2000, durationMs=8
20:55:27.876 INFO  [CompactTask] Paimon compact task finished: partition=dt=2026-09-24/, bucket=1, taskType=MergeTreeCompactTask, inputFiles=2, inputBytes=3653, outputFiles=0, outputBytes=0, durationMs=4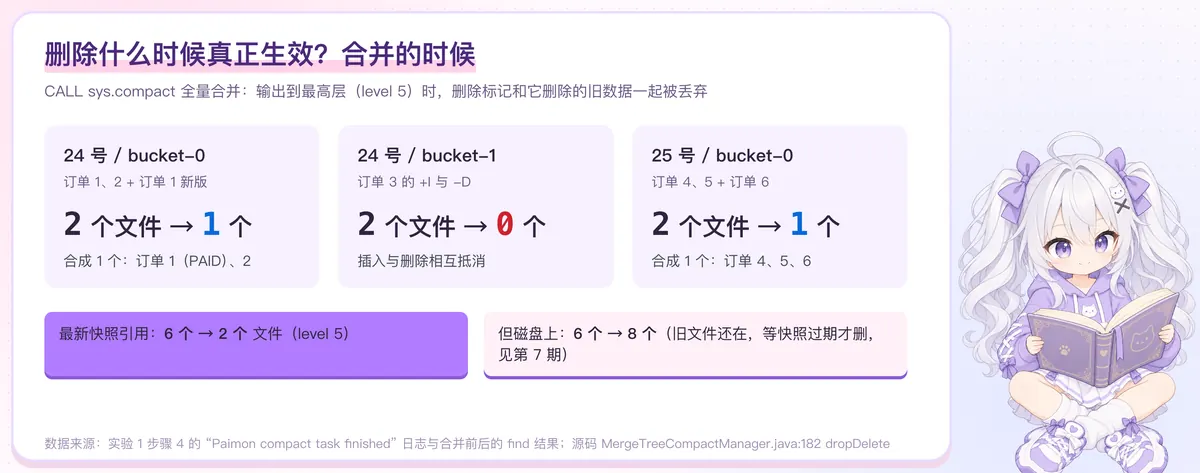
注意 24 号 bucket-1:2 个文件合并成了 0 个——订单 3 的插入和删除相互抵消,什么都不剩。
原因在 MergeTreeCompactManager 第 182 行:合并输出到最高层(这里是 level 5,且没有比它更老的数据)时,dropDelete = true,删除记录直接丢弃。如果输出到中间层,下面可能还压着更老的数据,删除标记就得保留,否则旧数据会“复活”。
合并后有一个 COMPACT 快照,物理记录数从 8 降到 5(delta_record_count = -3),最新快照只引用 2 个 level 5 的文件。
但是,磁盘并没有变小
再列一次磁盘上的数据文件:8 个——合并生成的 2 个新文件,加上原来的 6 个旧文件,一个没少。
旧文件还被快照 1、2、3 引用着(想读历史就得留着它们),要等这些快照过期之后才会被物理删除。这是下一期(第 7 期)的内容。
一条删除的完整生命周期
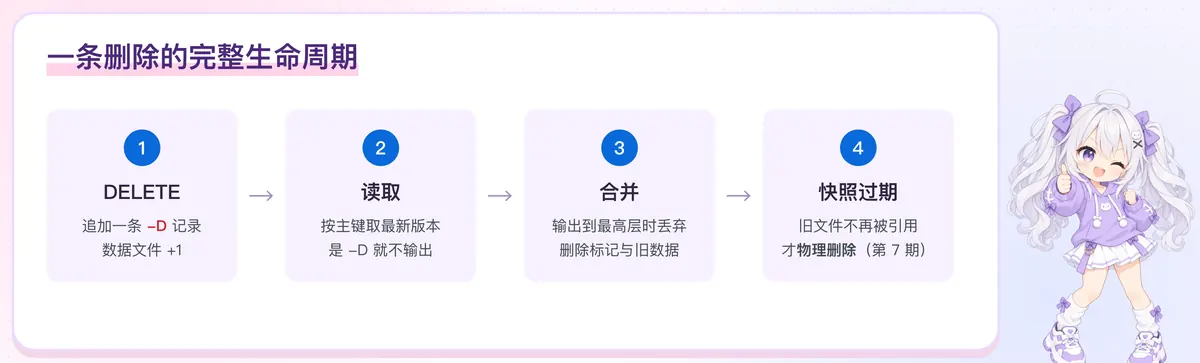
| 阶段 | 发生了什么 | 实验中的证据 |
|---|---|---|
| DELETE | 追加一条 -D 记录,数据文件 +1 | 文件 5 → 6 |
| 读取 | 按主键取最新版本,是 -D 就不输出 | 物理 8 条,查询 5 行 |
| 合并 | 输出到最高层时丢弃删除标记和旧数据 | bucket-1:2 个文件 → 0 个 |
| 快照过期 | 旧文件不再被任何快照引用,才物理删除 | 合并后磁盘仍有 8 个文件 |
生产启示
- 频繁更新/删除会产生大量小文件:每次提交都可能新增文件,需要合并来收敛。合并策略的细节见源码教程第 03、04 章。
- 想释放空间要两步:合并(让最新快照不再引用旧文件)+ 快照过期(让旧文件可以被删除)。
- 删除记录不是“立即消失”:在合并之前,流式读取的下游能看到这条 -D,这正是 CDC 场景需要的。
下期预告:快照删了,文件为什么还在?——快照过期的三道保险和文件的删除规则。
自测题:如果合并只输出到 level 1,而 level 5 里还有订单 3 更老的数据,删除标记能不能丢弃?为什么?(答案:不能。丢掉之后,读取时 level 5 里的旧数据就成了订单 3 的最新版本,已删除的数据会“复活”。这正是 dropDelete 要求输出层 ≥ 当前最高非空层的原因。)