
Flink 2.x 源码精读(七·上):Watermark 从哪来、到哪去
Apache Flink 源码学习
作者 X老师(DaemonforY),Flink 2.3.0 源码,按 CC BY-NC-SA 4.0 发布。
本系列基于 Apache Flink 2.3.0,文中
文件:行号都在release-2.3.0上核对过,运行结果来自本机实测(Apple M5 Pro,JDK 17)。 路径缩写:CORE=flink-core/src/main/java/org/apache/flink,RT=flink-runtime/src/main/java/org/apache/flink(注意:本篇的RT比前几讲少一层/runtime,因为streaming包也在这个模块下) 前置阅读:第一讲下篇(Mailbox)、第四讲(网络栈);踩坑实验室 #01(空闲分区)、#03(差 1 毫秒)
先看一个实验。
一个 Source,并行度 1,同一个 reader 交替读两个 split(可以理解为一个 subtask 同时读 Kafka 的两个分区):
- split
fast:事件时间从 10 秒开始,每条增加 50 毫秒; - split
slow:事件时间比fast落后 5 秒,从 5 秒开始。
每个 split 200 条,一共 400 条。下游是 1 秒的滚动窗口,迟到的数据走侧输出。Watermark 策略都是 forBoundedOutOfOrderness(Duration.ofSeconds(1))。
两种写法只有一处不同:
// 写法一:策略写在 fromSource 里
env.fromSource(source, strategy, "two-splits")

// 写法二:fromSource 不设 Watermark,之后再分配
env.fromSource(source, WatermarkStrategy.noWatermarks(), "two-splits")
   .assignTimestampsAndWatermarks(strategy)
本机实测(连续跑了 3 次,结果完全相同):
>>> mode=split: windows fired=15, records in windows=400, late records=0 (from slow split: 0), total=400
>>> mode=operator: windows fired=11, records in windows=203, late records=197 (from slow split: 197), total=400
写法一:400 条全部进了窗口。写法二:197 条被判为迟到,全部来自落后的那个 split。 将近一半的数据,因为 Watermark 写的位置不同,没有算进结果。
这一篇,我们来看:
- Watermark 是谁、在什么时候生成的?
- 两种写法的区别在哪?Split 级别的 Watermark 是怎么合并的?
- Watermark 怎么从上游传到下游?多个上游怎么合并?
- Watermark 到了算子之后,怎么驱动 Timer?
窗口本身(分配、触发、迟到数据的处理)放在下篇。
一、Watermark 的含义与生成
1.1 一句话含义
Watermark W 的含义是:时间戳 ≤ W 的数据,不会再来了。 下游的窗口、Timer 都按这个承诺来决定"什么时候可以出结果"。
承诺给早了,后面再来的数据就成了迟到数据;承诺给晚了,结果出得慢。开头实验的写法二,就是承诺给早了。
1.2 两个接口,一个策略
用户只接触 WatermarkStrategy(CORE/api/common/eventtime/WatermarkStrategy.java),它是一个工厂,负责创建两样东西:
| 组件 | 职责 | 什么时候调用 |
|---|---|---|
TimestampAssigner | 从记录里取出事件时间 | 每条记录 |
WatermarkGenerator | 决定 Watermark 的值 | onEvent():每条记录(WatermarkGenerator.java:38);onPeriodicEmit():周期性调用(:46) |
最常用的 forBoundedOutOfOrderness(d)(WatermarkStrategy.java:234)用的是 BoundedOutOfOrdernessWatermarks(CORE/api/common/eventtime/BoundedOutOfOrdernessWatermarks.java):
public void onEvent(T event, long eventTimestamp, WatermarkOutput output) {
    maxTimestamp = Math.max(maxTimestamp, eventTimestamp);                          // :64 只记最大值,不发
}

public void onPeriodicEmit(WatermarkOutput output) {
    output.emitWatermark(new Watermark(maxTimestamp - outOfOrdernessMillis - 1));   // :69
}
三个要点:
- Watermark = 见过的最大时间戳 − 乱序容忍 − 1。为什么要减 1,踩坑实验室 #03 专门讲过。
onEvent不发 Watermark,只有周期调用才发,周期由pipeline.auto-watermark-interval控制,默认 200ms(CORE/configuration/PipelineOptions.java:92)。- 只有变大的 Watermark 才会真正发出:
WatermarkToDataOutput.emitWatermark()会过滤掉不增长的值(RT/streaming/api/operators/source/WatermarkToDataOutput.java:75-79)。
关键在于"见过的最大时间戳"——是谁见过的? 这就是两种写法的区别。
二、两条路径:Split 级别 vs Subtask 级别
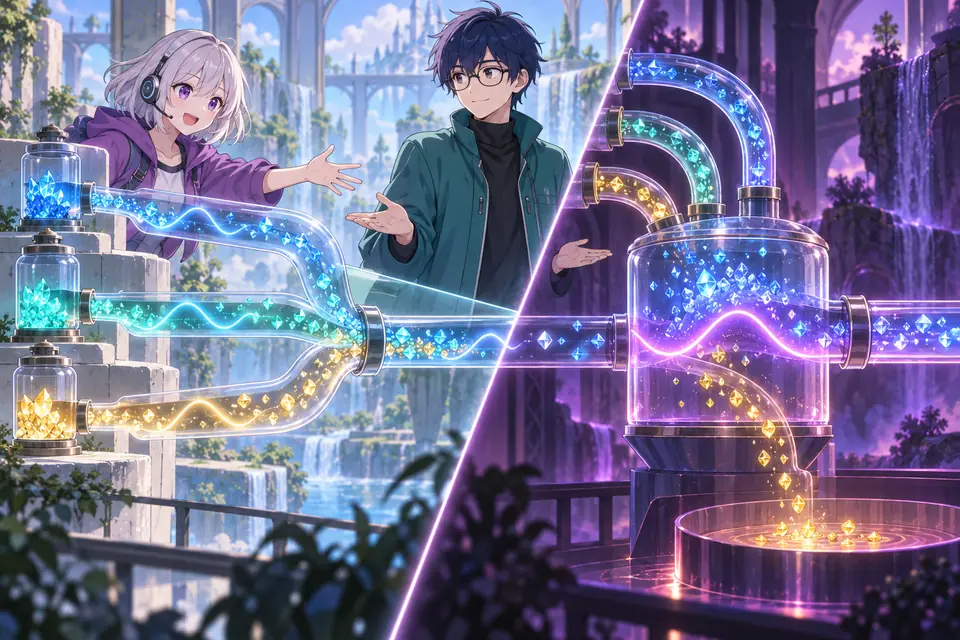
2.1 写法一:生成器在 Source 里,每个 split 一个
fromSource(source, strategy, name) 把策略交给 SourceOperator。SourceOperator.open()(RT/streaming/api/operators/SourceOperator.java:417)里创建事件时间逻辑(:429),并启动周期性的 Watermark 发送(:461,最终是 ProgressiveTimestampsAndWatermarks.java:163 的 scheduleWithFixedDelay)。
关键在 reader 发数据的方式。Source 的 reader 可以调用 ReaderOutput.createOutputForSplit(splitId),为每个 split 拿一个单独的输出(CORE/api/connector/source/ReaderOutput.java:109)。这个方法的实现(RT/streaming/api/operators/source/ProgressiveTimestampsAndWatermarks.java:266-302):
SourceOutput<T> createOutputForSplit(String splitId) {
    ...
    watermarkMultiplexer.registerNewOutput(splitId, ...);                        // 在复用器里登记这个 split
    final WatermarkGenerator<T> watermarks =
            watermarksFactory.createWatermarkGenerator(...);                     // :290 每个 split 一个新的生成器
    final SourceOutputWithWatermarks<T> localOutput =
            SourceOutputWithWatermarks.createWithSeparateOutputs(..., watermarks);   // :294
    localOutputs.put(splitId, localOutput);
    return localOutput;
}
每个 split 有自己独立的 WatermarkGenerator,各自记各自的"最大时间戳"。
周期触发时(:323-333),先让每个 split 算出自己的候选值,再统一合并:
void emitPeriodicWatermark() {
    // The call in the loop only records the next watermark candidate for each local output.
    // The call to 'watermarkMultiplexer.onPeriodicEmit()' actually merges the watermarks.
    for (SourceOutputWithWatermarks<?> output : localOutputs.values()) {
        output.emitPeriodicWatermark();
    }
    watermarkMultiplexer.onPeriodicEmit();                                        // :332
}
合并规则在 CombinedWatermarkStatus.updateCombinedWatermark()(CORE/api/common/eventtime/CombinedWatermarkStatus.java:65):取所有活跃 split 的最小值(:72-79);如果所有 split 都空闲了,才取最大值(:94)。
对应到实验:
- split
fast的 Watermark ≈ fast 的最大时间戳 − 1s − 1ms - split
slow的 Watermark ≈ slow 的最大时间戳 − 1s − 1ms,比 fast 小 5 秒 - 合并后取最小值 = slow 的 Watermark
整个 Source 发出的 Watermark 跟着慢的那个 split 走,slow 的数据不会被判为迟到;fast 的数据本来就比 Watermark 大,自然也不会迟到。所以 0 条迟到。
2.2 写法二:生成器在下游算子里,整个 subtask 一个
assignTimestampsAndWatermarks() 在流中间插入一个 TimestampsAndWatermarksOperator(RT/streaming/runtime/operators/TimestampsAndWatermarksOperator.java):
public void processElement(final StreamRecord<T> element) throws Exception {     // :133
    ...
    element.setTimestamp(newTimestamp);
    output.collect(element);
    watermarkGenerator.onEvent(event, newTimestamp, wmOutput);
}
这个算子收到的是 Source 已经合并好的一条流,它根本不知道数据来自哪个 split。整个 subtask 只有一个生成器,"最大时间戳"是两个 split 一起算的:
- 最大时间戳由 fast 决定;
- Watermark ≈ fast 的最大时间戳 − 1s − 1ms;
- slow 的数据比 fast 落后 5 秒,远小于 Watermark → 迟到。
那为什么是 197 条,不是 200 条?看写法二触发的窗口(本机实测,节选):
>>> FIRE window=5s,6s) count=3 watermark=9.149s
>>> FIRE window=[10s,11s) count=20 watermark=11.049s
>>> FIRE window=[11s,12s) count=20 watermark=12.049s
...
>>> FIRE window=[19s,20s) count=20 watermark=MAX
第一个窗口 [5s,6s) 只有 3 条,而且是在 Watermark 为 9.149s 时才触发的。9.149 + 1.001 = 10.150,说明第一次周期性 Watermark 发出时,fast 已经读到了 10.150s,而 slow 只进来了 5.000s、5.050s、5.100s 这 3 条。这 3 条赶在 Watermark 发出之前进了窗口,之后的 197 条 slow 数据全部被判为迟到。
watermark是窗口触发时的当前 Watermark,MAX表示输入结束。多次运行中,触发的窗口和条数完全相同,Watermark 的具体值会相差几十毫秒,取决于周期定时器落在哪一刻。完整输出在assets/logs/split-watermark-operator.log。
![Split 级别与 Subtask 级别的 Watermark
2.3 写法二还有一个副作用:吞掉上游的 Watermark
接着看 TimestampsAndWatermarksOperator:
public void processWatermark(org.apache.flink.streaming.api.watermark.Watermark mark) throws Exception {  // :157
    // if we receive a Long.MAX_VALUE watermark we forward it since it is used
    // to signal the end of input and to not block watermark progress downstream
    if (mark.getTimestamp() == Long.MAX_VALUE) {
        wmOutput.emitWatermark(Watermark.MAX_WATERMARK);
    }
}

/** Override the base implementation to completely ignore statuses propagated from upstream. */
@Override
public void processWatermarkStatus(WatermarkStatus watermarkStatus) throws Exception {}    // :168
上游的 Watermark 和空闲状态全部被丢弃,只转发表示"输入结束"的 MAX_WATERMARK。所以在已经有 Watermark 的流上再调一次 assignTimestampsAndWatermarks,是把 Watermark 整个换掉,不是叠加;上游 Source 里设置的 withIdleness 也一起失效了。
2.4 结论与代价
能在 fromSource 里设置 Watermark 策略,就不要用 assignTimestampsAndWatermarks。
不过这有一个前提:Source 的 reader 要为每个 split 调用 createOutputForSplit。连接器的公共基类 SourceReaderBase 默认就是这么做的(flink-connectors/flink-connector-base/src/main/java/org/apache/flink/connector/base/source/reader/SourceReaderBase.java:471),所以基于它实现的 Source 都能享受 Split 级别的 Watermark。
Kafka 连接器在独立的
flink-connector-kafka仓库中,本篇没有核对它的代码。
Split 级别的 Watermark 也有代价:整个 Source 的 Watermark 被最慢的 split 拖住。看写法一的输出(本机实测,节选,完整输出在 assets/logs/split-watermark-split.log):
>>> FIRE window=9s,10s) count=20 watermark=10.149s
>>> FIRE window=[10s,11s) count=40 watermark=10.999s
>>> FIRE window=[11s,12s) count=40 watermark=12.049s
[10s,11s) 里有 40 条:fast 的 20 条加上 slow 的 20 条。fast 的这 20 条在作业刚启动时就到了,但这个窗口要等 Watermark 到 10.999s 才触发,而这个 Watermark 是 slow 读到 11 秒左右才推上来的。按数据的节奏(事件时间大致和真实时间同步),fast 的数据要多等大约 5 秒才出结果。如果某个 split 落后得太多,快的 split 的数据会一直积压在下游的窗口状态里。这就是第六节"Watermark 对齐"要解决的问题。
三、空闲检测:为什么背压不算空闲
一个 split 长时间没有数据,它的 Watermark 就不再前进,按"取最小值"的规则,整个 Source 都会被它拖住。踩坑实验室 #01 复现过这种情况:一个 subtask 没有数据,窗口一个结果都不出。
withIdleness(d)(WatermarkStrategy.java:147)用 WatermarksWithIdleness 包一层(CORE/api/common/eventtime/WatermarksWithIdleness.java):
public void onPeriodicEmit(WatermarkOutput output) {             // :74
    if (idlenessTimer.checkIfIdle()) {
        if (!isIdleNow) { output.markIdle(); isIdleNow = true; } // 只发一次 IDLE
    } else {
        watermarks.onPeriodicEmit(output);
    }
}
被标记为空闲的 split,不再参与"取最小值"。
这里有一个细节:判断是否空闲用的时钟是 PausableRelativeClock。每个 split 的时钟在创建时,都注册成了背压监听器(ProgressiveTimestampsAndWatermarks.java:305-311):
// Dedicated inputActivityClock for a particular split. It will be paused both in case
// of back pressure and when split is paused due to watermark alignment.
PausableRelativeClock inputActivityClock = new PausableRelativeClock(clock);
...
taskIOMetricGroup.registerBackPressureListener(inputActivityClock);
Source 被下游背压、读不动数据时,空闲计时会暂停。否则一个"被下游堵住"的 split 会被误判为"没有数据",它的 Watermark 被排除之后,整体 Watermark 会突然前进,后面再来的数据就成了迟到数据。
四、传播:Watermark 也是一条"数据"
4.1 在网络中:和数据走同一条通道
RecordWriterOutput.emitWatermark()(RT/streaming/runtime/io/RecordWriterOutput.java:148)把 Watermark 包进序列化对象,调用 recordWriter.broadcastEmit(...)(:159),广播给所有下游通道。
它走的是和数据完全一样的序列化、缓冲区路径(第四讲),不是优先级事件。由此可以推出两点:
- 同一个通道里,Watermark 严格排在它前面的数据后面。 下游看到 Watermark 时,前面的数据一定已经处理完了。这是窗口结果正确的基础。
- 背压会推迟 Watermark。 第二讲下篇讲过,非对齐 Checkpoint 的 Barrier 可以越过缓冲区里的数据,Watermark 不行。背压严重时窗口"迟迟不出结果",原因往往在这里。
4.2 在输入端:StatusWatermarkValve 取最小值
下游 Task 收到 Watermark 后(RT/streaming/runtime/io/AbstractStreamTaskNetworkInput.java:216),交给 StatusWatermarkValve(RT/streaming/runtime/watermarkstatus/StatusWatermarkValve.java)。
它为每个输入通道记录当前的 Watermark 和状态(活跃 / 空闲),并把所有活跃且已对齐的通道放进一个小顶堆(alignedSubpartitionStatuses,:73):
private void findAndOutputNewMinWatermarkAcrossAlignedSubpartitions(DataOutput<?> output) {   // :273
    ...
    if (hasAlignedSubpartitions
            && alignedSubpartitionStatuses.peek().watermark > lastOutputWatermark) {       // :281 堆顶就是最小值
        lastOutputWatermark = alignedSubpartitionStatuses.peek().watermark;
        output.emitWatermark(new Watermark(lastOutputWatermark));
    }
}
和 Source 里合并 split 是一样的规则:多个上游,取最小值。
两个容易忽略的细节:
- "已对齐"的意思:这个通道的 Watermark 已经追上了当前的输出值。一个空闲通道恢复活跃后,只有它的 Watermark 不小于当前输出值,才会被放回堆里(
:259-261)。否则它会把输出的 Watermark 往回拉,而 Watermark 必须单调不减。 - 所有通道都空闲时:输出所有通道里的最大 Watermark(
findAndOutputMaxWatermarkAcrossAllSubpartitions,:325-338),再向下游发 IDLE。
5.1 顺序不能反
// RT/streaming/api/operators/AbstractStreamOperator.java
public void processWatermark(Watermark mark) throws Exception {       // :690
    ...
}
private void emitWatermarkDirectly(Watermark mark) throws Exception {
    if (timeServiceManager != null) {
        timeServiceManager.advanceWatermark(mark);                    // :700 先触发 Timer
    }
    output.emitWatermark(mark);                                       // :702 再往下游传
}
先触发 Timer,再转发 Watermark。 窗口在 Timer 里输出的结果,必须排在触发它的那个 Watermark 前面到达下游,否则下游会把这些结果当成迟到数据。
5.2 Timer 是怎么被触发的
InternalTimerServiceImpl(RT/streaming/api/operators/InternalTimerServiceImpl.java)为每个 Timer 服务维护两个按时间排序的队列:处理时间的(:54)和事件时间的(:58)。一个 Timer 由 (时间, key, namespace) 唯一确定,对窗口算子来说,namespace 就是窗口本身。
public void registerEventTimeTimer(N namespace, long time) {        // :249
    eventTimeTimersQueue.add(new TimerHeapInternalTimer<>(time, (K) keyContext.getCurrentKey(), namespace));
}

public boolean tryAdvanceWatermark(long time, ...) {                // :328
    currentWatermark = time;
    while ((timer = eventTimeTimersQueue.peek()) != null
            && timer.getTimestamp() <= time && ...) {
        keyContext.setCurrentKey(timer.getKey());                   // :338 切到这个 Timer 的 key
        eventTimeTimersQueue.poll();
        triggerTarget.onEventTime(timer);                           // :340 → WindowOperator.onEventTime / onTimer
        ...
    }
}
由此可以推出三个结论:
- 事件时间 Timer 只在 Watermark 到来时检查。 在
processElement里注册一个早于当前 Watermark 的 Timer,它不会立即触发,要等下一个 Watermark。如果之后再也没有新的 Watermark,它就永远不会触发。 - 同一个 (时间, key, 窗口) 只存一份。 堆实现在
HeapPriorityQueueSet.add()里先去重(RT/runtime/state/heap/HeapPriorityQueueSet.java:121)。所以窗口算子每来一条数据都注册一次同样的 Timer,也不会重复。 - Timer 回调里读到的是 Timer 自己的 key 的状态(
:338)。第三讲上篇说过,这是框架在 Timer 回调里设置当前 key 的地方。
六、Watermark 对齐:让跑得太快的 split 停一停
2.4 节说过,Split 级别的 Watermark 会被最慢的 split 拖住,快的 split 的数据会积压在下游。如果两个 split 的事件时间相差几个小时(比如一个在追历史数据),状态会越来越大。
withWatermarkAlignment(group, maxDrift)(WatermarkStrategy.java:168)的做法是:让跑得太快的 split 暂停读取。
SourceOperator(每个 subtask)                         SourceCoordinator(JobManager)
  上报自己的 Watermark ──ReportedWatermarkEvent──▶      汇总同一个 group 里所有 subtask 的 Watermark,取最小值
  (SourceOperator.java:647)                           (WatermarkAggregator,SourceCoordinator.java:835)
                                                        maxAllowedWatermark = 全局最小值 + maxDrift(:205-215)
  ◀──WatermarkAlignmentEvent──────────────────────     announceCombinedWatermark()(:184),默认每 1 秒一次
  checkWatermarkAlignment()(:900)
   └ 自己的 Watermark 超过了 maxAllowedWatermark → 暂停对应的 split(:880,pauseOrResumeSplits)
└ 暂停期间,空闲计时也暂停(:906),不会被误判为空闲(SourceOperator.java 在 RT/streaming/api/operators/,SourceCoordinator.java 在 RT/runtime/source/coordinator/;默认更新间隔见 CORE/api/common/eventtime/WatermarksWithWatermarkAlignment.java:29。)
两点要注意:
- 对齐的单位是 watermark group,同一个 group 里的所有 Source(可以是不同的 Source)一起对齐;
- 按 split 暂停,需要 reader 实现
pauseOrResumeSplits。本篇示例里的 Source 没有实现它,所以没有用这个示例来演示对齐。
这一节只读了代码,没有做实验。
七、一个容易忽略的事实:Watermark 不在 Checkpoint 里
SourceOperator.snapshotState()(SourceOperator.java:661-670)只保存了 reader 的 split 状态:
readerState.update(sourceReader.snapshotState(checkpointId)); // :669WatermarkGenerator 记录的最大时间戳不在 Checkpoint 里。 按代码推断,作业从 Checkpoint 恢复后,每个生成器会重新创建,Watermark 从 Long.MIN_VALUE 开始,直到新数据把它推起来。
这意味着:失败恢复后的一小段时间里,原本会被判为迟到的数据,可能会被正常接收。 同一份输入,有没有发生过 failover,迟到数据的数量可能不一样。
这一节是根据代码推断的,本篇没有专门做"恢复前后 Watermark 变化"的实验。
八、自己动手
示例代码在 flink-notes/demos:
./run.sh study.time.SplitWatermarkDemo split./run.sh study.time.SplitWatermarkDemo operatorSplitWatermarkDemo 里有一个最小的 FLIP-27 Source(不到 150 行):两个 split 都分给 reader 0,reader 交替读,每条数据用 createOutputForSplit 发出。如果你想自己写 Source,可以从这里开始看。
推荐的断点:
| 断点 | 看什么 |
|---|---|
BoundedOutOfOrdernessWatermarks.java:69 | 每个生成器发出的值(写法一会停在两个不同的对象上) |
ProgressiveTimestampsAndWatermarks.java:332 | 多个 split 的合并 |
CombinedWatermarkStatus.java:79 | 取最小值 |
TimestampsAndWatermarksOperator.java:157 | 写法二:上游 Watermark 被丢弃 |
StatusWatermarkValve.java:281 | 下游多个通道的合并 |
AbstractStreamOperator.java:700 | Watermark 推进 Timer |
InternalTimerServiceImpl.java:340 | 每一个被触发的事件时间 Timer |
九、课后练习
- 调大乱序容忍:把写法二的
forBoundedOutOfOrderness改成 6 秒,迟到条数会变成多少?代价是什么? - 加上 idleness:让 slow split 只发 50 条就停止,写法一加上
withIdleness(Duration.ofSeconds(2)),fast 的窗口会怎样?不加呢? - Timer 实验:写一个
KeyedProcessFunction,在processElement里注册一个时间为ctx.timerService().currentWatermark() - 1的事件时间 Timer,验证它不会立即触发,而是在下一个 Watermark 到来时触发(5.2 节结论 1)。 - 思考:为什么 Source 内部合并多个 split、下游合并多个通道,都是取最小值?如果取平均值会怎样?
写在最后
这一讲的核心可以用一句话概括:Watermark 在两个地方取最小值:Source 里多个 split 之间,算子的输入端多个上游之间;一个慢的输入会拖住整体,但不会让数据被误判为迟到。
回到开头:写法一里,每个 split 有自己的生成器,Watermark 跟着慢的 split 走,0 条迟到;写法二里,整个 subtask 只有一个生成器,Watermark 被快的 split 带着跑,慢的 split 的数据有 197 条被判为迟到。
实际使用时的建议:
- Watermark 策略尽量写在
fromSource里,不要在后面再调assignTimestampsAndWatermarks; - 如果必须在中间重新分配 Watermark,要知道上游的 Watermark 和空闲状态都会被丢弃;
- 多个分区进度差别很大时,考虑 Watermark 对齐,而不是一味调大乱序容忍。
下篇我们看窗口:一条数据怎么被分到窗口里?窗口什么时候触发、什么时候清理?迟到数据有哪几种结局?还有一个很多人都踩过的坑:为什么一天的窗口,北京时间早上 8 点才关?
留一个问题:你的作业里,Watermark 策略是写在 fromSource 里,还是用 assignTimestampsAndWatermarks?
下一讲:Flink 2.x 源码精读(七·下):窗口,从分配到触发