
S1 第 8 期:Tag——给数据版本“拍一张快照”
Apache Paimon 源码学习
作者 X老师(DaemonforY),Paimon 2.0 / master 源码,按 CC BY-NC-SA 4.0 发布。配套实验和代码在 GitHub。
TL;DR:Tag 就是把某个快照的 JSON 原样复制一份放到
tag/目录,不复制任何数据。它和快照内容相同,但不会被快照过期清理,所以能长期保留一个数据版本。Tag 可以设保留时间(到期后在下一次提交时删除),可以用rollback_to把表回滚到它,也可以按批作业或按天自动创建。三个容易踩的坑:回滚会删掉更新的 Tag 且不删数据文件;按天自动创建的第一个 Tag 叫昨天的日期;自动 Tag 是“周期结束后第一次提交”时的整表状态,不会按时间切数据。
实验准备
一张主键表,三次提交:
CREATE TABLE tg (
  order_id BIGINT,
  status   STRING,
  PRIMARY KEY (order_id) NOT ENFORCED
) WITH ('bucket' = '1');

INSERT INTO tg VALUES (1, 'CREATED'), (2, 'CREATED');   -- 快照 1
INSERT INTO tg VALUES (1, 'PAID');                      -- 快照 2
INSERT INTO tg VALUES (3, 'CREATED');                   -- 快照 3
完整 SQL 在仓库
labs/sql/lab02/tag-basics.sql,一条命令复现:cd labs && ./run.sh sql/lab02/tag-basics.sql
打一个 Tag
CALL sys.create_tag(`table` => 'default.tg', tag => 'v1', snapshot_id => 1);   -- 指定快照
CALL sys.create_tag(`table` => 'default.tg', tag => 'release');                -- 不指定:最新快照
| tag_name | snapshot_id | commit_time | record_count | create_time | time_retained |
| release | 3 | 2026-10-04 20:57:02.846 | 4 | <NULL> | <NULL> |
| v1 | 1 | 2026-10-04 20:57:01.475 | 2 | <NULL> | <NULL> |按 Tag 读,和按快照号读一样简单:
SELECT * FROM tg /*+ OPTIONS('scan.tag-name' = 'v1') */; -- 订单 1、2,都是 CREATEDTag 到底是什么?一个快照 JSON 的拷贝
去表目录看一眼:
$ ls tag/
tag-release
tag-v1

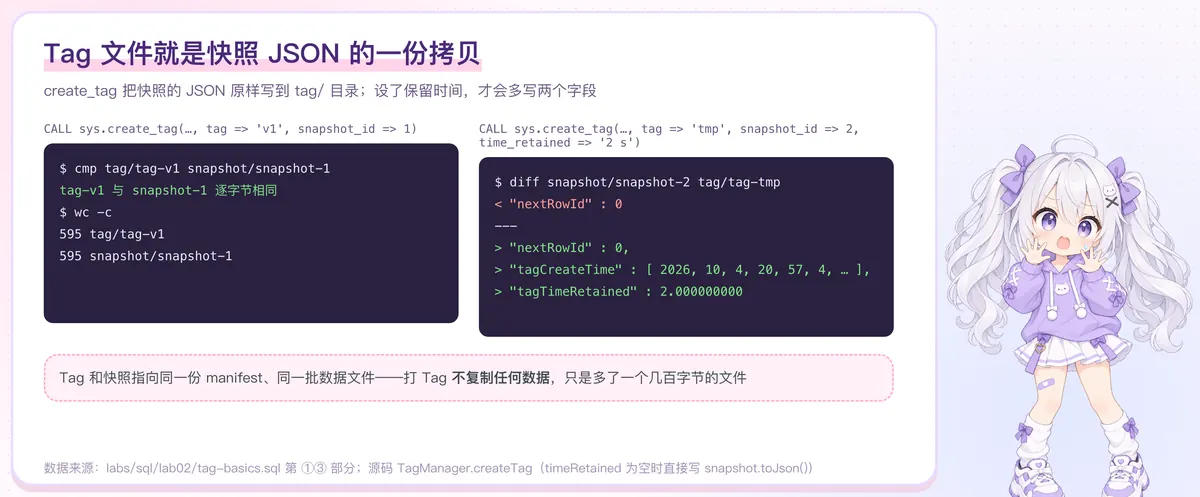
$ cmp tag/tag-v1 snapshot/snapshot-1 && echo 'tag-v1 与 snapshot-1 逐字节相同'
tag-v1 与 snapshot-1 逐字节相同

$ wc -c tag/tag-v1 snapshot/snapshot-1
     595 tag/tag-v1
     595 snapshot/snapshot-1
两个文件逐字节相同。 源码 TagManager.createTag 里写得很直白:没有设保留时间时,Tag 文件的内容就是 snapshot.toJson()。
第 6 期讲过,快照只是一张“文件清单”。Tag 复制的也只是这张清单,指向的还是同一批 manifest 和数据文件,所以打 Tag 不复制任何数据,代价只是一个几百字节的文件。
快照 vs Tag:内容一样,命运不同
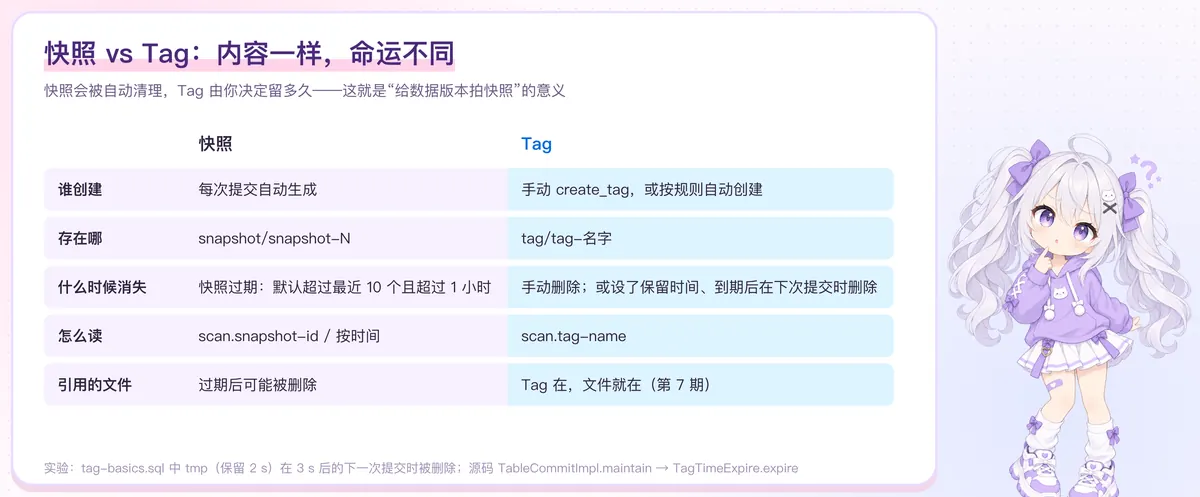
既然内容一样,Tag 有什么用?区别在“谁来决定它什么时候消失”:
- 快照每次提交自动生成,默认超过最近 10 个、又超过 1 小时就会被过期清理(第 6、7 期);
- Tag 由你创建、由你删除。快照过期不会动它,它引用的数据文件也就不会被删(第 7 期的实验:快照 1 过期后按快照号读不到,按 Tag 读 5 行全在)。
所以 Tag 适合“这个版本我要留很久”的场景:上线前的版本、月末对账的数据、给下游的固定数据集。
给 Tag 设保留时间
长期保留的 Tag 越多,能删的旧文件越少(第 7 期)。所以 Tag 也可以设保留时间:
CALL sys.create_tag(`table` => 'default.tg', tag => 'tmp', snapshot_id => 2, time_retained => '2 s');这时 Tag 文件就不再和快照完全一样了,多了两个字段:
$ diff snapshot/snapshot-2 tag/tag-tmp
<   "nextRowId" : 0
---
>   "nextRowId" : 0,
>   "tagCreateTime" : [ 2026, 10, 4, 20, 57, 4, 373761000 ],
>   "tagTimeRetained" : 2.000000000
等 3 秒,再提交一次,tmp 就从 $tags 里消失了。注意是下一次提交时才删:Tag 过期和快照过期一样,都在提交后的维护阶段执行(TableCommitImpl.maintain → TagTimeExpire.expire),没有提交就没有人去删它。
想给所有新 Tag 一个默认保留时间,可以设表参数 tag.default-time-retained。
回滚到 Tag:坑一,更新的 Tag 也没了
数据写坏了?可以把整张表回滚到某个 Tag:
CALL sys.rollback_to(`table` => 'default.tg', tag => 'v1');
-- 返回 (previous_snapshot_id, current_snapshot_id) = (4, 1)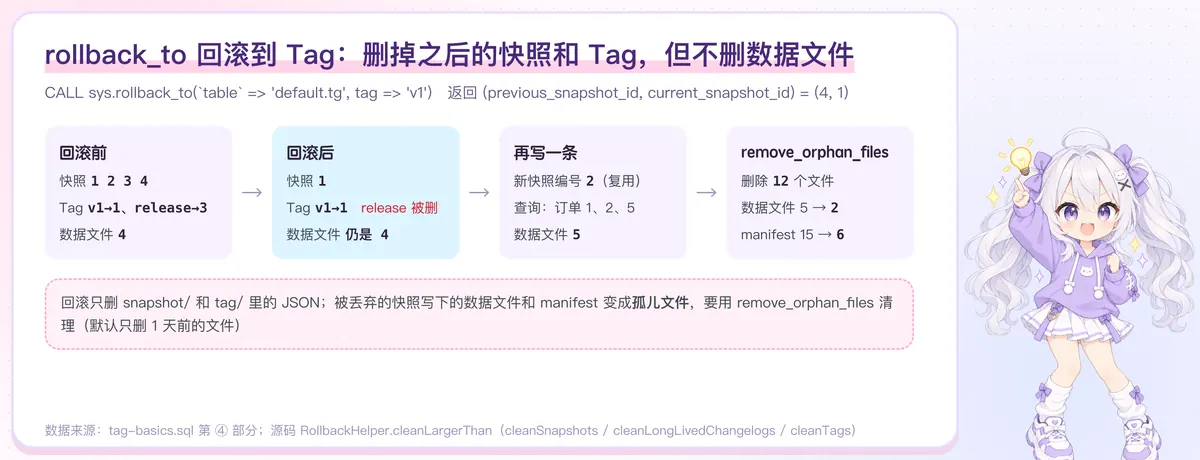
回滚前后对比:
| 回滚前 | 回滚后 | |
|---|---|---|
| 快照 | 1、2、3、4 | 只剩 1 |
| Tag | v1 → 1、release → 3 | 只剩 v1,release 被删了 |
| 查询结果 | 订单 1~4 | 订单 1、2(CREATED) |
| 数据文件 | 4 个 | 还是 4 个 |
两件事要注意:
- 比目标更新的 Tag 会被一起删掉。源码
RollbackHelper.cleanLargerThan依次执行cleanSnapshots、cleanLongLivedChangelogs、cleanTags,删掉所有比目标快照更新的快照和 Tag。实验里指向快照 3 的release就这样没了——如果它是你的“上线版本”,回滚前一定要想清楚。 - 数据文件一个都没删。回滚只删了
snapshot/和tag/里的 JSON,被丢弃的快照写下的数据文件和 manifest 还躺在磁盘上,没有任何快照引用它们,成了孤儿文件。
回滚后继续写入,新快照的编号是 2——编号被复用了,但它和回滚前的快照 2 是完全不同的内容。
孤儿文件要用 remove_orphan_files 清理:
CALL sys.remove_orphan_files(`table` => 'default.tg', older_than => '2026-10-04 20:57:13', dry_run => true);
CALL sys.remove_orphan_files(`table` => 'default.tg', older_than => '2026-10-04 20:57:13');
-- 返回:删除 12 个文件,共 16561 字节
12 个文件 = 3 个数据文件(5 → 2)+ 9 个 manifest 相关文件(manifest/ 目录 15 → 6)。older_than 默认是 1 天前,实验里为了马上看到效果用了当前时间;生产上不要把它设得太近,否则可能误删正在写入、还没提交的文件。
自动打 Tag:坑二和坑三
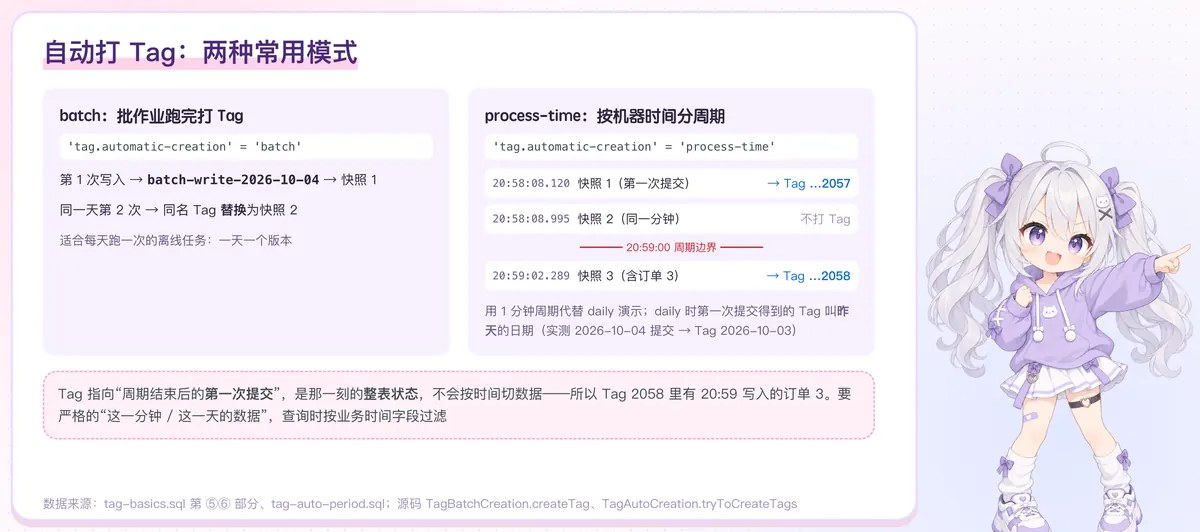
手动打 Tag 容易忘,Paimon 支持自动创建(tag.automatic-creation)。最常用的两种:
batch 模式:批作业跑完打 Tag
'tag.automatic-creation' = 'batch'每次批作业结束,为最新快照打一个 batch-write-日期 的 Tag。实验里第一次写入得到 batch-write-2026-10-04 → 快照 1;同一天再跑一次,同名 Tag 被替换为快照 2(TagBatchCreation.createTag 先删同名 Tag 再创建)。适合每天跑一次的离线任务:一天一个版本,最后一次运行为准。
process-time 模式:按机器时间分周期
'tag.automatic-creation' = 'process-time',
'tag.creation-period'    = 'daily'
实验结果有点出人意料:2026-10-04 晚上第一次提交,立刻生成了一个叫 2026-10-03 的 Tag,指向这次提交的快照 1。
这就是坑二:第一次提交时,Paimon 会为“上一个周期”打一个 Tag(TagAutoCreation.tryToCreateTags:首次运行时取 normalizeToPreviousTag(当前时间)),所以第一个 Tag 的名字是昨天,内容却是今天这次提交的数据。
按天的周期要等一天才能看到下一个 Tag,实验用 1 分钟的周期代替('tag.creation-period-duration' = '1 min',规则相同,见 labs/sql/lab02/tag-auto-period.sql):
| 提交时间 | 快照 | Tag |
|---|---|---|
| 20:58:08.120 | 1(第一次提交) | 202610042057 → 快照 1 |
| 20:58:08.995 | 2(同一分钟内) | 不打 |
| —— 20:59:00 周期边界 —— | ||
| 20:59:02.289 | 3(写入订单 3) | 202610042058 → 快照 3 |
坑三就在最后一行:20:58 这个 Tag 指向的是 20:59:02 提交的快照 3,读出来有订单 3——一条在 20:59 才写入的数据。因为 Tag 打在“周期结束后的第一次提交”上,是那一刻的整表状态,不会按时间把数据切开。换成按天就是:2026-10-04 这个 Tag,可能包含 10 月 5 日零点之后写入的数据。
要严格的“某一天的数据”,查询时还是要按业务时间字段过滤;tag.creation-delay 只是让 Tag 晚一点打、等迟到的数据进来,并不能把新数据挡在外面。
自动创建的 Tag 可以用 tag.num-retained-max 限制数量,超过的最老的自动 Tag 会被删除(只影响自动创建的 Tag)。
生产启示
- 重要版本用 Tag 留住,而不是调大快照保留:Tag 只钉住一个版本,调大
snapshot.time-retained会钉住所有版本的旧文件。 - Tag 也要有生命周期:用
time_retained/tag.default-time-retained/tag.num-retained-max,否则 Tag 越积越多,旧文件永远删不掉。 - 回滚前先看
$tags:比目标更新的 Tag 会被删除;回滚后记得择机跑remove_orphan_files。 - 自动 Tag 不等于按天切分的数据:它是某次提交时的整表状态,严格按天统计仍要用业务时间过滤。
S1 收官:从第 1 期跑通 Paimon,到第 8 期的 Tag,我们把“表目录里的每个文件是什么、什么时候生成、什么时候删除”完整走了一遍。下一季进入源码:一条数据的写入之旅。
自测题:在 rollback_to v1 之前,如果先对 release 这个 Tag 跑一次 create_tag 的备份(比如 CALL sys.create_tag(..., tag => 'release_bak', snapshot_id => 3)),回滚之后它还在吗?(答案:不在。cleanTags 删除的是所有指向“比目标更新的快照”的 Tag,不看名字;想保住快照 3 的数据,回滚前要先把它导出或用分支(branch)保存。)